hive数据导入时缺失值如何处理
作者:袖梨
2026-06-04
在Hive中,导入数据时处理缺失值有多种方法。以下是一些建议:

使用默认值填充缺失值:
在加载数据到Hive表时,可以使用
IFNULL函数为缺失值提供默认值。例如:INSERT [OVERWRITE] TABLE target_tableSELECTcolumn1,IFNULL(column2, 'default_value') AS column2,...FROMsource_table;这将使用
default_value替换source_table中column2的缺失值。使用
COALESCE函数填充缺失值:COALESCE函数允许您指定多个默认值,并在找到第一个非空值时返回它。例如:INSERT [OVERWRITE] TABLE target_tableSELECTcolumn1,COALESCE(column2, column3, 'default_value') AS column2,...FROMsource_table;如果
column2为空,则此查询将使用column3的值,如果column3也为空,则使用default_value。在数据加载之前处理缺失值:
您可以在将数据加载到Hive之前使用ETL工具(如Apache NiFi、Apache Spark等)或编程语言(如Python、Java等)处理缺失值。例如,在Python中,您可以使用Pandas库处理缺失值:
import pandas as pd# 读取源数据data = pd.read_csv('source_table.csv')# 处理缺失值data['column2'].fillna('default_value', inplace=True)# 将处理后的数据保存到Hivedata.to_sql('target_table', engine, if_exists='overwrite', index=False)使用Hive的
na函数处理缺失值:Hive提供了一个名为
na的内置函数,可以用于识别和处理缺失值。例如,您可以使用以下查询查找包含缺失值的行:SELECT * FROM target_table WHERE na(column2);要删除包含缺失值的行,可以使用
FILTER子句:INSERT [OVERWRITE] TABLE target_tableSELECT * FROM source_tableFILTER NOT (na(column2) OR na(column3));
这些方法可以帮助您在Hive中处理导入数据时的缺失值。您可以根据具体需求和数据情况选择合适的方法。
相关文章
-
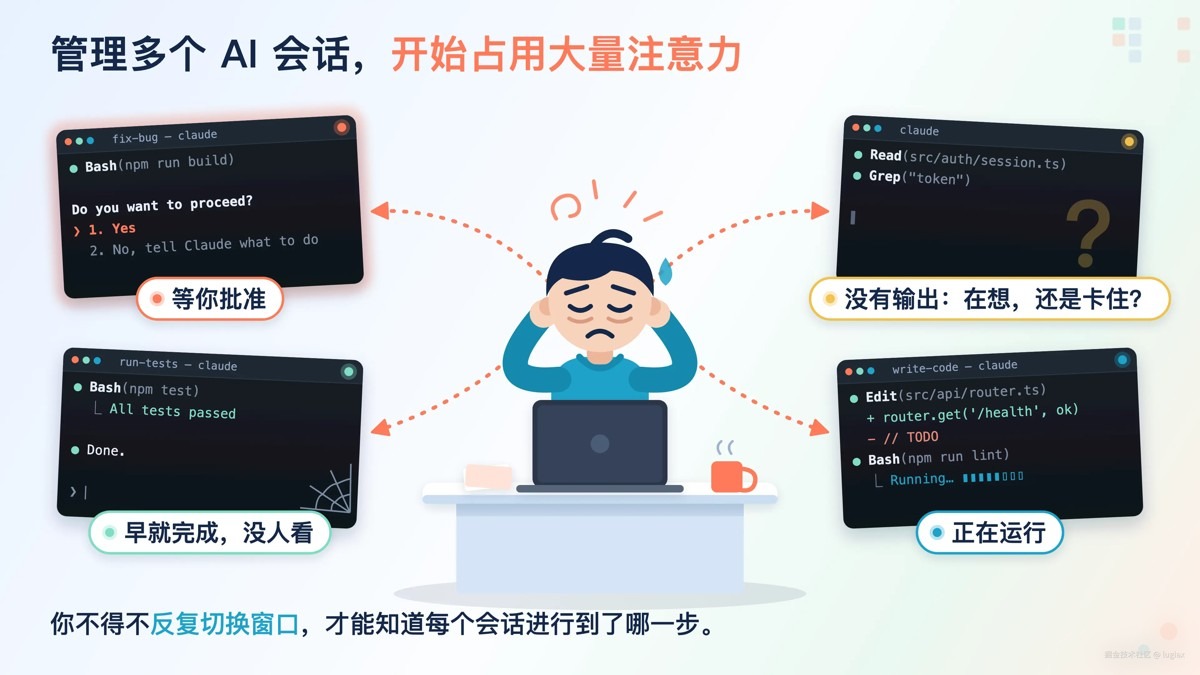
同时开多个Claude Code怎么管理?一文分享五大Claude Code多会话管理方案实用指南
游戏攻略 2026-10-12
-
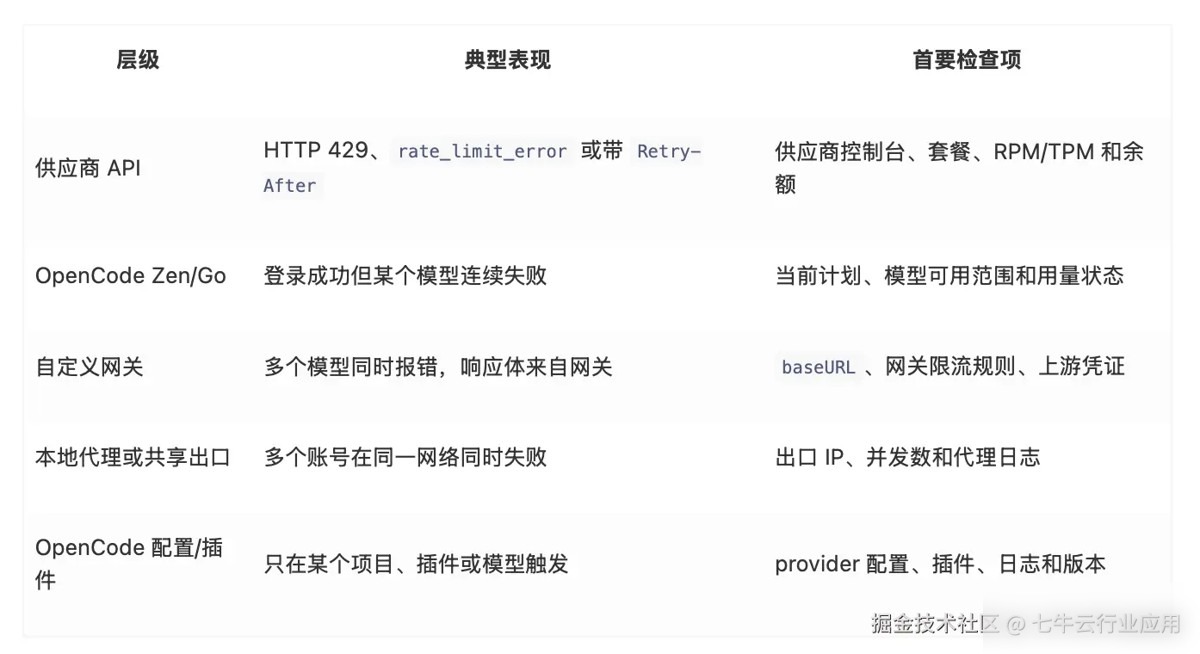
OpenCode报错Rate limit exceeded:限流原因、日志定位与修复步骤实用指南
游戏攻略 2026-10-12
-
OpenClaw千帆模型切换:精准配置步骤与关键命令完整指南
游戏攻略 2026-10-11
-
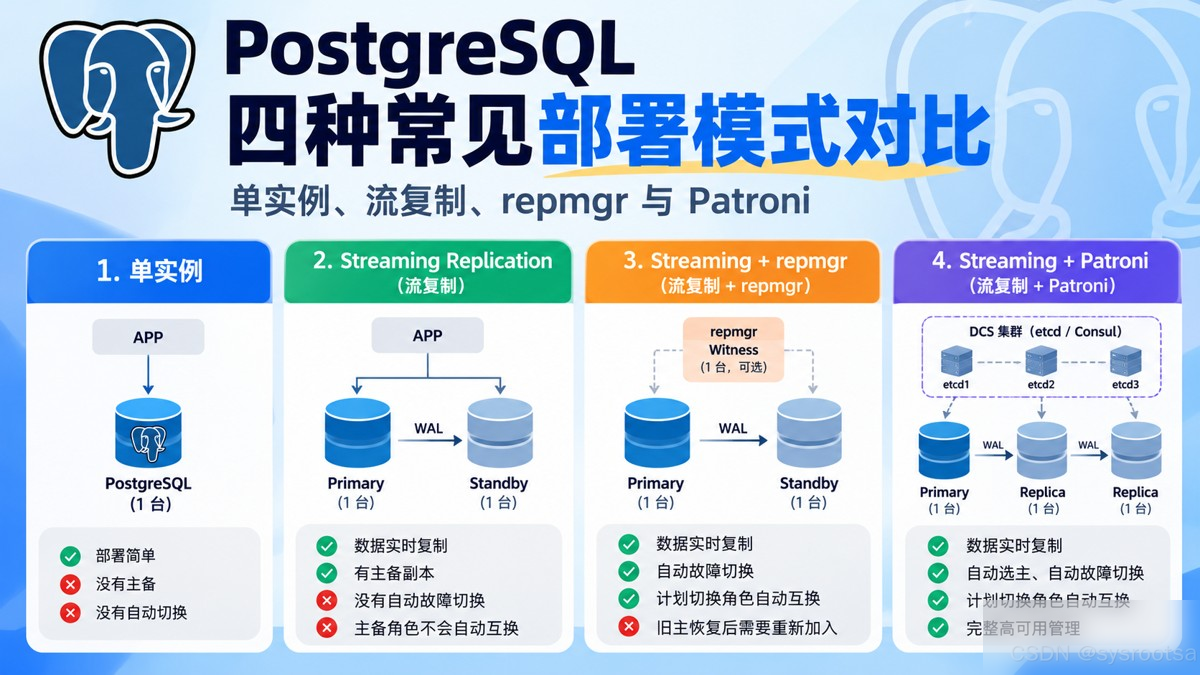
PostgreSQL四种常见部署模式对比完整指南
游戏攻略 2026-10-11
-
DeepSeek Harness第三方模型配置实践教程:桌面端、网页端与兼容接口实测实用指南
游戏攻略 2026-10-11
-
OpenClaw阿里云部署实践指南:从服务器搭建到QQ端接入使用实用指南
游戏攻略 2026-10-11