hive导入数据时怎样选择合适的分区
作者:袖梨
2026-06-04
在Hive中,导入数据时选择合适的分区可以显著提高查询性能和数据管理的效率。以下是一些选择合适分区的建议:

基于数据访问模式:
- 时间分区:如果经常根据时间范围查询数据(例如,按天、周或月),则按时间字段分区是个好主意。这样,查询只需要扫描相关的分区,而不是整个表。
- 频率分区:如果某些字段值的查询频率远高于其他值,可以根据这些字段进行分区。
- 地理分区:对于地理上分布的数据,按地理位置分区可以减少查询时需要扫描的数据量。
基于数据大小:
- 如果数据量非常大,可以考虑按数据量大小进行分区,例如按文件大小或行数。这样可以避免单个分区过大,从而提高查询性能和管理效率。
基于业务逻辑:
- 根据业务逻辑和查询模式来选择分区键。例如,如果某些业务操作只涉及特定的数据子集,可以根据这些操作来分区。
避免过度分区:
- 分区过多会增加管理的复杂性,并可能导致查询性能下降(因为过多的分区需要扫描)。通常建议每个分区的数据量在几百万到几千万行之间。
考虑数据倾斜:
- 数据倾斜是指某些分区包含的数据量远大于其他分区。这可能导致查询性能下降。在选择分区键时,要尽量避免这种情况。
使用复合分区键:
- 如果单个字段无法充分描述数据的分布,可以考虑使用复合分区键。复合分区键可以根据多个字段进行分区,从而更精细地控制数据的分布。
测试和优化:
- 在实际应用之前,对不同的分区策略进行测试,以确定哪种策略最适合您的数据和查询模式。根据测试结果进行优化。
在选择分区时,还需要考虑Hive的版本和配置,因为不同版本和配置可能对分区的行为和支持有所不同。此外,还要确保分区键的选择不会导致数据冗余或丢失,并且要考虑到未来的数据增长和变化。
相关文章
-
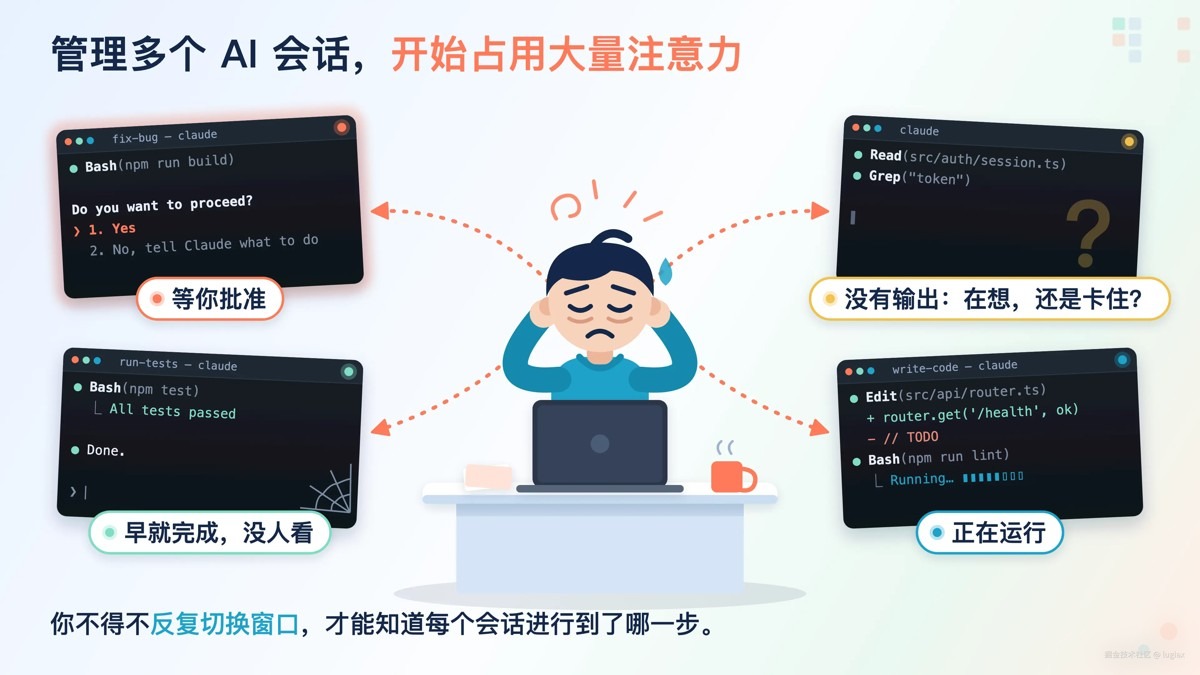
同时开多个Claude Code怎么管理?一文分享五大Claude Code多会话管理方案实用指南
游戏攻略 2026-10-12
-
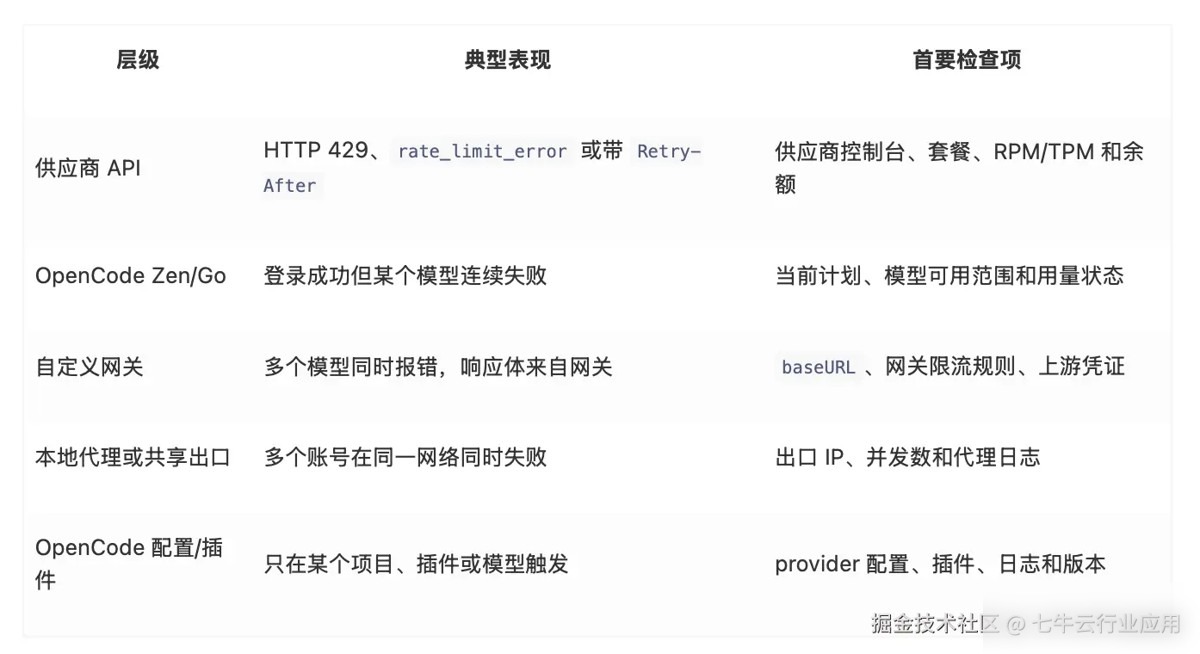
OpenCode报错Rate limit exceeded:限流原因、日志定位与修复步骤实用指南
游戏攻略 2026-10-12
-
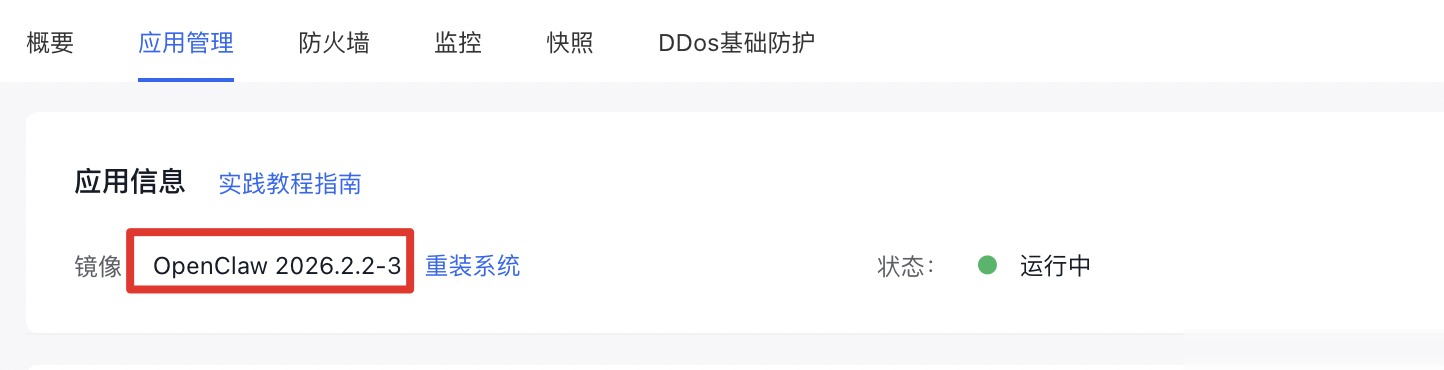
OpenClaw千帆模型切换:精准配置步骤与关键命令完整指南
游戏攻略 2026-10-11
-
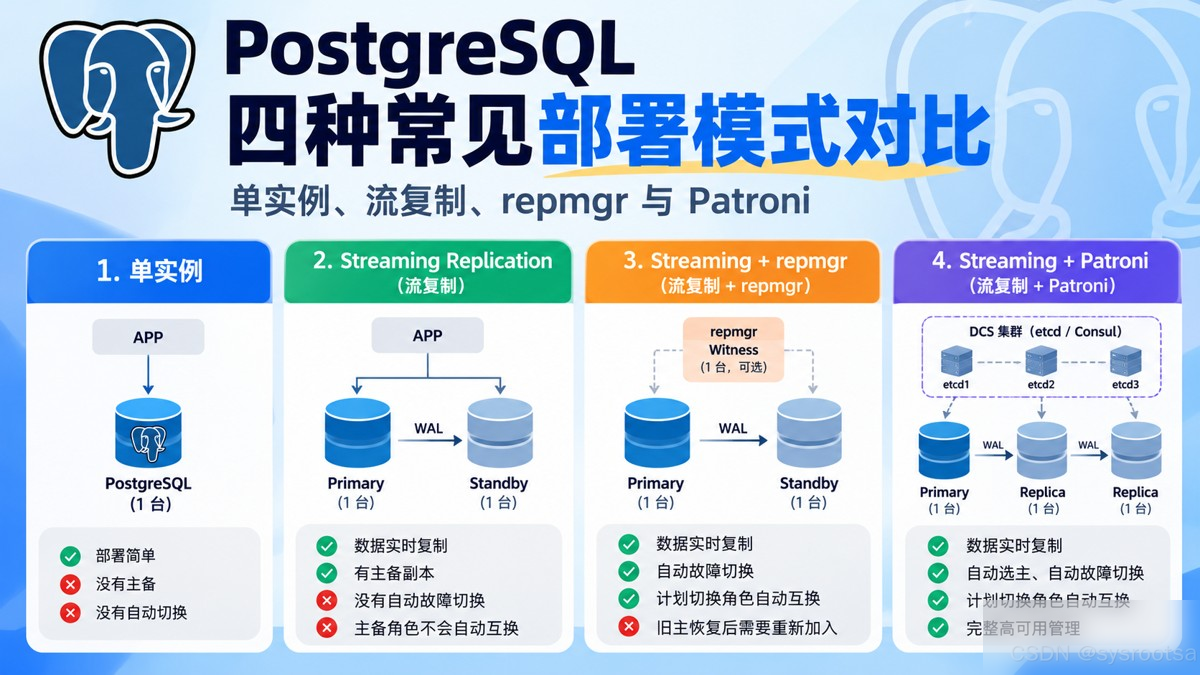
PostgreSQL四种常见部署模式对比完整指南
游戏攻略 2026-10-11
-
DeepSeek Harness第三方模型配置实践教程:桌面端、网页端与兼容接口实测实用指南
游戏攻略 2026-10-11
-
OpenClaw阿里云部署实践指南:从服务器搭建到QQ端接入使用实用指南
游戏攻略 2026-10-11