hive数据导出有哪些技巧
作者:袖梨
2026-06-04
Hive是一个基于Hadoop构建的数据仓库工具,它允许用户使用类似于SQL的查询语言(HiveQL)来处理存储在HDFS中的大规模数据集。以下是关于Hive导出数据的相关信息:

Hive导出数据的方法
- 使用INSERT OVERWRITE语句:可以将数据导出到本地文件或HDFS文件系统中。例如,使用
INSERT OVERWRITE DIRECTORY '/path/to/output' ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' SELECT * FROM sales_data;可以将sales_data表的数据导出为CSV格式并保存到HDFS的指定路径中。 - 使用INSERT INTO语句:可以将数据导出到外部数据存储系统,如HBase、MySQL等。
- 使用Hive的导出工具:如
hive -e "select * from table" output.txt命令可以将查询结果导出到本地文件中。 - 使用Sqoop工具:Sqoop是一个用于在Hadoop和关系型数据库之间传输数据的工具,也可以用于Hive数据的导出。
导出数据的技巧
- 在导出大量数据时,考虑使用
INSERT OVERWRITE语句,并指定合适的分隔符,以便于后续的数据处理和分析。 - 如果数据量不是特别巨大,可以使用Hive的查询语句直接导出,但需要注意MapReduce作业启动时的性能开销。
- 对于需要进一步在Hadoop生态内处理的数据,导出到HDFS可能是更好的选择,因为HDFS提供了高吞吐量的数据访问和存储能力。
通过上述方法,您可以根据具体的需求和场景选择合适的Hive数据导出方式,从而有效地处理和迁移数据。
相关文章
-
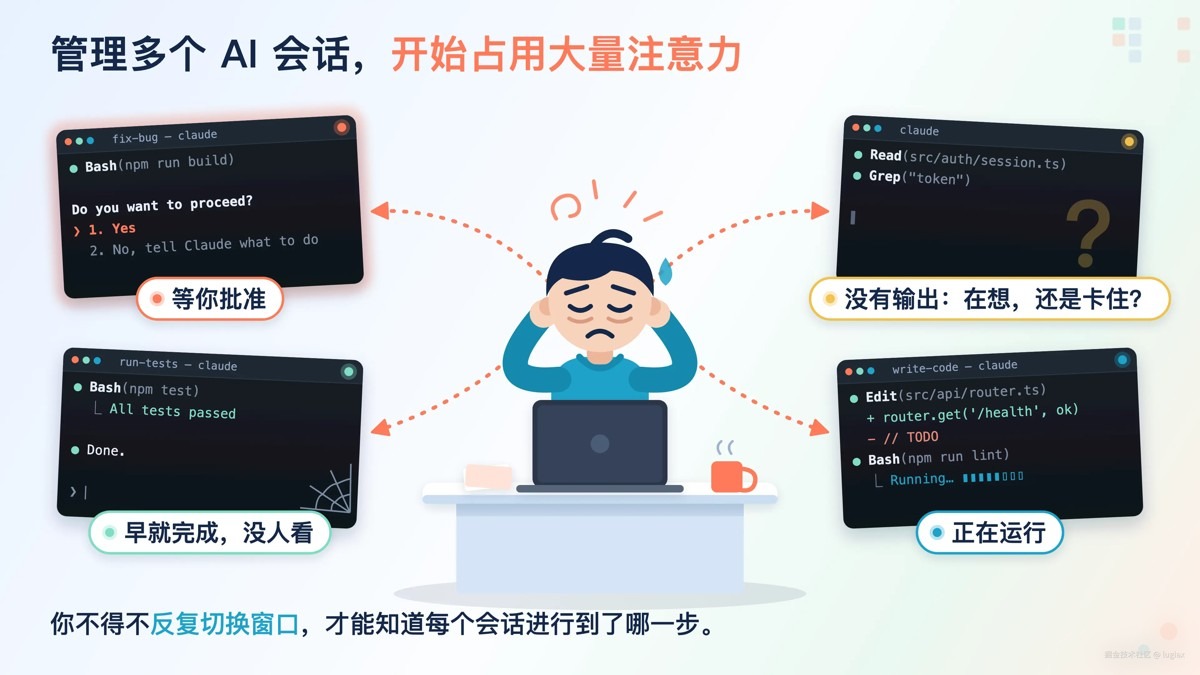
同时开多个Claude Code怎么管理?一文分享五大Claude Code多会话管理方案实用指南
游戏攻略 2026-10-12
-
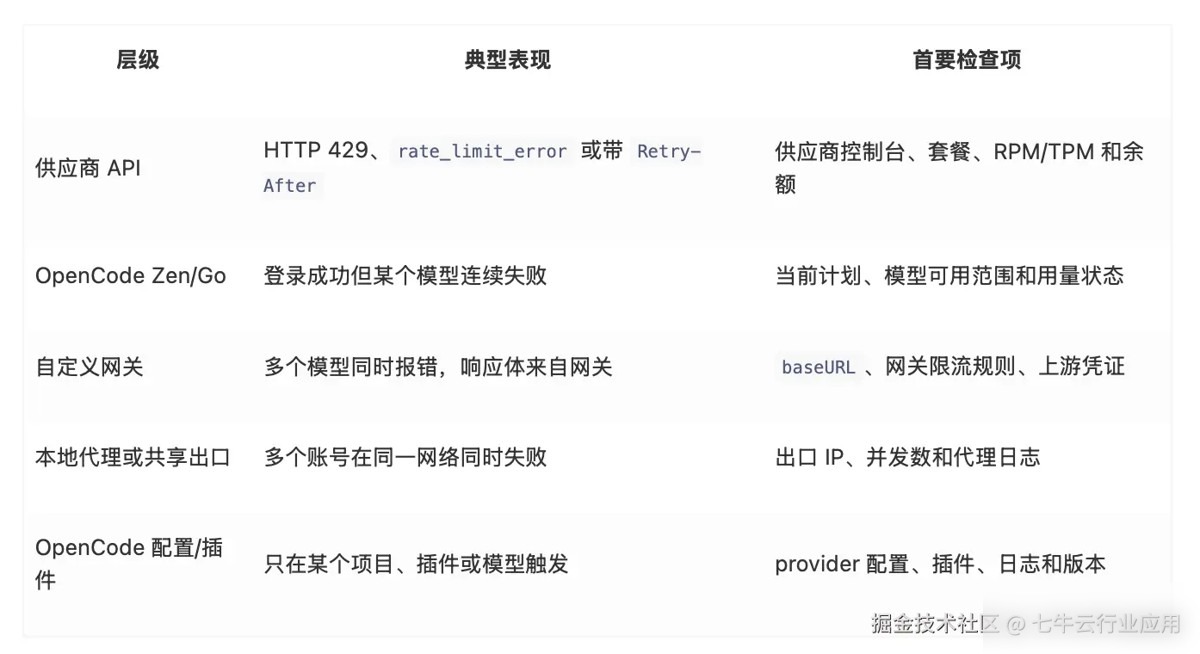
OpenCode报错Rate limit exceeded:限流原因、日志定位与修复步骤实用指南
游戏攻略 2026-10-12
-
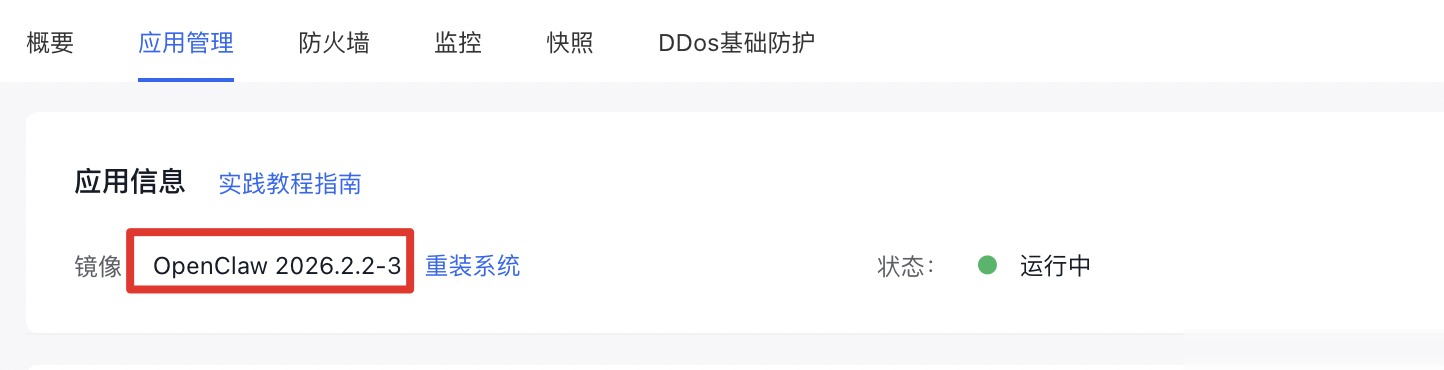
OpenClaw千帆模型切换:精准配置步骤与关键命令完整指南
游戏攻略 2026-10-11
-
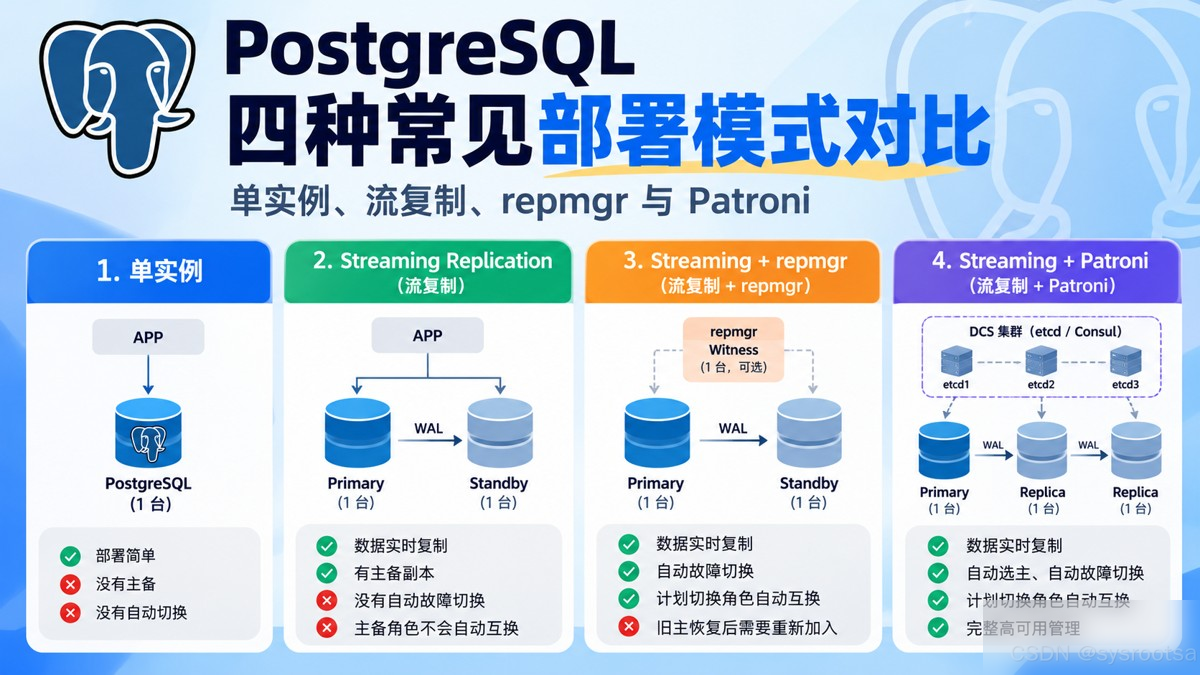
PostgreSQL四种常见部署模式对比完整指南
游戏攻略 2026-10-11
-
DeepSeek Harness第三方模型配置实践教程:桌面端、网页端与兼容接口实测实用指南
游戏攻略 2026-10-11
-
OpenClaw阿里云部署实践指南:从服务器搭建到QQ端接入使用实用指南
游戏攻略 2026-10-11