hive hash函数能用来去重数据吗
作者:袖梨
2026-06-06
Hive中的hash函数确实可以用于数据去重,但它并不是专门设计用来去重的。Hive的hash函数主要用于计算记录或字段的哈希值,以便在分布式环境中进行数据的分区和负载均衡。

如果你想要使用hash函数来去重,你可以对需要去重的字段应用hash函数,然后将结果作为分区的依据。这样,具有相同哈希值的记录将被分配到同一个分区中,从而实现数据的去重。
然而,需要注意的是,hash函数并不能保证100%的去重效果。在某些情况下,具有不同值的记录可能会被分配到同一个分区中。因此,在使用hash函数进行数据去重时,你还需要结合其他方法(如使用唯一键约束、检查重复记录等)来确保数据的准确性。
另外,Hive本身并没有提供专门用于去重的函数或操作。如果你需要去重数据,你可能需要编写自定义的MapReduce作业或使用其他工具(如Apache Pig)来实现。
总的来说,虽然Hive的hash函数可以用于数据去重,但它并不是专门设计用来去重的,你可能需要结合其他方法来确保数据的准确性。
相关文章
-
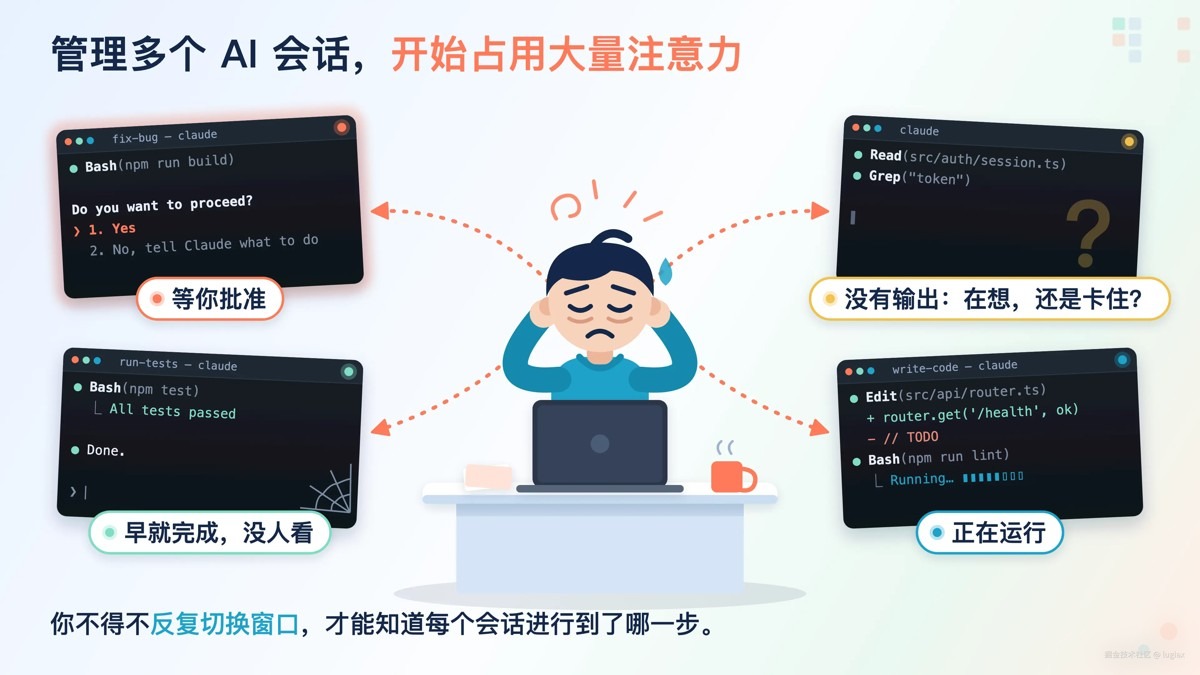
同时开多个Claude Code怎么管理?一文分享五大Claude Code多会话管理方案实用指南
游戏攻略 2026-10-12
-
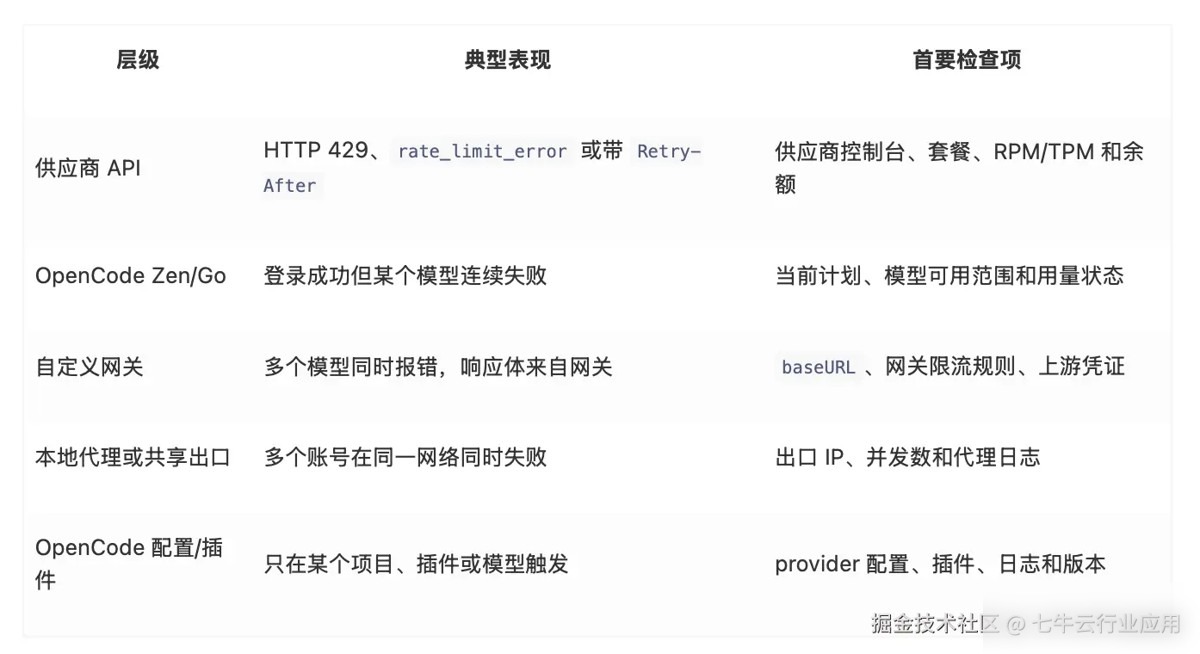
OpenCode报错Rate limit exceeded:限流原因、日志定位与修复步骤实用指南
游戏攻略 2026-10-12
-
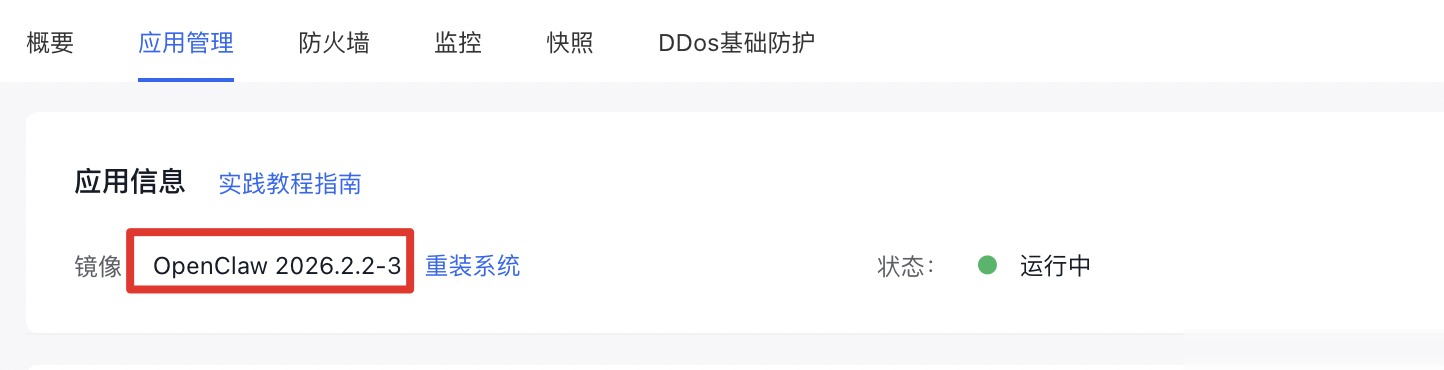
OpenClaw千帆模型切换:精准配置步骤与关键命令完整指南
游戏攻略 2026-10-11
-
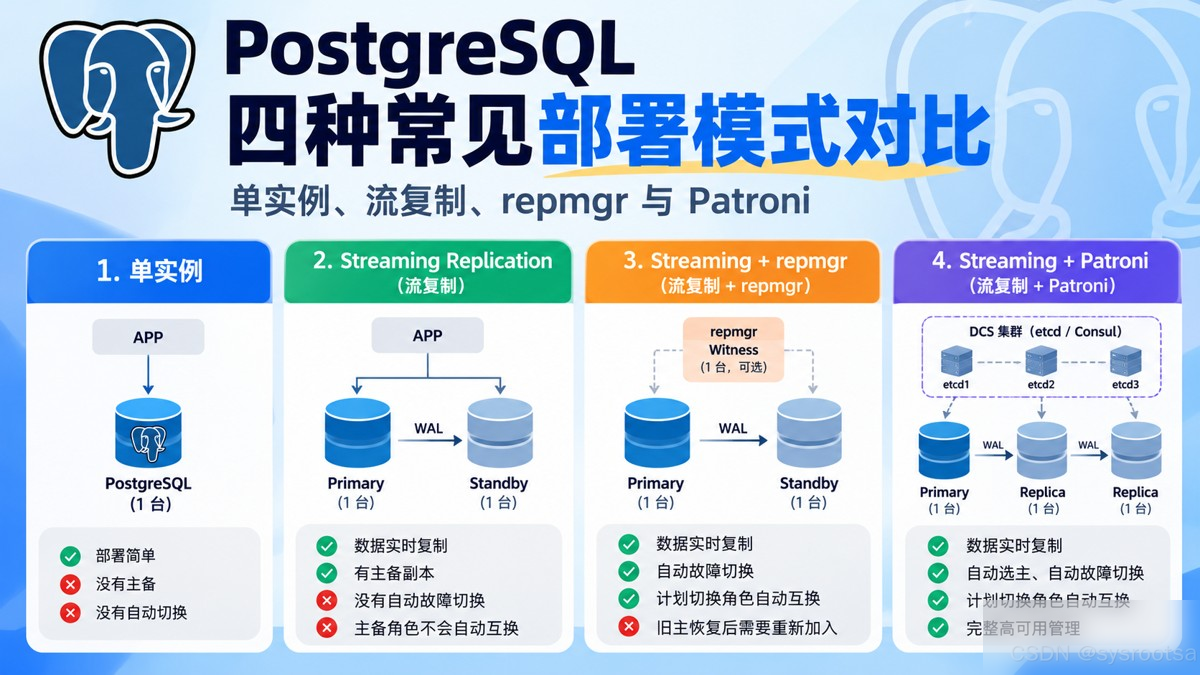
PostgreSQL四种常见部署模式对比完整指南
游戏攻略 2026-10-11
-
DeepSeek Harness第三方模型配置实践教程:桌面端、网页端与兼容接口实测实用指南
游戏攻略 2026-10-11
-
OpenClaw阿里云部署实践指南:从服务器搭建到QQ端接入使用实用指南
游戏攻略 2026-10-11