hive mapper在数据仓库中怎样应用
作者:袖梨
2026-06-06
Hive中的Mapper是MapReduce计算框架中的一个重要组成部分,它主要负责对输入数据进行初步的处理。在Hive中,Mapper的工作流程主要包括Map阶段的初始化和执行、数据的溢写、Combiner阶段的合并以及Partitioner阶段的分区。以下是关于Hive中Mapper的应用及实现步骤的详细介绍:
Hive中Mapper的应用场景
- 数据分析:对存储在Hadoop集群中的数据进行查询、聚合、过滤等操作。
- 日志处理:处理大规模的日志数据,如Web日志、应用程序日志等,快速了解用户行为、应用程序运行情况等信息。
- 商业智能:与商业智能工具集成,生成数据报表、数据可视化等功能,支持决策和管理。
- 数据挖掘:与机器学习工具集成,进行数据挖掘和机器学习分析,发现数据中的模式和趋势。
Hive中Mapper的实现步骤
- 创建Hive表:定义一个包含Map类型字段的Hive表,使用
ROW FORMAT DELIMITED FIELDS TERMINATED BY指定行格式和字段分隔符,以及STORED AS指定数据存储格式。 - 插入数据:向创建的Hive表中插入包含Map数据的示例数据,使用
INSERT INTO语句。 - 查询数据:使用Hive查询语言(HiveQL)提取Map的所有键值对,例如使用
explode函数展开Map类型字段。
通过上述步骤,用户可以在Hive中有效地利用Mapper进行数据处理和分析。需要注意的是,具体的实现可能会根据实际的数据类型和业务需求有所不同。
相关文章
-
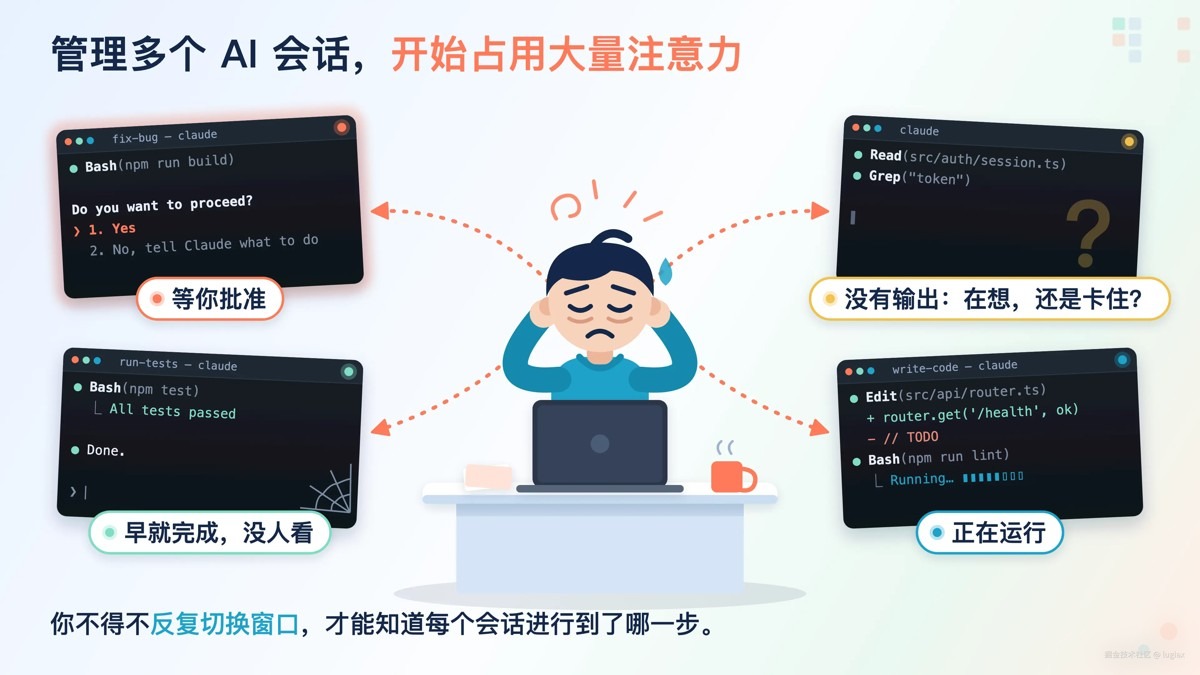
同时开多个Claude Code怎么管理?一文分享五大Claude Code多会话管理方案实用指南
游戏攻略 2026-10-12
-
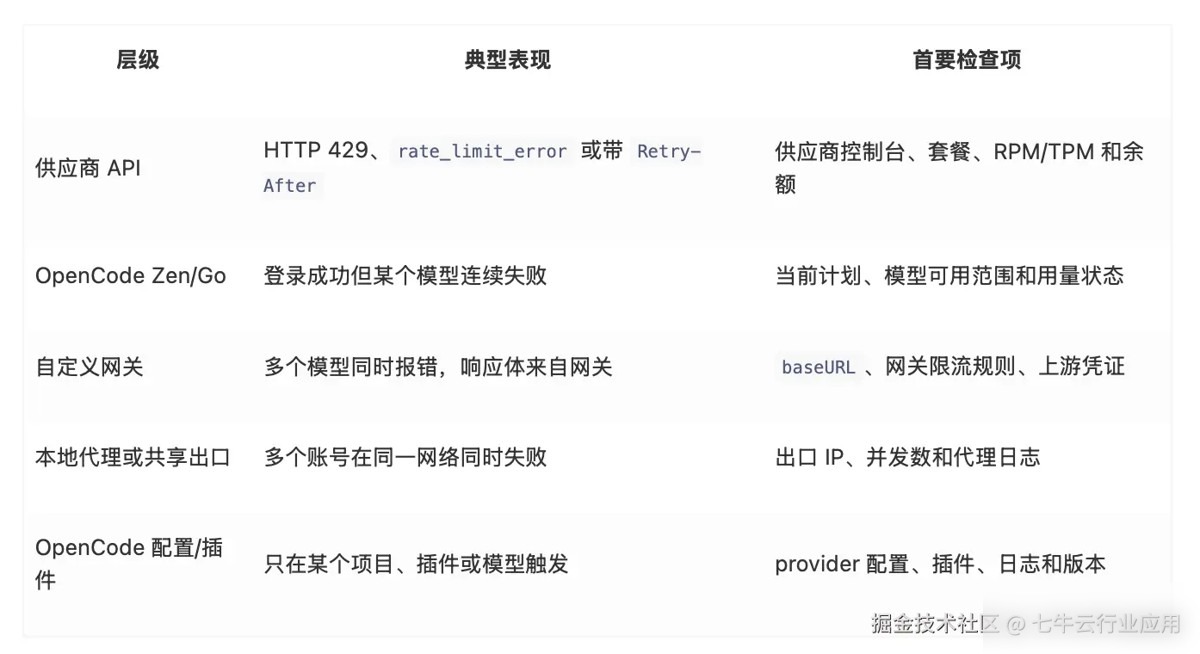
OpenCode报错Rate limit exceeded:限流原因、日志定位与修复步骤实用指南
游戏攻略 2026-10-12
-
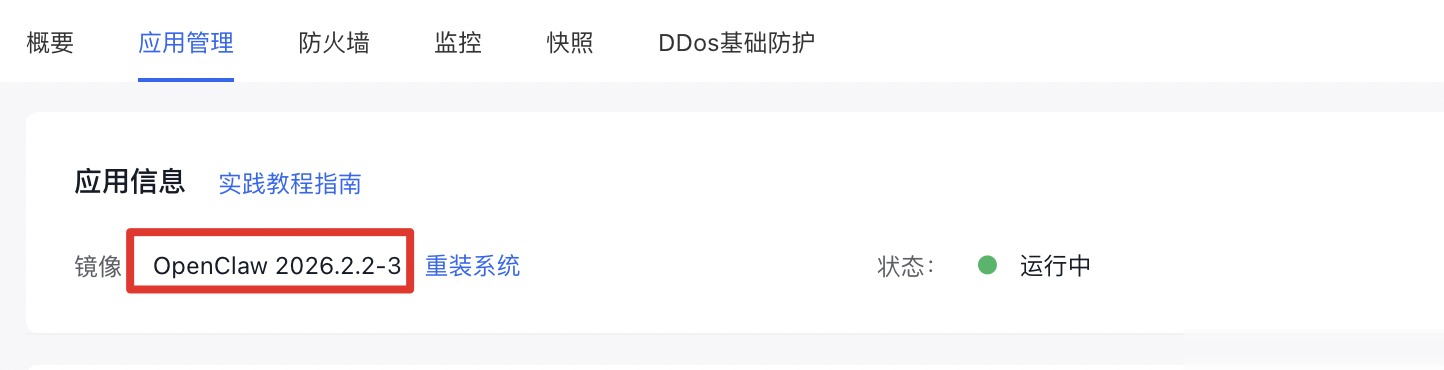
OpenClaw千帆模型切换:精准配置步骤与关键命令完整指南
游戏攻略 2026-10-11
-
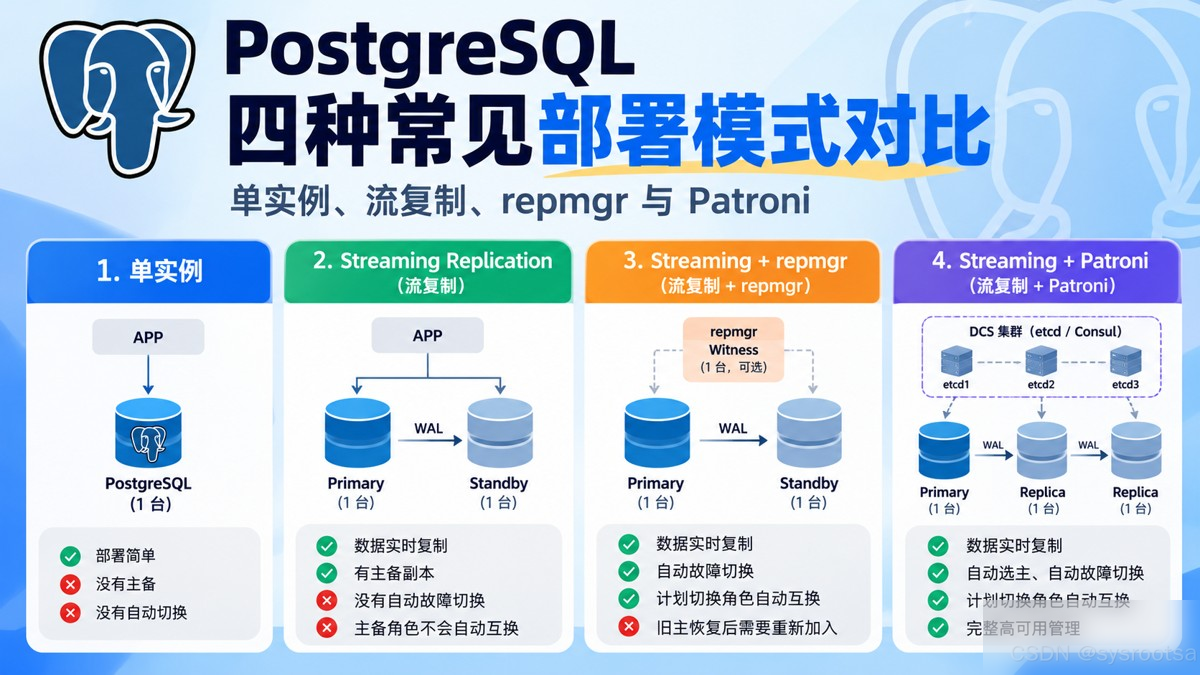
PostgreSQL四种常见部署模式对比完整指南
游戏攻略 2026-10-11
-
DeepSeek Harness第三方模型配置实践教程:桌面端、网页端与兼容接口实测实用指南
游戏攻略 2026-10-11
-
OpenClaw阿里云部署实践指南:从服务器搭建到QQ端接入使用实用指南
游戏攻略 2026-10-11