hive moderation如何应对海量数据
作者:袖梨
2026-06-06
Hive 是一个基于 Hadoop 的开源数据仓库工具,主要用于处理和管理海量结构化数据。当谈到 “moderation” 时,这可能指的是数据审核或内容过滤,这在大数据处理中是一个重要环节,尤其是在社交媒体或内容平台上。然而,Hive 本身并不直接提供内容审核或过滤的功能,这通常由专门的内容管理系统 (CMS) 或安全工具来完成。但 Hive 可以用来存储和处理这些系统生成的数据,以便进一步分析。

Hive 在海量数据处理中的应用场景
- 数据仓库管理:Hive 允许企业高效地组织、存储和管理海量数据。
- 批处理数据分析:适用于需要处理大量数据且不要求实时响应的场景。
- 大规模数据集查询:HiveQL 支持复杂的查询操作,适用于大规模数据集的分析。
高效管理和分析大数据的策略
- 数据分区:通过将数据分区,可以减少查询的数据范围,提高查询性能。
- 数据压缩:减少数据的存储空间,提高查询性能。
- 数据桶:提高数据的查询效率。
- 并行执行:使用 Tez 或 Spark 等并行执行框架进行查询任务的并行处理。
- 数据分析优化:避免全表扫描,使用 JOIN 优化等。
Hive 与其他大数据处理工具的结合
Hive 常与 Hadoop 生态系统中的其他工具结合使用,如 FlumeNG 用于数据收集,Spark 用于更快的数据处理,以及 HBase 用于实时数据访问等。这些工具的结合可以帮助企业构建一个强大的大数据处理和分析平台。
通过上述策略和工具的结合使用,Hive 可以在海量数据管理中发挥关键作用,帮助企业更有效地进行数据分析和管理。
相关文章
-
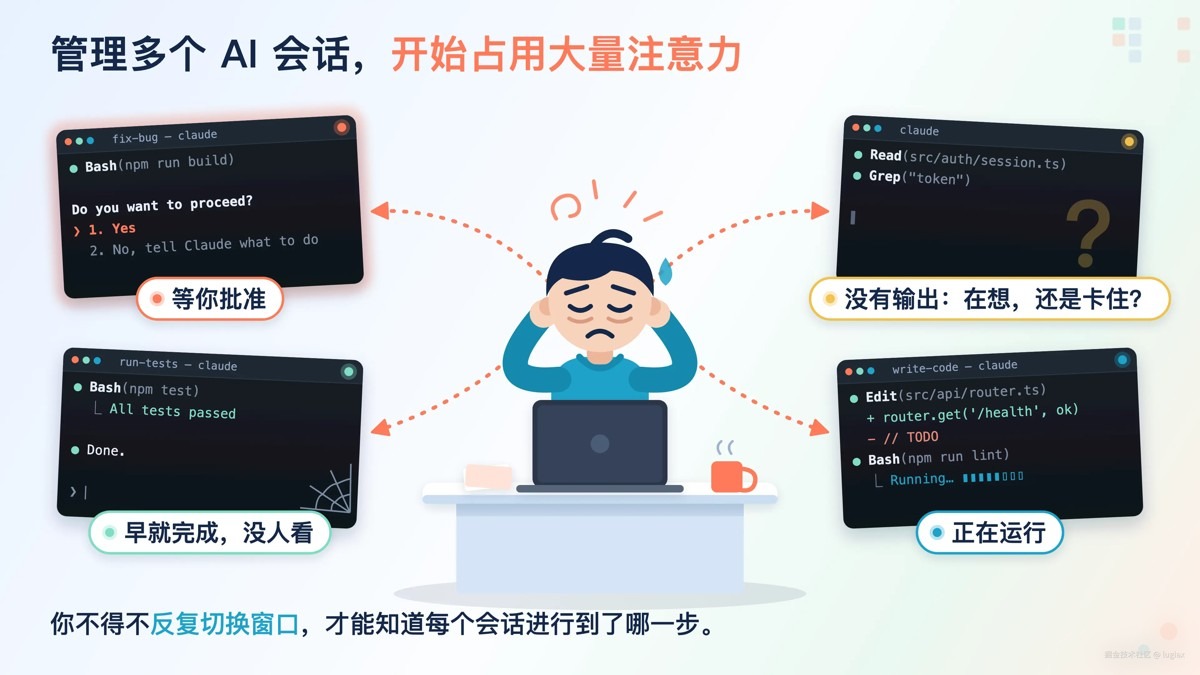
同时开多个Claude Code怎么管理?一文分享五大Claude Code多会话管理方案实用指南
游戏攻略 2026-10-12
-
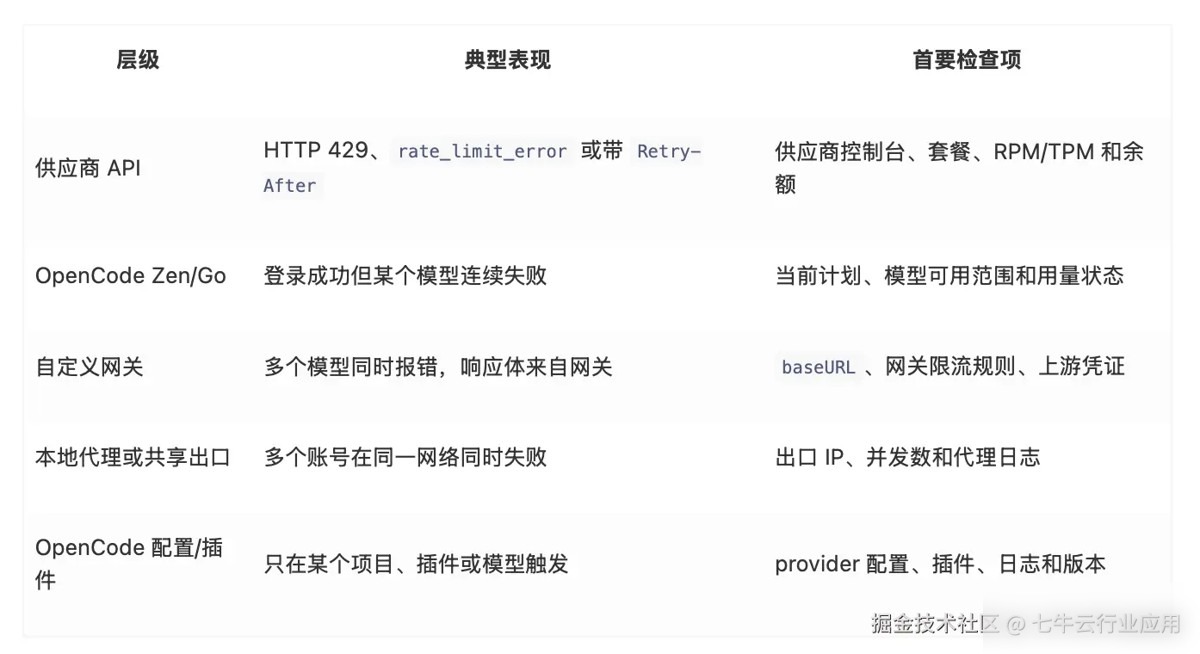
OpenCode报错Rate limit exceeded:限流原因、日志定位与修复步骤实用指南
游戏攻略 2026-10-12
-
OpenClaw千帆模型切换:精准配置步骤与关键命令完整指南
游戏攻略 2026-10-11
-
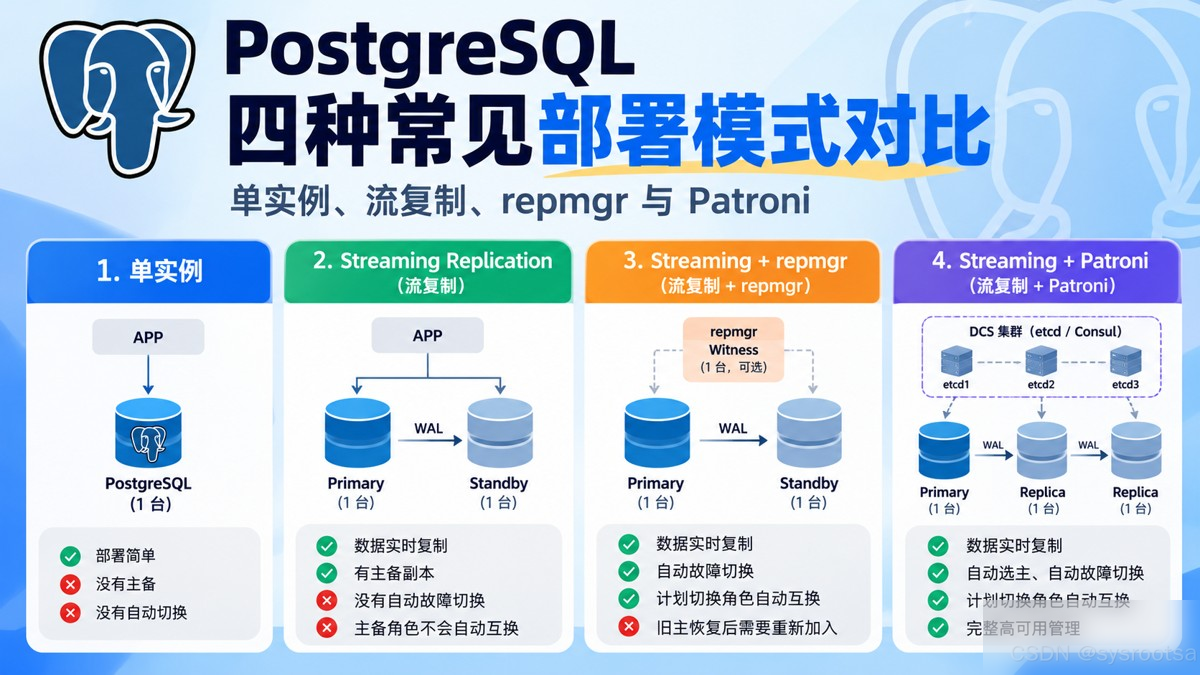
PostgreSQL四种常见部署模式对比完整指南
游戏攻略 2026-10-11
-
DeepSeek Harness第三方模型配置实践教程:桌面端、网页端与兼容接口实测实用指南
游戏攻略 2026-10-11
-
OpenClaw阿里云部署实践指南:从服务器搭建到QQ端接入使用实用指南
游戏攻略 2026-10-11