kafka client如何保障消息顺序
Kafka 是一个高吞吐量的分布式流处理平台,它支持多分区、多副本和负载均衡。然而,Kafka 本身并不保证跨分区的消息顺序。如果你需要确保消息顺序,可以采用以下方法:

单个分区:将需要保证顺序的消息发送到同一个分区。这样,消费者只需按顺序消费分区内的消息即可。为了实现这一点,你可以在生产者端设置
partitionKey,使其在同一个键值下发送消息。需要注意的是,这种方法会降低吞吐量,因为所有需要保证顺序的消息都发送到同一个分区。幂等性生产者:使用幂等性生产者,可以确保相同的消息不会被重复发送。这样,即使消息被多次消费,也不会影响顺序。要实现幂等性生产者,需要在生产者端设置
enable.idempotence为true,并提供一个唯一的transactional.id。需要注意的是,这种方法会增加一定的开销,因为生产者需要维护事务状态。有序消费者:使用有序消费者,可以确保消费者按照消息到达的顺序进行处理。要实现有序消费者,需要在创建消费者时设置
auto.offset.reset为earliest(从最早的消息开始消费)和enable.auto.commit为false(手动提交偏移量)。然后,在处理消息时,先提交已处理消息的偏移量,再处理消息。需要注意的是,这种方法可能会导致消费者的消费速度变慢,因为需要等待所有分区的消息都到达才能开始处理。
总之,要确保 Kafka 消息顺序,需要在生产者端或消费者端进行一定的配置和处理。具体选择哪种方法取决于你的业务需求和场景。
相关文章
-
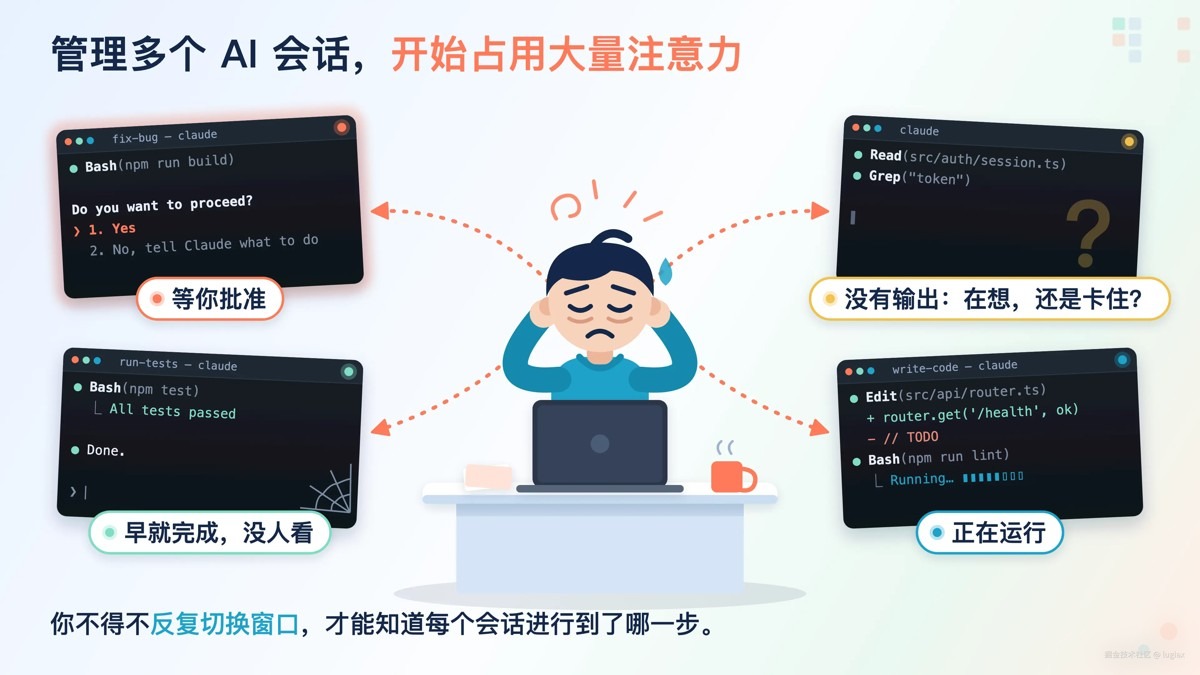
同时开多个Claude Code怎么管理?一文分享五大Claude Code多会话管理方案实用指南
游戏攻略 2026-10-12
-
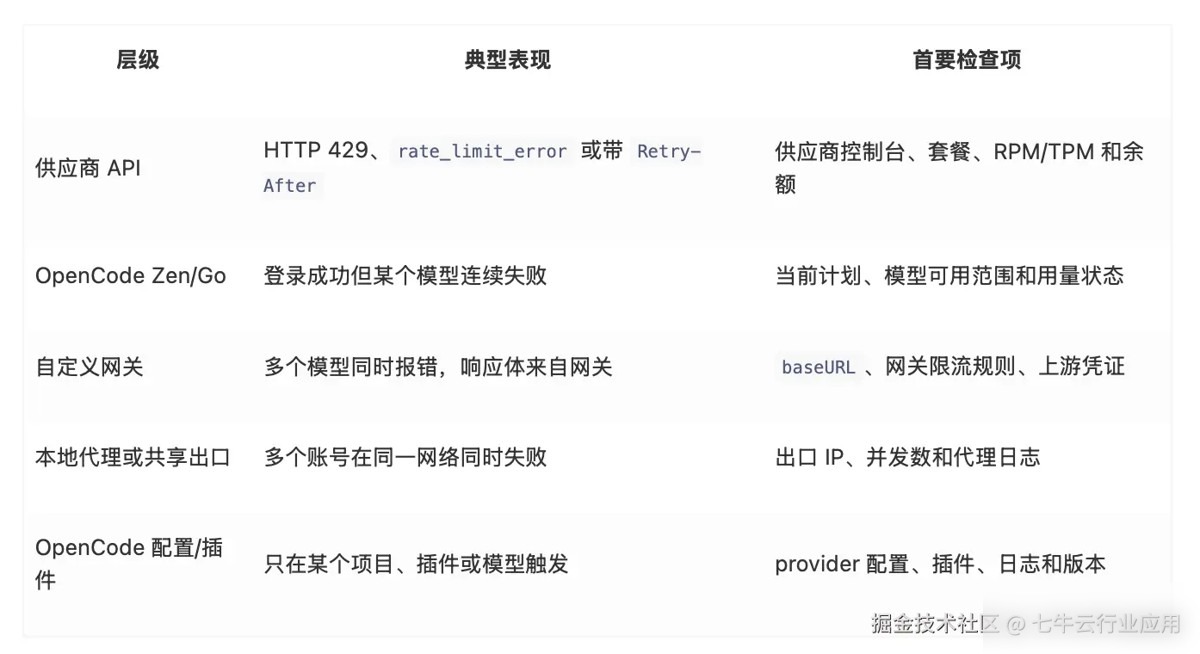
OpenCode报错Rate limit exceeded:限流原因、日志定位与修复步骤实用指南
游戏攻略 2026-10-12
-
OpenClaw千帆模型切换:精准配置步骤与关键命令完整指南
游戏攻略 2026-10-11
-
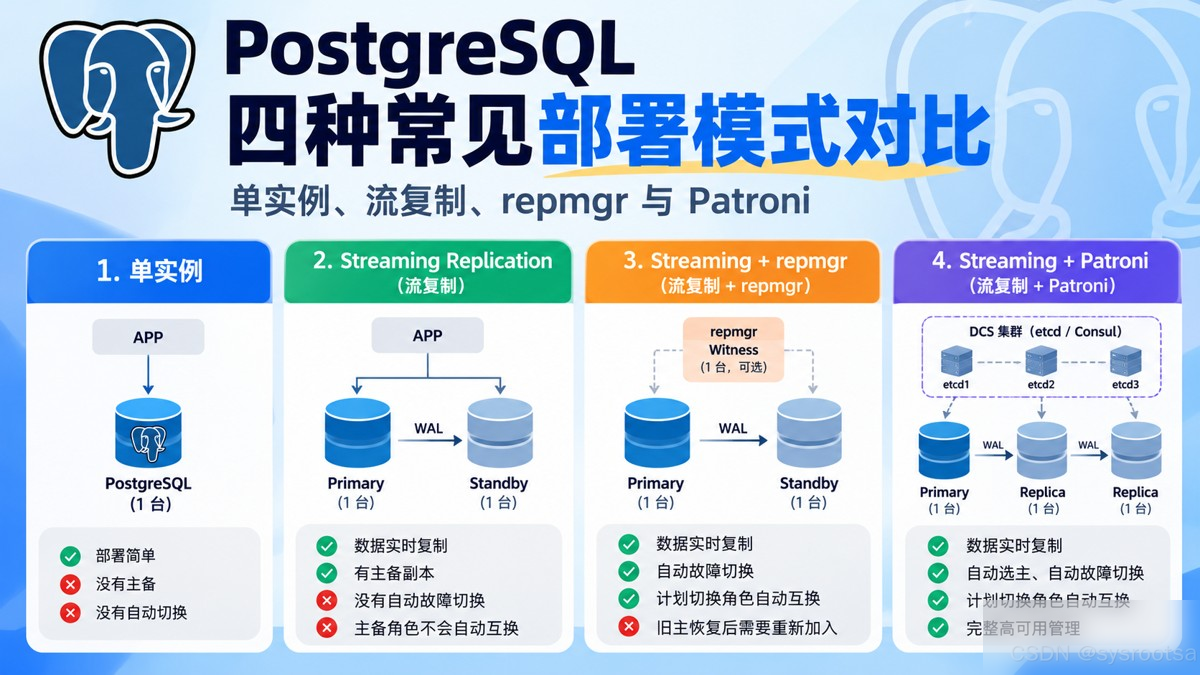
PostgreSQL四种常见部署模式对比完整指南
游戏攻略 2026-10-11
-
DeepSeek Harness第三方模型配置实践教程:桌面端、网页端与兼容接口实测实用指南
游戏攻略 2026-10-11
-
OpenClaw阿里云部署实践指南:从服务器搭建到QQ端接入使用实用指南
游戏攻略 2026-10-11