hive archive能实现数据去重吗
作者:袖梨
2026-06-25
Hive的Archive功能主要用于数据的压缩和存储,它将多个小文件打包成一个大的文件,以节省存储空间和提高查询性能。Archive功能默认会对数据进行压缩,但并不提供数据去重的功能。

如果你需要对数据进行去重,可以在将数据加载到Hive之前使用其他工具或方法进行去重,例如使用ETL工具(如Apache NiFi、Talend等)或编写自定义的脚本对数据进行去重处理。另外,在Hive中,你可以使用DISTINCT关键字进行查询层面的去重,但这并不会减少数据文件的数量。
因此,如果你需要实现数据的去重,建议在数据加载到Hive之前进行处理,或者使用Hive的查询功能进行去重。
相关文章
-
LangGraph 深入实践:用 Command 与 Send 实现动态流转和并行 Map-Reduce
游戏攻略 2026-09-15
-
借助AI把自己的项目快速部署到公网
游戏攻略 2026-09-15
-
Astra 连跑35小时耗尽40亿 token:我为 Agent 设下三道硬闸
游戏攻略 2026-09-15
-
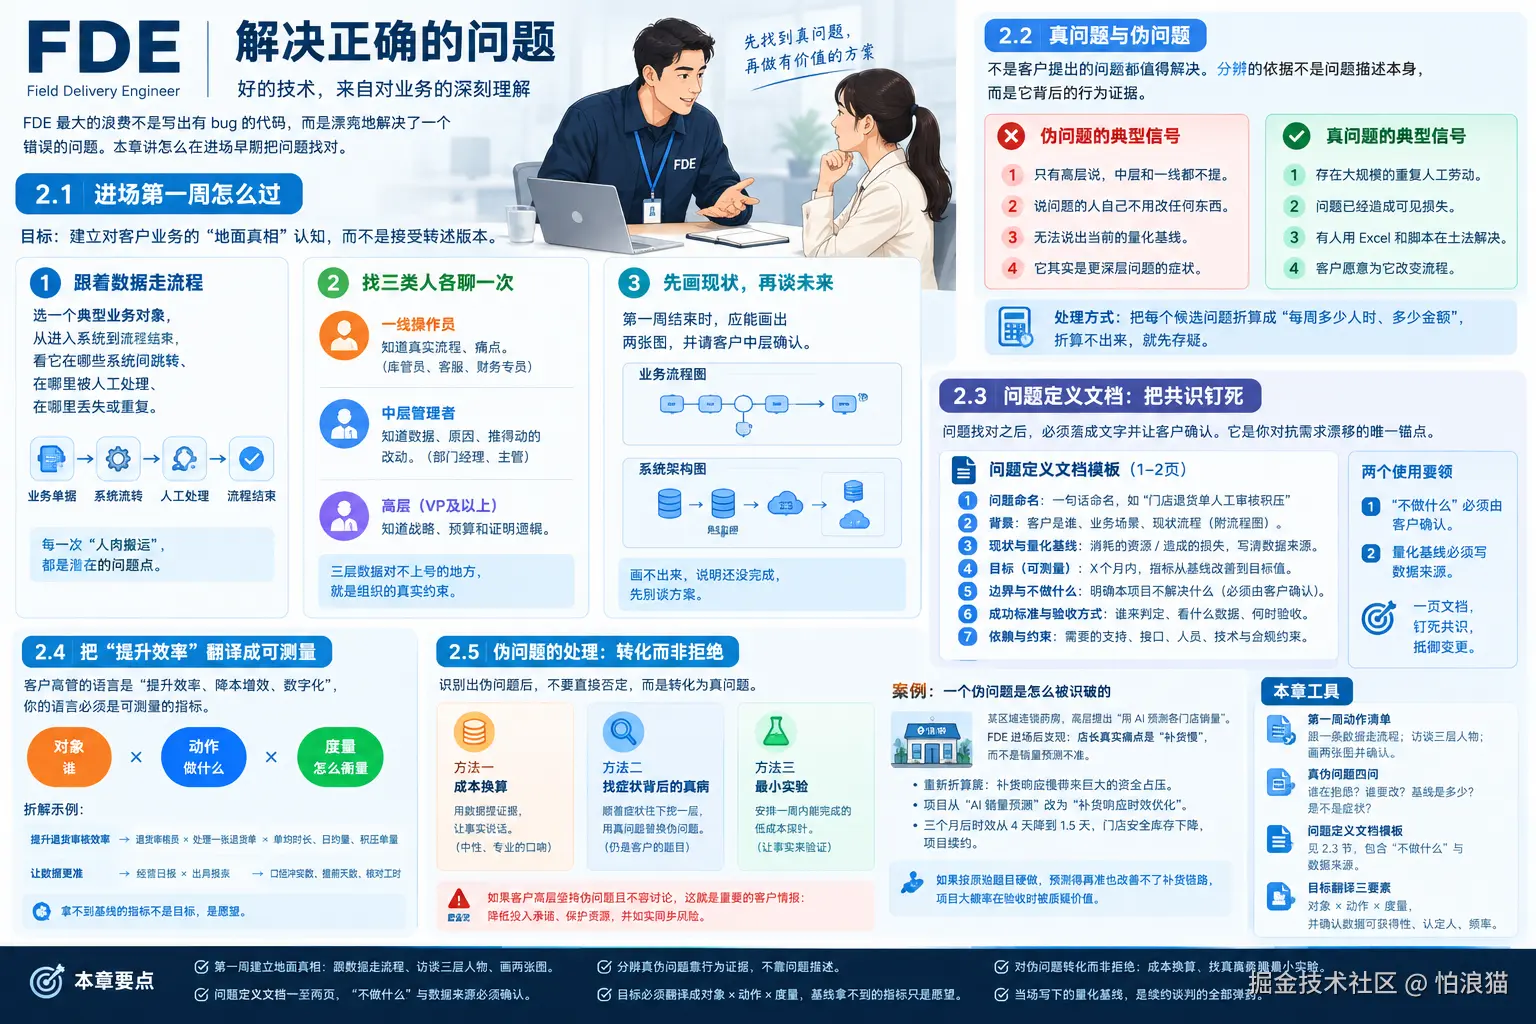
FDE 怎样解决现场项目中的工程问题
游戏攻略 2026-09-15
-
DeepSeek Harness 系列(06):动态 System Prompt 的组装机制与工程实现
游戏攻略 2026-09-15
-
工业IoT数据查询实践:借助AI编码助手快速拉取加热炉数据
游戏攻略 2026-09-15