Spring AI 面试高频20问:原理、RAG与工程实践
当 Java 项目开始接入大模型时,面试考察往往不只停留在 API 调用,还会追问框架抽象、组件协作和工程落地能力。围绕 Spring AI,需要理解多模型适配机制,也要能说明工具调用、结构化输出、RAG 检索以及服务容错等关键环节。下面从常见问题入手,逐步梳理这些知识点。
Spring AI 高频面试题20道
覆盖基础概念、核心原理、RAG实战、工程优化全维度,适配Java中高级AI应用开发岗位面试。
一、基础概念类
-
什么是Spring AI?它的核心设计目标是什么?Spring AI是Spring官方推出的AI应用开发框架,核心目标是简化Java开发者接入大模型、向量数据库、RAG等AI能力的流程,提供统一API、模型无关性,让开发者像用Spring Data操作数据库一样轻松集成AI能力,无需关注底层大模型调用细节。
-
Spring AI和直接调用OpenAI原生SDK相比,核心优势是什么?统一抽象屏蔽不同厂商SDK差异,切换大模型只需改配置无需改业务代码;内置Prompt模板、对话记忆、RAG、工具调用等工程化能力;与Spring生态无缝集成,完美兼容依赖注入、配置中心、坚控等原生特性。
-
Spring AI和LangChain的核心区别是什么?Spring AI以Java生态为核心,轻量简洁,深度适配Spring体系,工程化落地效率高;LangChain以Python生态为主,功能覆盖更全面但Java版本支持较弱,更适合Python技术栈的AI项目。
-
Spring AI的三层架构是怎样实现多模型无缝切换的?顶层抽象层定义ChatModel、EmbeddingModel等通用接口统一调用规范;中间适配层封装不同大模型厂商的具体实现;底层整合层基于Spring Boot自动配置原理,通过Starter依赖自动装配,业务代码仅依赖抽象接口,切换模型只需修改配置文件即可完成。
-
Spring AI支持哪些主流大模型和向量数据库?大模型侧支持OpenAI、通义千问、文心一言、Ollama本地模型、智谱GLM等;向量数据库侧支持PgVector、RedisVectorStore、Milvus、Chroma、Elasticsearch等主流实现。
二、核心组件原理类
-
ChatClient和ChatModel是什么关系?各自职责是什么?ChatClient是面向开发者的流式调用门面,提供流畅的API封装请求发送和响应接收;ChatModel是底层大模型的抽象接口,定义了核心的call()方法,ChatClient内部委托ChatModel完成实际的模型调用逻辑,业务代码依赖ChatClient实现与具体厂商解耦。
-
Spring AI中Message抽象支持哪些角色?各自作用是什么?原生支持5种消息角色:SystemMessage用于设定模型全局行为规范;UserMessage承载用户的提问输入;AssistantMessage存储大模型返回的历史回复;ToolCallMessage标记模型发起的工具调用请求;ToolResponseMessage承载工具执行后的返回结果。
-
EmbeddingModel的核心作用是什么?将非结构化文本转换为固定维度的高维向量,是RAG场景的核心基础设施,用于实现文本之间的语义相似度计算,支撑向量数据库的相似性检索能力。
-
什么是PromptTemplate?它的实战价值是什么?提示词模板,支持通过变量占位符动态填充内容,实现提示词的统一管理和复用,避免硬编码大量提示词,大幅提升复杂提示词的可维护性。
-
Spring AI的流式响应是怎么实现的?基于SSE(服务器发送事件)协议接收大模型返回的流式数据,底层通过StreamingChatModel接口返回Flux响应流,前端可以逐字接收内容,实现打字机效果的对话体验。
-
Spring AI结构化输出的实现原理是什么?通过BeanOutputConverter将目标Java类的字段结构自动生成JSON格式说明,注入到Prompt中引导大模型严格按照指定JSON格式返回结果,框架再自动将返回的JSON反序列化为对应的Java对象,实现结构化输出。
-
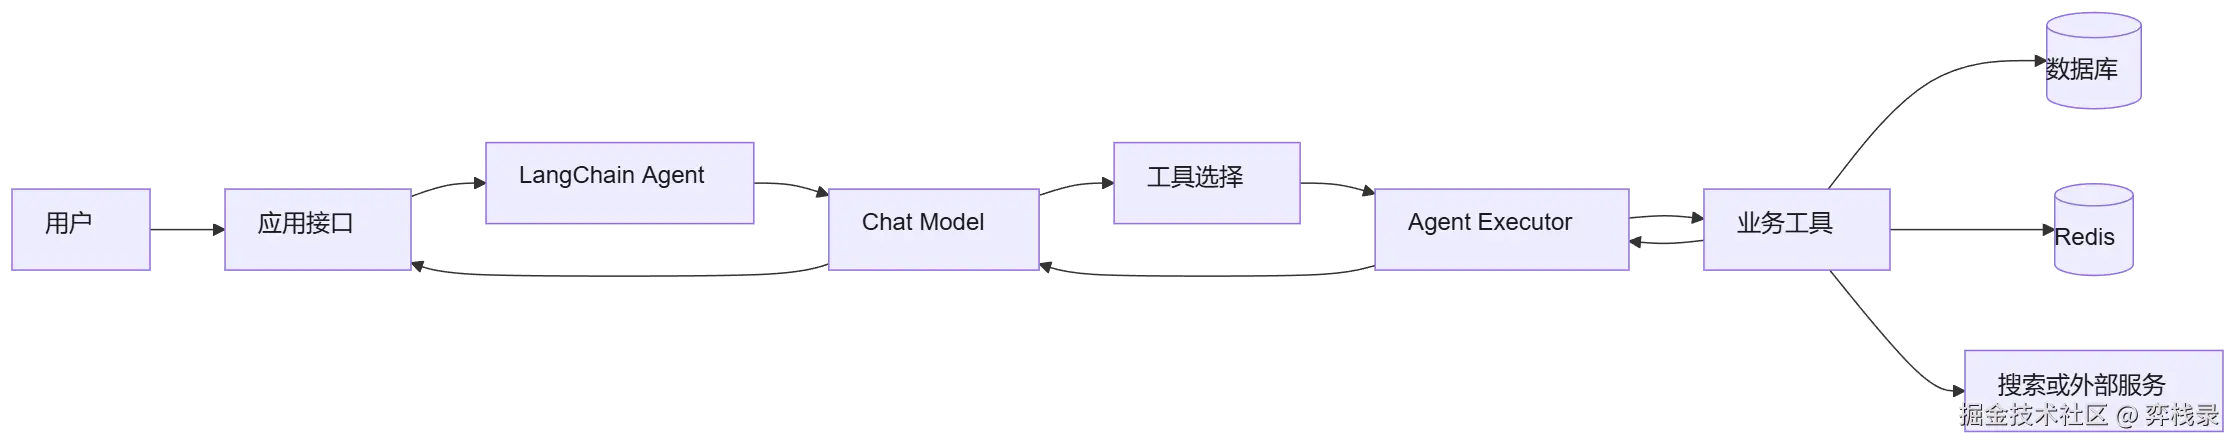
Spring AI函数调用(Tool Calling)的底层原理是什么?通过@Tool注解将Java方法的名称、参数Schema、功能描述注册给大模型;大模型根据用户意图自动判断是否需要调用工具,提取对应参数;框架执行目标Java方法后将结果回传给大模型,最终由大模型整合信息返回自然语言回答。
-
VectorStore组件的核心作用是什么?向量数据库的统一抽象层,屏蔽不同向量数据库的底层实现差异,提供标准化的向量写入、相似性检索接口,开发者无需修改业务代码即可切换不同的向量存储实现。
-
Spring AI的Advisor链是什么?有什么实战价值?是一套可自定义顺序的请求拦截器链,支持在大模型调用前后插入自定义逻辑,比如自动加载对话记忆、执行RAG检索、添加日志埋点、做请求参数校验等,大幅提升AI应用的可扩展性。
-
Spring AI如何实现大模型的懒加载?通过@Lazy注解修饰大模型Bean,结合Spring的延迟加载机制,避免应用启动时就加载大尺寸模型,大幅缩短应用启动时间,模型会在第一次被调用时才完成初始化加载。
三、RAG与工程实战类
-
Spring AI实现RAG的完整流程是什么?分为离线和在线两个阶段:离线阶段通过DocumentReader加载文档,TextSplitter对文本进行分块,EmbeddingModel将文本块转换为向量后存入VectorStore;在线阶段将用户问题转换为向量,在向量库中检索相似文本块,拼接上下文后传入大模型生成最终回答。
-
为什么RAG场景必须使用向量数据库,而不是普通关系型数据库?普通数据库仅支持精确匹配,无法实现语义层面的相似性检索;向量数据库专门针对高维向量做了索引优化,支持高效的Top-K语义相似度查询,是RAG实现精准召回的核心基础设施。
-
Spring AI中如何实现大模型服务的熔断降级?可以整合Resilience4j的@CircuitBreaker注解,为大模型调用接口配置熔断规则,当模型服务超时或错误率达到阈值时,自动触发fallback方法返回预设兜底结果,避免上游业务链路雪崩。
-
Spring应用中优化AI模型推理性能有哪些主流方案?常见方案包括:对模型做量化压缩降低计算开销;通过@Cacheable注解缓存重复输入的推理结果;使用BatchExecutionTemplate批量处理请求提升吞吐;通过NativeImageConfig开启硬件加速,适配GPU等算力资源。
-
RAG项目中常见的优化手段有哪些?优化文本分块的粒度适配模型上下文窗口;采用多路召回策略结合向量检索和关键词检索;对检索到的文本块做重排序提升召回精准度;通过Prompt工程优化上下文拼接方式,减少无关信息干扰。