grounded-forge:AI Agent 工具实践指南
实际评估grounded-forge时,我先确认它解决的具体问题:项目一次,检索精炼,创建工具:预加载检索架构和工具构建器,用于可分发、基于源代码的助手,用于在已知任务领域进行复杂、可重复的工作。从软件开发的使用方式看,依赖、接口和异常处理往往比主路径更影响采用是采用前必须回答的问题。短测时我会在隔离分支完成一个可回滚的小任务,并保留安装步骤、接口契约、测试结果和错误信息的结果,方便团队复盘。对需要可检查开发流程而非单次演示的工程师来说,这个仓库值得继续验证;只求即装即用的人则要先看维护成本。
接地锻造
针对接地助理的研讨会:协调员、教练、分析师、顾问。在这里创建一个发行版;在您需要保留源的任何地方运行它。
项目一次,检索精炼。 一种基于源的助手的检索架构,可在已知任务领域中进行重复工作。
选择胜过重塑。该库在结构化的 9 遍摄取协议下读取每个源一次,并将其预先投影到助手支持的每个任务域上。运行时是查找,而不是重新推导:辅助路由到参考×任务矩阵中已经投影的蒸馏,然后引用回源。合成工作在审核时一次性支付;查询选择一个已经投影的单元格,而不是从原始块中重新派生它。
经过测量,收据已发布。 通过相同来源与 Google 的 OKF 参考生产者进行正面交锋,9 遍层以 0.33% 和 0.38% 的硬错误率提取了 1.7 倍的原子声明,没有检测到差异(与 回合)。每个深度引用均由独立的跨模型审核员进行审核(2026-08-08 批次中的 9,364 项索赔可追溯到源头),并且每个经过验证的发现均已修复(收据)。首次查询路由花费 28-47k 令牌,从约 131k 下降(数字)。
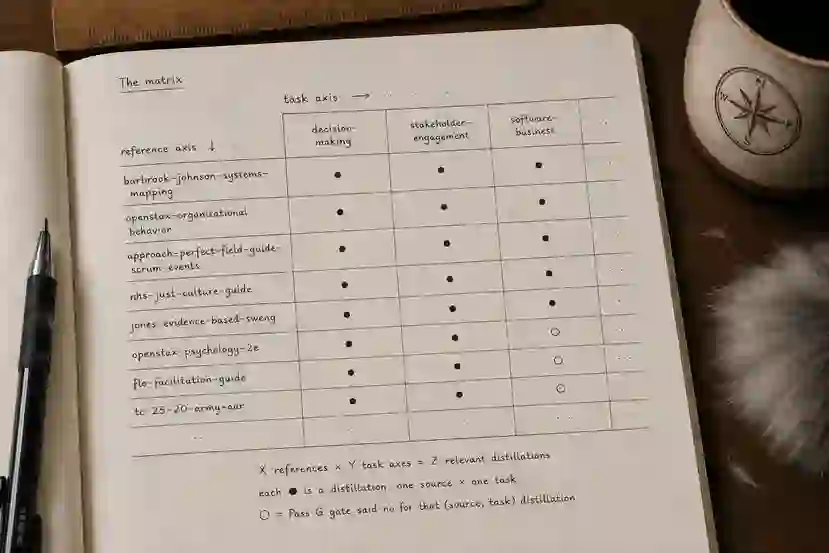
参考×任务矩阵。该图采样了三个任务轴和八个参考;实际的演示语料库在五个任务轴(决策、利益相关者参与、软件业务、AAR、复古)中提供了 28 个参考文献。
A ○ 表示来源的贡献已包含在矩阵的其他位置。 TC 25-20涵盖了AAR的促进工艺;它的决策和利益相关者参与预测提供了这种工艺。软件业务特定的事件权重——系统与个人的责任、面向监管者的学习循环、技术事件的 PR- 和客户维度——来自 NHS 正义文化、LFUO 和商业道德。运行时会通过带有问题的投影。
每个蒸馏都是一个位于 corpus.commons/{corpus}/distillations/{task}/{slug}-{task}.md 的 Markdown 文件,一个源投射到一个任务域。演示语料库将 28 个引用投射到五个任务轴上:decision-making 具有 27 个蒸馏,stakeholder-engagement 有 27 个,software-business 有 25 个,加上两个仪式轴 aar 和 retro 各有 19 个。有 117 个蒸馏和 23 个明确的 Pass G 跳过,其中来源不保证任务预测。分叉它并摄取你自己的语料库;可以通过一个命令删除包含的内容。
诊断。 LLM 从训练中继承了默认权限:写得最多的顾问衍生层的共识声音。主要来源缓慢且罕见,位于异常值尾部。网络搜索和“研究级”路由放大了相同的分布。
默认LLM权限为顾问频率模式。网络搜索提供了更多语言的访问,而不是真相。矩阵拒绝这种默认设置。选择你的来源。将它们投射到您的任务中。然后,助手会浏览您的窗口,而不是训练分布的窗口。遵循一条规则:镜头是窗户,而不是自身——学科镜头规格写在下面。关于旧词汇(Bruteau 的心灵网格,1979)及其规则的基础的旁白位于 网格制作者。请在工程文档之后阅读,或跳过。
应用程序已发货
decision:决策助手;所有参考文献都投射到决策任务轴。stakeholder:利益相关者参与助理;相同的参考文献,利益相关者参与预测。software-business:技术与商业交叉点的软件业务助手。aar-mode:开放语料库事后审查助手。纪律借用 LFUO 2024 + NHS 正义文化 + SSDL + TC 25-20;附带aar-facilitator运行时代理。retro-mode:开放语料库回顾促进助手。借用学科——通过方法完善的现场指南+开放实践库+解放结构+开放看板;附带retro-facilitator运行时代理。
两个仪式配置文件交叉链接:aar-mode 是事件触发的跨职能轴,retro-mode 是迭代团队内部轴。相同的底层语料库,不同的投影。
从这里你可以做什么
在运行任何操作之前,docs/examples/marines-vs-business-admin-conversation.md 显示输出的样子:逐字捕获的 answer-from-corpus 会话 — 海军作战条令 × 教科书业务管理,具有完整的路由通道、检索跟踪和带内证据标记。阅读时间约 5 分钟。
- 演示应用程序: 在 Claude Code 中打开一个内置应用程序,向其提问,查看矩阵路线。零设置。 〜25分钟。
- 查询库: 三个只读技能 -
answer-from-corpus、matching-references、audit-attribution- 加上读取跟踪(五秒答案审核)。约 30–45 分钟。 - 摄取一个源: 针对您带来的一个源的 9 遍摄取协议。矩阵扩展一行。 〜60 分钟。
- 确定源范围:
finding-resources(预摄取分类)+ingesting-images(视轴)。 〜20分钟。 - 添加任务轴: 矩阵中的新列。
creating-tasks+creating-applications+creating-distillations。约 60–90 分钟。 - 添加透镜: 每次蒸馏修饰符。
creating-lenses+ 通过G的预蒸馏门。约 45 分钟。 - 搭建语料库: 使用
creating-corpus的完整分叉弧。约 2-3 小时。
有关操作指南、查找材料和架构论证的文档索引位于 docs/README.md。请参阅 docs/architecture/overview.md 了解一页摘要,并参阅 docs/architecture/projection-time.md 了解针对标准 RAG 的成本曲线框架。
这是给谁的
这适用于在狭窄的任务域中构建基于源代码的助手的人,在这些任务域中,相同的源代码会被重新读取以完成相同的少数任务。
提供的开放语料库展示了一般商业参考工作的模式;它是指导、培训或咨询库的代理,而不是受监管领域的知识库或高速源语料库。有关矩阵工具错误的情况,请参阅 docs/architecture/projection-time.md。
如何使用
对于演示(零设置): Node 18+ 用于构建和打包程序,Python 3.9+ 用于 npm run remove-corpus 和 Chroma 脚本。 pip install chromadb 是默认路径中唯一的 Python 依赖项。
通过演示 - 打开一个构建的应用程序,摄取你自己的源代码,搭建一个新的语料库 - 需要更多。安装并登录 Claude Code,导出 ANTHROPIC_API_KEY(或涵盖 Opus 使用的 Claude 订阅),用于源转换的 markitdown,以及在 9-pass 协议下每个摄取源大约 1-5 美元的 Opus 代币。这些教程列出了它们适用的地方。
npm install
npm run build
diff -rq corpus.commons/demo/apps/decision/ corpus.commons/demo/apps/stakeholder/
diff 通过一个命令证明了矩阵架构:
Files corpus.commons/demo/apps/decision/CLAUDE.md and corpus.commons/demo/apps/stakeholder/CLAUDE.md differ
Only in corpus.commons/demo/apps/decision/distillations: decision-making
Only in corpus.commons/demo/apps/stakeholder/distillations: stakeholder-engagement
两者上游的参考语料库相同。不同的蒸馏目录(每个目录都带有自己的每轴 task-index.json 运行时路由器以及 .md 操作员检查视图),不同的 CLAUDE.md。每个应用程序都是矩阵的一列,独立切片和发布。已发布的语料库级索引(slug-table.json 和仅蒸馏的 concept-index.json)在各个应用程序中是相同的; reference-index.json 和参考层位于上游。
要运行应用程序:从源代码树中复制应用程序文件夹并在 Claude Code (cp -r corpus.commons/demo/apps/decision ~/decision-app && cd ~/decision-app && claude .) 中打开它。捆绑的 CLAUDE.md 指示助手首先读取运行时 JSON 索引,路由到相关的蒸馏,并使用每个蒸馏在带内携带的引文和证据标记来归属声明。通过持久化 Chroma 集合进行的语义搜索调度位于策划索引下方,作为安全网(请参阅下面的克隆上的语义搜索)。
要将应用程序交给其他人:npm run package decision 在 corpus.commons/demo/distros/ 中生成范围标记的 tarball。接收者解压并运行claude .。
有关路由链的有效示例(索引命中 → 蒸馏 → 深度引用),请参阅 docs/architecture/matrix-pattern.md。
克隆的语义搜索
语义搜索后端是一个 Chroma 集合,保存在 {corpus_root}/chroma/,每个语料库一个,在克隆时重新生成。 Chroma 是一个派生索引,模型+库版本绑定,因此配方在存储库中发布,并且索引在本地重建。
pip install chromadb
python3 scripts/setup-chroma.py             # build the demo corpus's chroma index (~30s)
python3 scripts/setup-chroma.py --check     # run 3 canned queries, print top hits
--check 证明了端到端的检索循环,无需调用克劳德代码:自然语言查询路由到语料库的预投影蒸馏,按余弦相似度排序。对于不同的语料库,传递--corpus corpus.local/your-corpus;色度目录解析为该语料库的根目录。要在编辑参考文献或提炼后重建集合,python3 scripts/setup-chroma.py --rebuild。默认嵌入函数是 chromadb 的 DefaultEmbeddingFunction(ONNX 运行时,all-MiniLM-L6-v2,约 80MB 下载一次到每台机器缓存);默认路径中没有 PyTorch 依赖项。选择加入的交叉编码器重新排名 (--rerank) 已记录,但未针对该语料库进行评估;参见 docs/architecture/decisions-and-non-decisions.md。
写入时的源完整性
.claude/hooks/validate-deep-ref.py 处的 PreToolUse 钩子在针对 corpus.commons/demo/references/*-deep.md 进行任何写入或编辑之前触发,并在违反结构合同(存在前言、五行内的块引用引用、证据标记格式良好、无TODO / [citation pending] 文物)。该钩子是 scripts/validate/deep_ref_core.py 中与运行时无关的检查的瘦适配器,因此每个执行点(该钩子、构建时验证和 git 预推送审核)都从一个事实来源控制相同的合约。 Pass I 纯源审计是模型级别的守卫;钩子是确定性守卫。 scripts/audit-deep-ref.py 的启发式按需审计运行索赔行覆盖率分析,并故意误报;操作员读取,操作员决定。
npm run audit-deep-refs                                    # audit every deep ref
python3 scripts/audit-deep-ref.py corpus.commons/demo/references/X.md  # one file
作为 Claude Code 插件安装
该存储库兼作 Claude Code 插件 (.claude-plugin/plugin.json)。 .claude/skills/ 下的技能、.claude/settings.json 处的挂钩以及捆绑的 CLAUDE.md 安装时自动发现。克隆并运行生成与插件安装相同的配置;清单是已发布的表面,而不是单独的构建工件。
代理可用于任何工具
克劳德代码读取为 CLAUDE.md;其他编码代理(Codex 和不断增长的 AGENTS.md-aware 工具集)读取 AGENTS.md。该存储库在其根部提供了一个瘦适配器,它将任何文件访问代理指向相同的护栏:读取 CLAUDE.md,在运行时支持的情况下本地调用 .claude/skills/*/SKILL.md 下的技能,在不支持的情况下回退到将它们作为书面过程读取,并尊重源完整性底层和层分离。无论供应商如何,每个代理都会遇到持久的执行:git 预推送审核和构建时验证,而不是任何一个运行时的预写入挂钩。任何到达这里的特工都会继承它读取的第一个文件的纪律。
为您自己的域分叉
该存储库在 corpus.commons/demo/ 提供了一个演示语料库,在 corpus.local/ 提供了一个私有工作区(gitignored,按需创建)。拆分是结构性的:corpus.commons/ 是可跟踪的、可再分发的、开放许可的; corpus.local/ 是你的,永远不会进入仓库。
语料库是独立的:来源、参考文献、提炼、镜头、编译的应用程序和打包的 tarball 都位于一个文件夹中。明天的贡献者PR在corpus.commons/下添加一个文件夹;明天的操作员将一个文件夹放入 corpus.local/ 中。两种方式的布局都是相同的。
完整的分叉弧是 Scaffolding a corpus (教程)和 docs/how-to/build-your-library.md (相同过程的操作参考)。
共享语料库。 当您的 corpus.local/your-corpus/ 准备好公开发布时,请将文件夹移至 corpus.commons/your-handle-your-corpus/ 并打开 PR。布局不变;许可规则确实如此。请参见 CONTRIBUTING.md。 corpus.commons/ 中的所有内容都必须可在 open 或 open-nc 下重新分发。
集成、运行时耦合和退出
该语料库是可移植的。参考文献、蒸馏、镜头和索引均以 corpus.commons/{corpus}/ 或 corpus.local/{corpus}/ 的形式进行简单降价。构建系统是 Node.js,产生更多降价。打包脚本生成 tarball。 9 次摄取协议以散文形式描述;仅源审计规则是一种方法,而不是供应商锁定。通过不同的编排框架重用语料库材料的分叉将继承这些工件而无需修改。
运行时以代理 CLIs 为目标,具有两个成熟度级别。 Claude Code 是广泛使用的基础:使用 claude . 打开应用程序文件夹,通过 /answer-from-corpus 和朋友调用技能,PreToolUse 钩子在写入时验证深度引用,会话中检索流程。 .claude/skills/下的技能、.claude/hooks/下的钩子和.claude-plugin/plugin.json清单是Claude Code的表面。 Codex 是新移植和冒烟测试的:AGENTS.md 将其指向同一个合约,其技能被读取为书面程序而不是本地调用,并且由运行时中立层执行(git 预推送审核和构建时验证)。想要在不同代理框架(LangGraph、CrewAI、普通 SDK 调用)下获得相同体验的分叉将需要重新实现运行时层。语料库将在迁移后继续存在;编排不会。
模型耦合比看起来更轻。 9 遍摄取协议主要针对 Claude Opus 4.7 开发和运行,深度引用携带 Generated by: 元数据来命名所使用的模型。在非正式的并排阅读(不是测量比较)中,Opus 的输出比 Sonnet 更可靠;其他模型(Claude Sonnet、GPT-4-class、具有足够上下文和引用规则的开放权重模型)似乎可以完成相同的工作。邀请在不同模型下运行自己的摄取的分叉者测试并报告结果;记录的协议不绑定到一种模型。在不同模型下重新摄取现有源会产生一个单独的工件,可通过 Generated by: 元数据进行区分,因此语料库可以进行并行摄取以进行比较。
出口看起来像这样:语料库是文件。 MIT 许可证涵盖基础(构建系统、脚本、架构文档、技能、构建配置文件、索引框架); CC BY 4.0 涵盖了长篇散文和原始内容(由维护者编写的参考文献、摘录、镜头、源边车);源许可证管理从每个源派生的深度引用(每个源的范围和许可证都标记在文件的前面)。决定停止使用此架构的操作员会拿走他们的语料库并离开。在其下生成的工件可由任何读取 Markdown 的工具读取,并且构建将每个配置文件的数据层作为开放知识格式 (OKF v0.2) 捆绑包(任何符合工具都可以使用的已发布交换格式)发出,因此出口具有标准轨道门和文件树(请参阅 docs/how-to/emit-okf.md)。设计或协议中的任何内容都不会对该存储库的维护者或 Anthropic 造成锁定。
审计收据和评估
两个结果领先,均在回购中收到。
与 Google 的 OKF 参考生产者正面交锋,使用相同的来源、跨模型、匹配的法官和匹配的审计启动:在完全匹配的手臂上,9 遍层提取了 909 个原子声明,而天真的生产者的 526 倍 - 1.7 倍的覆盖率 - 硬错误率为 0.33% 与 0.38%,没有检测到差异。更广泛、不太匹配的臂达到了约 3 倍的覆盖范围,但不支持错误率比较,并且两个臂分别报告。仅从生产通行证来看,在没有测量错误率成本的情况下获得更多覆盖范围:匹配的参考仅运行通行证 A-E,因此匹配的结果并不依赖于 Google 生产商缺乏的审核通行证。完整记录、双臂文物和每份审计收据均发布在 docs/evals/rounds/2026-08-08-producer-head-to-head/ 上;任何人都可以重新进行审核。
每个深度引用都经过独立审核:人口普查,而不是样本。 来自不同模型系列的新上下文审计员将 2026 年 8 月 08 日批次的 27 个深度引用中的所有 9,364 个声明追溯到严格声明粒度的转换来源; NIST SSDF,此后添加,于2026年9月27日审核。预修复层的干净度为 97.45%,硬错误率为 2.6%,主要归因于消息来源从未透露姓名的人员以及枚举错误计数;在修复期间,所有 446 个结果都根据源进行了重新验证(445 个已修复,1 个因源支持而被拒绝),其中 412 个传播修复将修复追至光参考和蒸馏,并对六个最差源进行了逐个发现的重新验证。收据(每个源的机器可读结果、语料库摘要和修复记录)位于 corpus.commons/demo/references/_audit/。一次审核通过可以减少但不能消除注入的错误;通过重复、独立的检查和更强大的生产模型,残差会下降。 Google 的参考生成器没有进行源代码级审核。
审计层发现了自己的盲点。 面对面的回合暴露了 LLM 自我审计的失败模式:上下文审计将生产模型自己的制造证明为“在源头验证”,并且在新环境中的相同程序未能通过相同的文件;对第二个典型家庭的新审计也发现了该家庭自身的漏洞。因果变量是上下文的新鲜度,而不是模型。因此,通过 I,协议的仅源审计 - 对每个已完成的深度引用进行冷读,将每个声明追溯到转换后的源,并拒绝发送任何未通过跟踪测试的内容 - 必须在新的上下文中运行,最好是与生成深度引用的模型不同的模型。 上下文中的自我审计读取生成会话刚刚写入的基于源的训练优先级并通过它们;独立是让冷读变得冷酷的原因,也是唯一能让制片人产生自信幻觉的东西。 Fresh-context Pass I 在协议中是强制性的,上面的语料库范围的独立审计是在其下运行的。协议位于docs/architecture/source-integrity.md;第 I 轮根据 tests/audit-fixtures/ 的夹具语料库进行校准,十二个短夹具涵盖了协议的指定故障模式以及干净的负控制。
比较方法评估是一个单独的表面:docs/evals/harness/ 的盲 LLM- 判断协议在 5 个标准标题下对同一提示的四个方法答案进行排名 - 天真的克劳德、强制研究的克劳德、上下文中的转换源和矩阵 - 每个都以其自然的方式收集产品表面。方法定义、重现性注释和标题位于 docs/evals/methodology.md。由于使用的语料库超出了演示语料库,因此对内部评估轮次的结果进行了定性总结:
-
矩阵是必要的,而不是多余的,其中克劳德的训练先验无法路由语料库。在薄文件名语料库上,在非公开语料库上,并且在馆长与规范分歧是承载的情况下,训练先验路由失败并且矩阵的管理完成工作。
-
镜头架构在矩阵的管理之上赢得了可衡量的评分标准。在非公开材料上,在相同的提示上,带镜头的方法 D 比无镜头的方法 D 多出 0.6 个评分标准点,这与镜头架构预测的方向一致。该镜头提高了短暂的依从性,而不是引用密度(命名学者计数几乎相同,为 8 比 9):镜头规范正在研究人工制品的结构,这就是它的设计目的。
-
迁移后,第一个查询的路由税很小,第二个查询就消失了。 2026 年 5 月的索引迁移(降价至 JSON)将演示语料库上矩阵的每个查询首次加载从约 131k 令牌减少到 28-47k(仅在低端的语料库级索引,加上在高端的一个任务轴)——接近原生语料库访问的令牌成本第一个查询和会话摊销会反转第二个和后续查询的比较。配对的文件名模糊探针找到了朴素语料库访问强度背后的机制:可读的
{author}-{topic}-{year}.md文件名作为 Claude 之前训练的关键。在规范材料上,原始文件名比模糊文件名高出 0.6 个评分点,命名学者数量增加了一倍(26 比 13);在非规范材料上,两种变体的误差都在 0.2 分之内,并且效果消失了。迁移后编号为docs/architecture/projection-time.md。 -
如果语料库是规范的并且文件名路由它,这些轮次显示矩阵的答案质量没有提高;简单的语料库访问就足够了。 矩阵在该表面上的剩余情况是审计可追溯性和会话摊销;其必要情况是训练之前无法路由的语料库。
该标题的一个限制是结构性的,这就是上面的生产者正面交锋存在的原因。单个 LLM-as 法官无法衡量矩阵的独特增值(对操作员策划的非规范材料的每个索赔的可审计性),因为法官的验证表面是其自己的训练先验,即矩阵所防御的分布。法官根据顾问频率均值进行操作:图书馆的 LLM-epistemology 推论拉曼定律 4 (docs/architecture/llm-epistemology.md) 显示在评估内。面对面的竞争完全回避了法官的先验,根据源文本逐项审核生产者的输出。完整的分析、每轮证据和下一个标题候选者(根据操作员标记的地面事实校准的评论家、审计跟踪保真度分数、强制网络搜索臂)位于 docs/evals/methodology.md。
此版本所捍卫的内容:生产者纪律是基准化的(与 Google 的参考生产者相比,完全匹配的手臂上的覆盖率达到 1.7 倍,且没有测量错误率成本);每个应用程序背后的深度参考层均经过独立审核,并发布收据;当先验训练无法路由语料库时,矩阵是必要的;在此基础上,这款镜头还获得了可衡量的分数。如果语料库是规范的并且文件名路由它,则简单的语料库访问就足够了。这些船作为有界索赔与收据,而不是一揽子收据。
分叉使用 docs/evals/harness/ 的判断协议根据自己的语料库评估架构。建筑地面位于docs/architecture/。
现有技术
该矩阵于 2026 年 2 月 15 日投入生产,比 Karpathy 的 LLM Wiki gist 早七周,比 Google 的 OKF 早四个月,并在相同的 9 遍协议下在操作员之前的工作中运行。三个独立到达同一底层:降价知识文件、确定性路由、摄取时间投影。该存储库添加的综合(仅源审计下摄取时的矩阵预投影)是后两个保持开放的生产者规则。每个组成部分都有一个值得命名的先行词。
Jerry Liu 的“Files Are All You Need”(LlamaIndex,2026 年 1 月)将文件系统检索作为向量存储检索的替代方案;矩阵完全存在于文件系统中。人类技能(Zhang 和 Murag,“不要构建代理,而是构建技能”,AI 工程师演讲,2026)将程序知识打包为文件分发的工件;矩阵使用相同的调度模式,但调度目标“主要”是预先计划的源蒸馏而不是工作流程步骤。 (技能可以同时包含散文和程序;区别在于发送的工件主要用于。)
Karpathy 的“LLM Wiki”(要点,2026 年 4 月 4 日)提出,随着新来源的到来,LLM 逐步维护一个包含实体页面、概念页面和索引的 Markdown Wiki,将簿记成本从人力转移到人力LLM。黑曜石为IDE;人类浏览,LLM 写入。相同的承载观察(摄取时间投影复合;查询时间重新推导则不然)驱动这两种设计。
收敛是独立的(矩阵先于要点,如上所述);这里的提及归功于公开表达,并标志着评估轮次所显示的三个架构差异。
LLM 生产的人工制品是为 LLM 打造的,而不是为人类打造的。 wiki 模式的前提是 LLM- 维护的 wiki“也是”人类读者可导航的知识产品。这在源语料库和运行时问题之间引入了一个人类可读的中介,对于浏览很有用,但它增加了一个在查询时不会回报的层,并将人工制品转向令人愉快的浏览而不是有效检索的方向。该矩阵的深度引用、轻度引用、蒸馏和策划路由索引是为“助手”在查询期间使用而设计的:深层引用带有带有证据标记的逐字引用([V]/[AP]/[AR]/[AE]/[BT]),轻度引用是阅读预算形状的,蒸馏被预先投影到任务域上,索引是策展人构建的路由器。人类读取的是答案,而不是人工制品。运行时路径是源→矩阵蒸馏→助手→答案,其中wiki路径是源→wiki→人类→助手→答案。削减人类可读的中介是负载的简化。
该矩阵添加了任务轴。维基百科是围绕一个知识领域(用户的兴趣)构建的。该矩阵具有一个参考轴和 N 个任务投影:相同的源、不同的任务读数、在摄取时预先计算。以 Karpathy 风格构建的教练 wiki 和决策 wiki 将是两个独立的 wiki,共享源内容但重复记账。该矩阵有一个源语料库为 N 个下游应用程序提供服务,且没有重复。
该矩阵编译了可缩小语料库的可分发应用程序。 npm run build 生成已发布的范围内的应用程序:决策应用程序通过其运行时路由器承载决策投影; 利益相关者应用程序承载利益相关者参与预测;参考层作为共享审计记录保留在上游。每个应用程序都有自己的捆绑 CLAUDE.md、自己的捆绑技能以及自己的缩小表面,其大小适合操作员正在处理的任务域。完整的语料库位于上游。维基百科是个人作品;矩阵切片是一个可交付的应用程序。 builds.yaml 和 build.js 的构建系统使这个具体化:相同的矩阵,多个编译的助手,在发布时进行范围过滤。这就是生产端的差异:wiki 是积累的;矩阵累积并运送。
纪律是最后一个区别。 wiki 模式命名了簿记问题;它没有指出源保真度问题。 9-pass 协议的 Pass I(仅源审计)是对 docs/architecture/llm-epistemology.md 中的 LLM-epistemology 问题的体系结构响应:没有仅源纪律,LLM-maintained wiki 会向顾问频率漂移,这意味着其训练数据已经携带了。审计阻止了 wiki 模式成为其要解决的问题的巧妙实例。
Google 的开放知识格式(OKF,Apache-2.0,2026 年 6 月 12 日发布;撰写本文时为 v0.2)是迄今为止最强大的融合,并且是第一个来自平台供应商而不是从业者的融合:知识作为 Markdown 概念文件的捆绑包提供YAML frontmatter、标准降价交叉链接、用于渐进公开的保留 index.md 路由器以及优于嵌入检索的确定性导航。这是该存储库已经运行的底层(如上所述,将于 2026 年 2 月 15 日投入生产;收敛是独立的)。区别在于规范停止的地方。 OKF 指定了“容器”,并且对“生产者”保持沉默:其中没有说明概念文件是如何制作的、其声明追踪到什么,或者如何捕获偏差——而 Google 的参考生产者是 LLM 元数据的 LLM 浓缩代理,没有仅源审计。容器争论正在解决;生产者纪律是一个悬而未决的问题,也是本回购协议所涉及的部分。现在它也是测量的部分:在其 BigQuery 主域之外的散文源上运行,参考制作者铸造了零引用,直到该轮的操作员调整了其重用门,并且在完全匹配时,9 遍层提取了 1.7 倍的声明,并且没有检测到错误率差异(与该轮)。
因此,该构建将 OKF 视为出口,而不是竞争对手。从 v0.4.0 中,任何配置文件都可以“发出”其门控输出作为一致的 OKF v0.2 捆绑包 — 证据标记、每个源许可证清单和带内出处 frontmatter,针对社区 okf CLI 进行验证 — 以及已发布的matrix 捆绑在一棵树中携带同一 28 个源语料库的所有五个任务轴,将任务轴(OKF 的每个概念一个文件模型缺乏的维度)表示为目录结构。一致性是一个容器属性;这个回购协议背后有一个经过审计的生产者。完整的参数在 docs/architecture/okf-interop.md 中; docs/architecture/decisions-and-non-decisions.md 决定从经过审核的蒸馏中排放而不是分叉未经审核的生产商。
RAG+(Wang 等人,“RAG+:通过应用程序感知推理增强检索增强生成”,EMNLP 2025)在标准中添加了一个应用程序步骤RAG,在查询时检索使用示例以及源块。该矩阵将相同的应用步骤从检索时间移动到摄取时间:从源到任务的投影在 9 遍协议下生成一次,根据源进行审核,并在运行时直接读取。成本曲线框架位于 docs/architecture/projection-time.md 中。
文献中的三个近邻值得从这部作品中命名和区分。
Cyc 风格的微观理论(Lenat 和 Marcus,从生成型 AI 到可信赖的 AI:LLMs 可以从 Cyc 学到什么, arXiv:2308.04445, 2023)。 Cyc 的微观理论在共享逻辑知识库中划分断言上下文;同一命题可以在一种微观理论中成立,而在另一种微观理论中则不然,并具有明确的提升规则来在它们之间移动断言。 Lenat 和 Marcus 认为,用 Cyc 风格的符号推理增强的 LLM 可以限制 LLM 的生成,以应对其训练数据中的逻辑矛盾。矩阵是一个不同的赌注:任务轴投影是从散文来源衍生的自然语言蒸馏,其中 Cyc 的微观理论是根据上下文划分的逻辑断言。矩阵与 Cyc 共享的是“时间”姿态——工作转移到摄取时间,因此不必在查询时重新完成——其中矩阵的任务轴划分共享散文语料库的任务形投影,而 Cyc 的微理论划分共享逻辑知识库内断言的上下文。基材不同,分区规则不同;承载收敛是在摄取时间预计算上的。
克兰西的 NEOMYCIN- 风格的战略与领域知识分离(克兰西,从 GUIDON 到 NEOMYCIN 和 HERACLES 的二十个简短课程,AI 杂志 7(3),1986)。 NEOMYCIN的架构见解是将诊断策略从规则库提升到单独的知识层(HERACLES shell),因此相同的策略知识可以驱动不同的领域知识库。矩阵的两个轴是源和任务,其中NEOMYCIN的划分是战略和域。 NEOMYCIN 的通用性从未在教学解释环境之外实现预期的重用;该矩阵通过将投影绑定到特定的源任务对而不是沿着抽象的战略与领域的划分来避免同样的陷阱。
随机鹦鹉问题(Bender、Gebru、McMillan-Major 和 Shmitchell、论随机鹦鹉的危险、FAccT 2021)。本德等人。批评是 LLMs 在不理解含义的情况下重现了训练数据的统计模式。 9 遍仅源审计是该架构对此批评的最直接回应:深度引用中的每个声明都可以追溯到操作员选择的源中的一个段落,因此操作员的源选择成为责任单位,而不是先前的训练数据。审计无法验证来源与世界的关系;这仍然是操作员的工作。该矩阵是对本德的部分回答,而不是补救措施。
决定和非决定
考虑并拒绝的选项的简短列表。 docs/architecture/decisions-and-non-decisions.md 中每个项目的完整推理。
- 标准 RAG(在查询时检索并重塑)。当问题空间无限或语料库变化速度快于摄取速度时,这是正确的工具。在已知任务域中重复工作的错误工具,这正是此存储库的目标。
- 默认情况下提供跨编码器重新排序器。综合查询的真实质量提升,真实的安装大小成本(句子转换器+ PyTorch)。标志存在(
--rerank);尚未对该语料库进行评估。想了想,还没测。 - Claude Code 代理团队(实验性多会话编排)。可以在多本书中并行摄取。被拒绝:实验状态、tmux/iTerm2 依赖性以及观众的错误惊叹因素。检索质量是标题,而不是并行编排。会话内子代理已经可以处理这种语料库规模的并行摄取。
- 会话结束时的音频挂钩。可爱,与架构论证正交。出去。
- 演示记录在存储库中发送。操作员主导的针对实时语料库的捕获比脚本输出更具可信度。
setup-chroma.py --check路径提供较小的版本(查询→热门点击,端到端,不需要 Claude Code 调用)。 - 将 Google 的 OKF 参考代理分叉为生产者。 拒绝:BigQuery-shaped 输入,无仅源审核 - 漂移类 Pass I 存在以捕获。该构建会从已经审计的蒸馏中发出 OKF v0.2 捆绑包;格式是容器,9-pass 协议是生产者。
经销范围
许可证管辖归属和派生权; 范围管辖分布。每个深层引用都带有 **Scope:** 行,并且 builds.yaml 中的每个构建配置文件都声明了 max_scope 上限。范围超出配置文件上限的引用将在构建时被排除。五个级别,单调风险梯度:
| 排名 | 适用范围 | 这里有什么 |
|---|---|---|
| 0 | open |
公共域,CC0,CC BY,CC BY-SA,MIT,Apache,正府工作 |
| 1 | open-nc |
CC BY-NC、CC BY-NC-SA,开放但非商业限制 |
| 2 | copyrighted |
已发布的保留所有权利的材料,operator/org 可以合法访问 |
| 3 | confidential |
有限访问参与材料(客户文档、过去的 AARs、事件数据) |
| 4 | personal |
经营者自己的私人笔记、日记、草稿;绝不在任何配置文件中发货 |
演示配置文件默认为 max_scope: open-nc,与 OpenStax + 补充 CC 源相匹配。该机制在此配置中是“潜在的”(没有超过上限),但它适用于将机密客户端材料与公共 CC 源混合的分叉。 personal 被构造排除:没有 max_scope 值承认它。
npm run package 将相同的机制扩展到已发布的 tarball 中:每个 tarball 的文件名在其捆绑引用 (decision-v0.4.0-open-nc.tar.gz) 中携带最严格的范围,并且 tarball 附带 LICENCE-MANIFEST.md 列出每个引用的单独范围和许可证。发出的 OKF 捆绑包具有相同的机制 - 许可证清单在每个捆绑包内部传输,并且 node scripts/package.js {profile} --okf 生成相同的范围标记 tarball 形式。完整参考位于 docs/reference/scope-taxonomy.md。
关于版权的说明
作者不是律师;帮助构建这个的 AI 也不是。回购协议中没有任何内容是法律建议。构建系统和摄取协议是中立的基础设施。某些使用模式(内部知识库、个人图书馆、CC-BY 材料的分发)不太可能提出这个问题;未经许可即可分发源自受版权保护的来源的制品,具体方式取决于运营商的管辖范围和情况。请参阅 docs/architecture/copyright.md 以及 DISCLAIMER.md 上的完整保修免责声明。
仓库布局
grounded-forge/
├── build.js                    # Build script
├── builds.yaml                 # Profile definitions
├── package.json
├── docs/
│   ├── tutorial/               # Learn-by-doing walkthroughs (querying-the-library, ingesting-one-source, …)
│   ├── how-to/                 # Task-oriented guides (build-your-library, …)
│   ├── reference/              # Lookup material (vocabulary, known-limitations, …)
│   ├── architecture/           # Explanations of why the matrix works the way it does
│   └── evals/                  # Methodology + judge protocol for the comparative method eval
├── corpus.commons/
│   └── demo/                   # The OpenStax demo corpus
│       ├── references/         # Light + deep references (the reference axis)
│       ├── distillations/      # Task projections (the task axis)
│       ├── lenses/             # Per-distillation modifier specs
│       ├── sources/            # original/ + converted/ + ingest/
│       ├── tasks/              # Task-axis specs (operator-inspection)
│       ├── build-profiles/     # CLAUDE.md templates per shipped profile (corpus-bound)
│       ├── .claude/agents/     # Corpus-bound runtime agents
│       ├── apps/               # Compiled apps per build profile
│       ├── okf/                # Emitted OKF v0.2 interchange bundles (per app + full-matrix)
│       └── distros/            # Packaged tarballs from `npm run package`
├── corpus.local/               # gitignored: your private corpora
├── .claude/skills/             # Substrate authoring + runtime skills (corpus-agnostic)
├── scripts/                    # Build helpers (package.js, create-corpus.py, setup-chroma.py, …)
└── tests/audit-fixtures/       # Pass I calibration + regression fixtures
此版本附带了 28 个源演示语料库、五个任务轴(117 个蒸馏,有 23 个显式 Pass G 跳过)、镜头库、六个经过验证的 OKF v0.2 交换捆绑包(每个应用程序配置文件一个加上全矩阵 matrix 捆绑包)、语义搜索后端和打包工具。默认情况下,矩阵保持二维;操作员可以在每次蒸馏时选择加入镜头。其背后的生产者纪律经过基准测试,其发布的语料库经过审计,回购收据:,头对头回合和,审计记录。