将MySQL数据库同步到另一台服务器的四种做法实用指南
平时做技术实践时,很多问题不是概念不会,而是细节没串起来。拿“将MySQL数据库同步到另一台服务器的四种做法”来说,它看着像小点,放到项目里常会牵出环境、配置、兼容性和维护成本。下面按实际采用顺序,把思路、关键写法和容易踩坑的地方讲清楚,便于大家直接对照操作。
引言
落到代码里,保持服务器之间的数据一致性是 MySQL 管理员面临的常用挑战。无论你是要迁移到云端、扩展读取能力,还是设置灾难恢复,都需一种可靠的方式将 MySQL 数据库同步到另一台服务器。
理解这一步时,正确的方法取决于你的环境。一次性脚本可能适用来预发布环境,但生产系统通常需持续、低延迟的复制。
落到代码里,本指南涵盖四种在两个 MySQL 数据库之间同步数据的实用方法,从命令行工具到原生复制和企业级同步解决方案。
为什么要将 MySQL 数据库同步到另一台服务器?
正确的方法取决于目标、网络和数据量。以下是最常用的场景。
一次性迁移 完整传输且无持续链接,通常用来迁移到新服务器或云服务商。
只读副本和扩展 从实现思路看,将读取查询分流到辅助服务器,使主服务器专注于写入。依赖同步或异步复制来保持更新。
实时分析和报表 结合项目来看,将数据复制到单独的服务器,以便 BI 工具能够查询数据而不拖慢生产系统。
灾难恢复 保持备用数据库随时待命,以便在主服务器宕机时接管。
同步前检查清单:开始前需确认的事项
在开始同步前进行几项检查,能够节省大量后续排查时间。
- 同步表上的稳定主键:每个表都需主键或唯一、非空索引,以便识别行。如果没有主键,复制延迟会增加,持续同步期间的冲突解决也会变得更困难。
- 网络和防火墙访问:确认目标服务器能够访问源服务器,通常需在两台主机之间开放
port 3306端口。 - MySQL 版本匹配或兼容:采用
SELECT VERSION();检查两个版本。从较旧版本复制到较新版本通常没问题,但反过来往往会导致兼容性错误。 - 当前数据库备份:在运行任何同步工具之前,先对源数据库进行完整备份;如果你需企业级保护,能够采用类似 i2Backup 的工具。这样如果脚本行为异常或覆盖生产数据,你还有一个恢复点。
将 MySQL 数据库同步到另一台服务器的 4 种方法
实际处理时,最佳方法取决于数据库大小、可接受的停机时间和管理员技能水平。下面更快比较这四种方法。
| 方法 | 同步类型 | 最佳采用场景 | 管理员工作量 |
|---|---|---|---|
| mysqldump | 一次性 | 小型迁移、本地备份、小型 schema | 低 |
| MySQL Workbench | 可视化手动同步 | Schema 比较、手动传输 | 低到中 |
| 原生复制 | 持续 | 高可用性、只读副本、生产扩展 | 高 |
| 企业级工具 | 持续 / 实时 | 跨区域、零停机、复杂网络拓扑 | 中到高 |
方法 1:采用 mysqldump 进行一次性复制(迁移)
从实现思路看,采用 mysqldump 导出 MySQL 数据库 是一次性迁移中移动数据的标准方式。这个命令行工具会将 schema 和数据导出为包含 SQL 语句的文件。由于它捕获的是静态快照,所以新建 dump 之后所做的任何更改都不会包含在内。
步骤 1. 导出源数据库
在源服务器上运行 mysqldump,将数据库导出为 .sql 文件。对于 InnoDB 表,建议采用 --single-transaction 标志,以避免锁定正在采用的生产数据。
mysqldump -u root -p --single-transaction --databases my_database > db_dump.sql
步骤 2. 传输 dump 文件
从实现思路看,采用安全的传输方式将导出的文件移动到目标服务器。 scp 或 rsync 都适合此操作。
scp db_dump.sql user@target_server_ip:/tmp/
步骤 3. 导入到目标服务器
登录目标服务器,采用 mysql 客户端加载 SQL 文件同时重建数据库。
mysql -u root -p < /tmp/db_dump.sql
为慢速网络压缩大型 dump 文件
理解这一步时,对于较大的数据库,在传输前压缩 dump 文件能够缩短传输时间。最轻松的方法是将输出直接借助 gzip 管道处理:
mysqldump -u root -p --single-transaction --databases my_database | gzip > db_dump.sql.gz
在目标端,能够在单个管道中解压同时导入,以节省本地磁盘空间:
gunzip < db_dump.sql.gz | mysql -u root -p
注意:--compress 标志仅在 dump 过程中压缩客户端和服务器之间的流量。它不会缩小输出文件,同时且从 MySQL 8.0.18 起已弃用。借助 gzip 管道处理是减小传输文件大小的更可靠方式。
何时不要采用此方法
实际处理时,此方法不适合高流量、活跃的生产数据库,因为它无法提供持续更新。大型数据库可能需数小时才能 dump 和恢复,这意味着迁移切换期间会有显著停机时间。需持续同步或最小停机的团队应考虑复制。
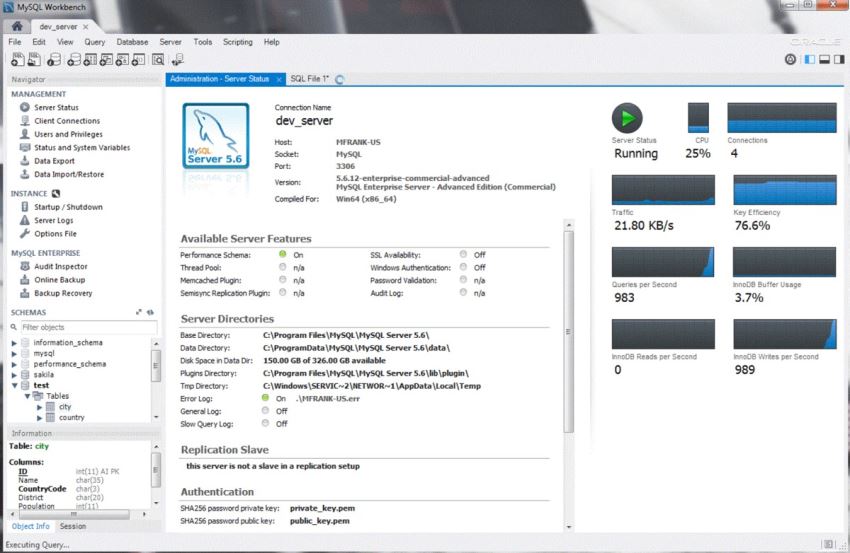
方法 2:采用 MySQL Workbench 进行图形化同步(无需命令行)
落到代码里,MySQL Workbench 提供图形界面,无需编写命令行参数即可在两个 MySQL 数据库之间同步数据。其向导会引导你以可视化方式复制 schema 结构和行。此方法最适合较小的数据集和非生产系统。
步骤 1. 设置到两台服务器的连接
- 启动 MySQL Workbench,点击 MySQL Connections 旁边的 + 图标。
- 输入源服务器的主机名、用户名和密码,然后点击 Test Connection。
- 重复该过程,为目标服务器新建第二个连接设置。
- 在继续之前确认两个连接都成功。
步骤 2. 导出源数据库
- 打开源连接,在 Navigator 侧边栏中选择 Data Export。
- 选择要复制的 schema。
- 选择 Export to Self-Contained File。
- 点击 Start Export。
步骤 3. 导入到目标服务器
- 打开目标连接。
- 选择 Data Import/Restore。
- 选择步骤 2 中新建的导出文件。
- 点击 Start Import 以重建 schema 并加载数据。
步骤 4. 比较并同步后续 schema 更改
- 打开 Database 菜单。
- 选择 Synchronize with Any Source 进行实时到实时比较,或者如果要与 EER 模型比较,则选择 Synchronize Model。
- 选择源和目标 schema,然后点击 Compare。
- 查看差异报告,并取消选择你不想应用的任何更改。
- 点击 Generate Script 理解这一步时,生成对齐 schema 所需的
ALTER语句,随后对目标运行该脚本。
注意:Compare Schemas 本身只会生成只读差异报告。要生成同时运行实际的同步脚本,请改用 Synchronize with Any Source 或 Synchronize Model。
操作范围和限制 在这个场景下,此图形化选项适合偏好 GUI 的开发人员和后端工程师,或者用来开发与预发布环境之间的一次性同步。它同时非为实时生产同步而构建。比较大型 schema 可能会拖慢应用程序,而手动同步无法提供实时系统所需的自动化、近乎即时的恢复点。
方法 3:原生 MySQL 复制(持续同步 / 只读副本)
从实现思路看,MySQL 复制是一项原生功能,能够持续将更改从源服务器流式传输到一个或多个副本服务器。它依赖二进制日志来跟踪更新,所以很适合扩展读取、构建分析环境或设置灾难恢复。
前提条件 两台服务器都需在 my.cnf 或 my.ini 文件中设置唯一的 server-id。源服务器需启用二进制日志,同时且两端都需借助 port 3306 进行网络访问。
步骤 1. 设置源服务器
- 在这个场景下,在源服务器上打开 MySQL 设置文件(Linux 上为
/etc/my.cnf)。 - 在
[mysqld]块下,分配唯一的server-id。 - 采用
log-bin启用二进制日志。 - 可选地采用
binlog_do_db将复制限制到特定 schema。
server-id = 1
log-bin = mysql-bin
binlog_do_db = my_database
保存文件并重启 MySQL 服务以应用更改。
步骤 2. 新建复制用户 理解这一步时,登录源服务器,为副本新建专用账户。此用户只需 REPLICATION SLAVE 权限来连接同时读取二进制日志。
CREATE USER 'repl_user'@'%' IDENTIFIED BY 'StrongPassword123';
GRANT REPLICATION SLAVE ON *.* TO 'repl_user'@'%';
FLUSH PRIVILEGES;
步骤 3. 拿到一致性快照并记录日志位置
- 锁定源表以暂停写入。
- 在另一个会话里,检查当前二进制日志文件和位置。
FLUSH TABLES WITH READ LOCK;
SHOW MASTER STATUS;
- 在锁仍然生效时,采用
mysqldump导出数据库。 - 导出完成后解锁表。
UNLOCK TABLES;
注意:落到代码里,若启用了 GTID(全局事务标识符),MySQL 会自动跟踪事务,所以能够跳过手动记录日志文件和位置。
步骤 4. 设置副本
- 将步骤 3 中的 dump 导入副本服务器。
- 采用
CHANGE REPLICATION SOURCE TO将副本指向源。
CHANGE REPLICATION SOURCE TO
  SOURCE_HOST = 'primary_server_ip',
  SOURCE_USER = 'repl_user',
  SOURCE_PASSWORD = 'StrongPassword123',
  SOURCE_LOG_FILE = 'mysql-bin.000001',
  SOURCE_LOG_POS = 154;
步骤 5. 启动复制并验证
- 启动复制线程。
- 检查状态输出。
START REPLICA;
SHOW REPLICA STATUSG
- 确认
Replica_IO_Running和Replica_SQL_Running都显示Yes。
MySQL 8.0+ 语法与旧术语 在这个场景下,MySQL 8.0.22 及更高版本在复制命令中替换了 master 和 slave 等术语。 CHANGE REPLICATION SOURCE TO 取代了 CHANGE MASTER TO, SHOW REPLICA STATUS 取代了 SHOW SLAVE STATUS。旧语法在当前版本中仍可向后兼容,但对于已升级的环境,现代命令是更安全的选择。
方法 4:企业级复制工具(跨区域 / 零数据丢失同步)
结合项目来看,原生复制适用来轻松的设置,但在跨云区域或异构数据库时可能会吃力,尤其是在高写入负载下。当你需具有亚秒级 RPO 的零数据丢失同步,或用来合规的详细审计日志时,仅靠原生工具往往不够。
关键评估标准
- RPO 和 RTO 目标:根据你的业务能够容忍多少数据丢失和停机时间来选择工具。
- 无代理与基于代理的部署:代理运行在主机上;无代理工具远程读取日志。要考虑对性能和安全策略的影响。
- DDL 和 DML 同步兼容:确认工具不仅同步行级插入、更新和删除,还能同步 schema 更改。
- 延迟告警和坚控:寻找实时仪表板以及延迟超过阈值时的告警。
像 i2Stream 为原生 MySQL 复制能力不足的场景而构建。
- 无代理、基于日志的架构:直接从数据库日志捕获事务,无需在生产服务器上安装软件,也不会产生可测量的性能影响。
- 广泛的跨平台兼容:可在 40 多种数据库和平台组合之间同步,包括 MySQL、MariaDB、PostgreSQL、Oracle 和 SQL Server,适合将 MySQL 同步到不同引擎用来分析的团队。
- 接近零 RPO、分钟级 RTO:专为级灾难恢复而构建,兼容主动-主动和多站点架构,保持事务级一致性同时自动解决冲突。
- 集成 DDL/DML 同步:添加列等 schema 更改会与常规数据更新一起同步,所以结构变化不会破坏正在进行的复制流。
- 亚秒级延迟告警:统一仪表板实时跟踪吞吐量、延迟和错误,同时借助自动校验和验证及早发现数据漂移。
同步 MySQL 数据库时的常用问题及修复方法
结合项目来看,同步设置往往会遇到一些反复出现的问题。以下是这些问题的原因以及各自的修复方法。
复制延迟
结合项目来看,目标服务器无法跟上来自源的传入更改。这通常由单线程执行、高写入负载或目标端磁盘硬件较慢引起。
采用 replica_parallel_workers (在较旧版本上为 slave_parallel_workers)启用多线程复制,同时采用 binlog_format = ROW 的行级日志,以便目标端能够更快地应用更改。
批量同步中缺失删除和更新
大多数批量脚本采用类似 updated_at 的时间戳列查询源,但被删除的行不会留下任何痕迹供脚本捕获。
改用带有 is_deleted 列的软删除,或定期运行全表比较以捕获孤立行。
Schema 更改破坏同步
理解这一步时,若源上添加或删除了列,而副本失去对齐,复制线程一旦遇到引用本地不存在列的查询就会停止。
落到代码里,先在副本上应用匹配的 schema 更改,或采用可避免锁表的在线 schema 迁移工具。
双向设置中的复制循环
在这个场景下,主动-主动设置可能会陷入循环,事务会在两台服务器之间无休止地来回反弹,因为它们无法区分自己的事务和已经接收过的事务。
为每台服务器分配唯一的 server-id 同时启用 GTID(全局事务标识符),这样服务器就能识别并跳过已经处理过的事务。
常用问题
Q1:我能够将 MySQL 同步到不同版本的 MySQL 吗?
在这个场景下,在大多数情况下能够。从较旧版本复制到较新版本通常受兼容,但从较新版本复制到较旧版本往往会导致兼容性错误。在设置同步之前,采用 SELECT VERSION(); 检查两个版本。
Q2:同步 MySQL 数据库会导致停机吗?
这取决于方法。 mysqldump 导出和导入可能会短暂锁表,同时且对于大型数据集 会使数据库离线。原生复制和企业级同步工具在后台持续运行,因此源数据库始终保持在线。
Q3:复制和同步有什么区别?
在这个场景下,复制是持续且基于日志的,将近乎实时地将更改从源流式传输到一个或多个目标。同步是一个更广泛的术语,根据设置方式,它能够指一次性复制、计划批量作业或持续复制。
Q4:我能够只同步特定表而不是整个数据库吗?
能够。 mysqldump 兼容导出单个表,原生复制能够采用 binlog_do_db 或 replicate-do-table 等过滤器限定到特定数据库或表。大多数企业级同步工具也兼容表级过滤。
Q5:mysqldump 对生产数据库安全吗?
是的,在与 --single-transaction 一起采用时是安全的,它能够避免在 dump 期间锁定 InnoDB 表。它不会锁定 MyISAM 等非事务性表,也无法防止在 dump 进行期间运行 schema 更改(DDL)。对于很大的生产数据库,原生复制或企业级工具造成的影响更小。
结论
在这个场景下,将 MySQL 数据库同步到另一台服务器,归根结底是根据目标选择方法。一次性的 mysqldump 适用来轻松迁移,MySQL Workbench 适合较小的 GUI 驱动传输,原生复制处理持续同步和读扩展,而当需求变得更苛刻时,比如跨区域设置或接近零 RPO,企业级工具就会发挥作用。
落到代码里,无论哪种方法适合你的环境,在进行任何更改之前都要先进行完整备份。如果过程中出现复制延迟、schema 不匹配或其他同步问题,上面介绍的修复方法应该能帮助你回到正轨。
结合项目来看,总的来说,MySQL同步到另一台服务器适合结合实际项目边做边理解。先抓住核心思路,再逐步补上细节和边界处理,最后效果会更稳定,也更容易复用。