
DeepSeek多模态怎么样及保姆级配置教程(codex、claude)实用指南
平时做技术实践时,很多问题不是概念不会,而是细节没串起来。拿“DeepSeek多模态怎么样及保姆级配置教程(codex、claude)”来说,它看着像小点,放到项目里常会牵出环境、配置、兼容性和维护成本。下面按实际采用顺序,把思路、关键写法和容易踩坑的地方讲清楚,便于大家直接对照操作。
DeepSeek 多模态终于来了。
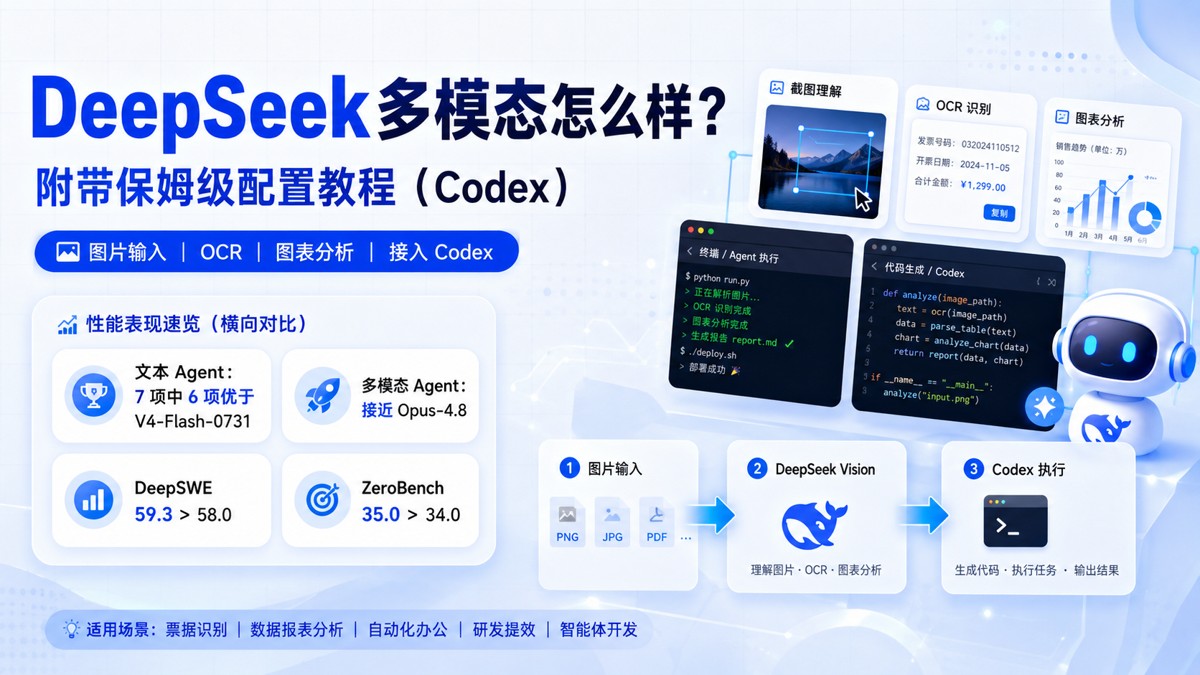
这次上线的是实验性视觉模型:
DeepSeek-V4-Flash-Vision-Exp
API 模型名:
deepseek-v4-flash-vision-exp
它不仅兼容文字,还加入了图片输入、截图理解、OCR、图表分析等能力,并且能够直接接入 Codex。
但问题也来了:
从实现思路看,这个多模态模型到底怎么样?加入视觉能力后,代码和 Agent 能力会不会下降?
一、DeepSeek 多模态到底怎么样?
先看这次公布的 Benchmark。
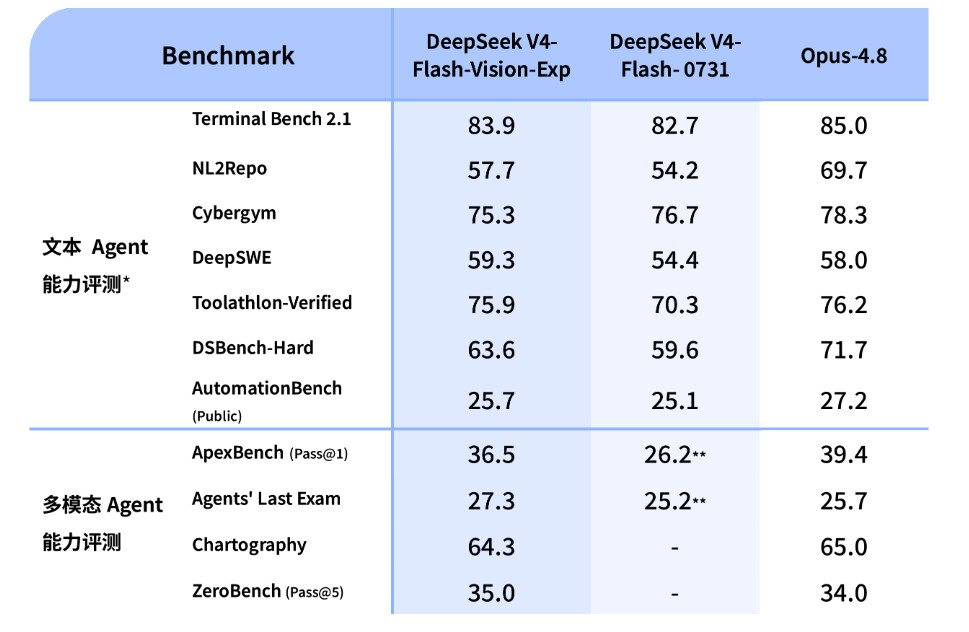
1. 文本 Agent:基本没有因为多模态而“降智”
和 DeepSeek-V4-Flash-0731 相比,Vision-Exp 在 7 项文本 Agent 测试中,6 项成绩更高。
比较明显的有:
| Benchmark | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 83.9 | 82.7 | 85.0 |
| NL2Repo | 57.7 | 54.2 | 69.7 |
| DeepSWE | 59.3 | 54.4 | 58.0 |
| Toolathlon-Verified | 75.9 | 70.3 | 76.2 |
| DSBench-Hard | 63.6 | 59.6 | 71.7 |
其中 DeepSWE 59.3,甚至超过了 Opus-4.8 的 58.0。
Toolathlon-Verified 则达到 75.9 vs 76.2,已经很接近 Opus-4.8。
也就是说:
在这个场景下,DeepSeek 同时没有为了“看图”,明显牺牲原本的文本 Agent 能力。
2. 多模态 Agent:已经摸到 Opus-4.8
真正值得看的还是多模态测试。
| Benchmark | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| ApexBench | 36.5 | 26.2 | 39.4 |
| Agents' Last Exam | 27.3 | 25.2 | 25.7 |
| Chartography | 64.3 | - | 65.0 |
| ZeroBench | 35.0 | - | 34.0 |
这里很有意思。
Agents' Last Exam:
Vision-Exp 27.3
> Opus-4.8 25.7
ZeroBench:
Vision-Exp 35.0
> Opus-4.8 34.0
而 Chartography:
64.3 vs 65.0
几乎已经贴近 Opus-4.8。
所以从这张测试表来看,我对它的评价是:
在这个场景下,文本 Agent 能力没有明显缩水,多模态 Agent 已经进入第一梯队,部分项目甚至超过 Opus-4.8。
实际处理时,当然,这不代表 Vision-Exp 已经“全面超过 Opus-4.8”。
毕竟目前还是 Exp 实验版本,Benchmark 也不能完全代表真实开发体验。
结合项目来看,但作为 DeepSeek 第一个重点面向视觉 Agent 的模型,这个成绩已经相当不错。
二、它对 Codex 有什么用?
以前用 Codex 写代码,碰到:
- IDE 报错截图
- 网页截图
- UI 设计稿
- 数据图表
- 控制台错误
很多时候需自己先整理成文字。
现在能够直接:
图片 / 截图
      ↓
DeepSeek-V4-Flash-Vision-Exp
      ↓
视觉理解 / OCR / 图表分析
      ↓
Codex 分析并执行代码任务
这也是我认为这次更新真正有价值的地方:
AI 不只是读代码,还开始能看开发环境。
三、Codex 保姆级接入 Vision-Exp
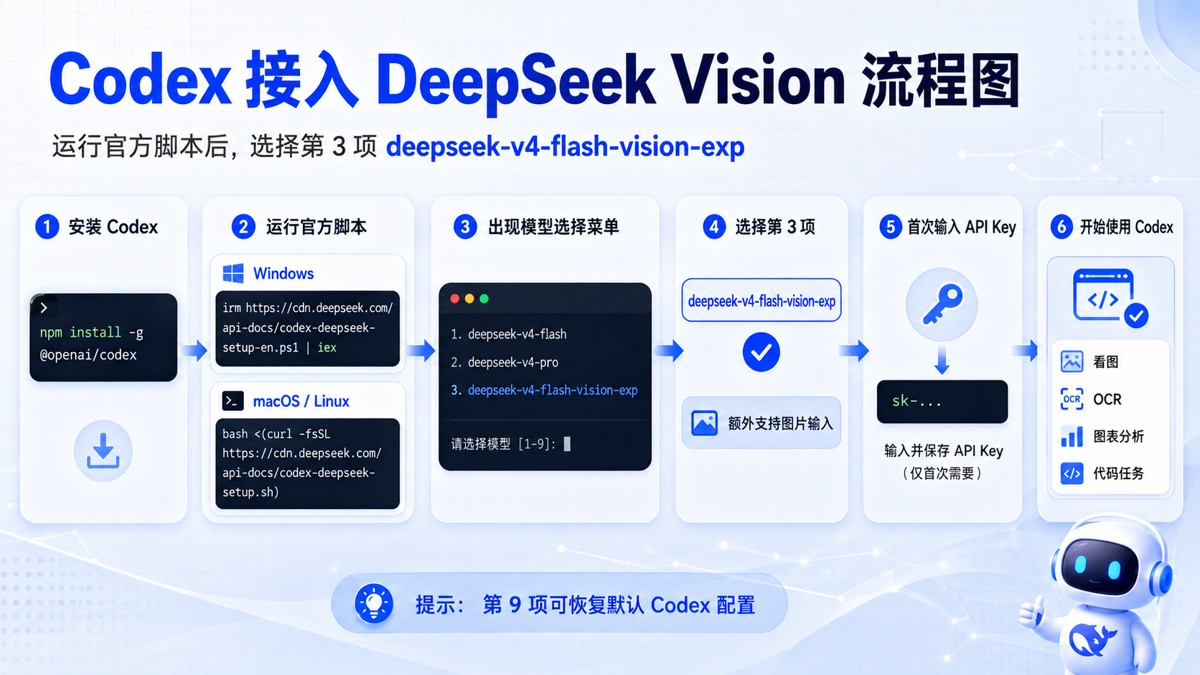
整个流程其实很轻松:
在这个场景下,安装 Codex → 运行官方脚本 → 选择第 3 项 → 输入 API Key。
1. 安装 Codex
确保已经安装 Node.js,然后执行:
npm install -g @openai/codex
检查:
codex --version
2. 运行 DeepSeek 官方脚本
Windows 打开 PowerShell:
irm https://cdn.deepseek.com/api-docs/codex-deepseek-setup-en.ps1 | iex
macOS / Linux:
bash <(curl -fsSL https://cdn.deepseek.com/api-docs/codex-deepseek-setup.sh)
运行后会出现模型选择菜单:
1. deepseek-v4-flash
2. deepseek-v4-pro
3. deepseek-v4-flash-vision-exp
...
9. 恢复默认 Codex 配置
想采用图片输入,直接选择:
3
也就是:
deepseek-v4-flash-vision-exp
第 3 项会额外兼容图片输入。
首次运行会提示输入 DeepSeek API Key:
sk-xxxxxxxxxxxxxxxx
API Key 能够在 DeepSeek Platform 拿到。
整个设置流程就是:
安装 Codex
    ↓
运行官方脚本
    ↓
选择第 3 项
    ↓
deepseek-v4-flash-vision-exp
    ↓
输入 API Key
    ↓
开始使用
若之后想恢复原来的 Codex 设置,重新运行脚本,选择:
第 9 项
即可。
四、实际能够怎么玩?
比如直接把报错截图交给 Codex:
分析这张报错截图,找到错误原因, 并检查当前项目修改对应代码。
或者上传 UI 设计稿:
根据这张 UI 设计稿检查当前页面, 找出样式差异并修改代码。
最后工作流就变成:
看截图 → 理解问题 → 分析代码 → 修改项目 → 验证结果。
总结
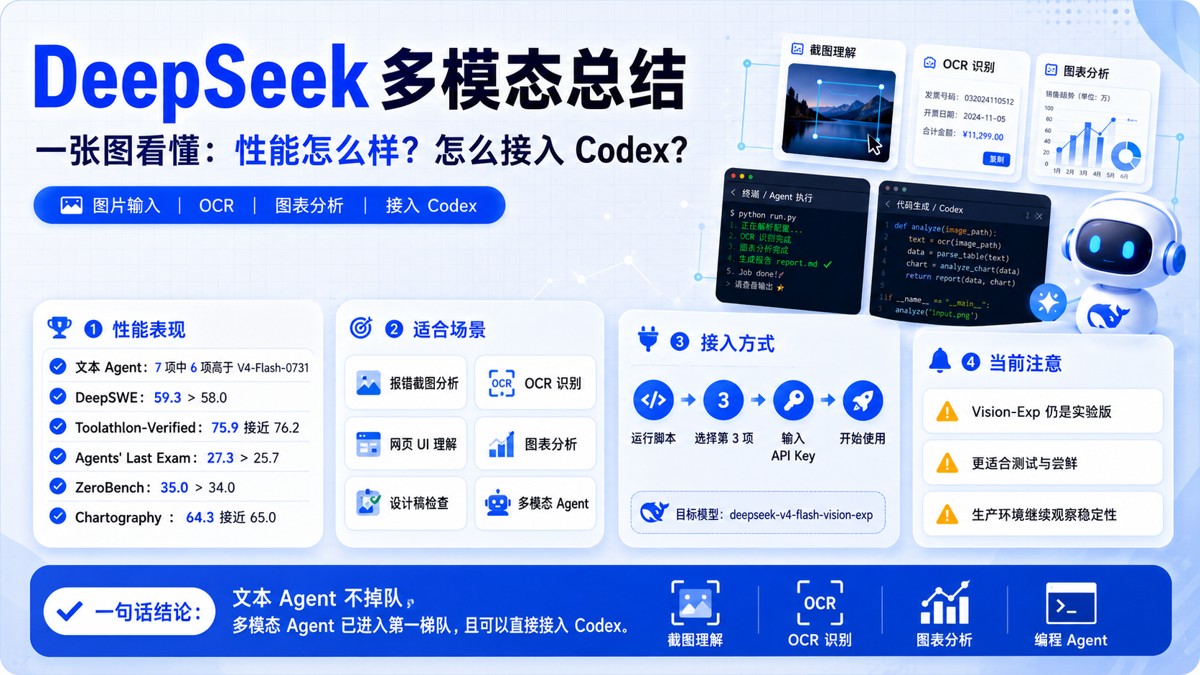
落到代码里,若只看这次 Benchmark,我认为 DeepSeek-V4-Flash-Vision-Exp 的表现比预期更好。
文本 Agent:相比 V4-Flash-0731,大部分测试继续提升。
多模态 Agent:已经接近 Opus-4.8,Agents' Last Exam、ZeroBench 甚至实现反超。
再加上现在能够直接借助官方脚本接入 Codex:
Codex
   +
deepseek-v4-flash-vision-exp
   ↓
多模态 Coding Agent
所以这次同时不是轻松给 DeepSeek 加了一个“看图”功能。
真正值得关注的是:DeepSeek 开始把视觉能力和 Coding Agent 正式结合起来了。
不过 Vision-Exp 目前仍然是实验版本,适合尝鲜和测试,生产环境建议继续观察稳定性。
实际处理时,总的来说,DeepSeek多模态适合结合实际项目边做边理解。先抓住核心思路,再逐步补上细节和边界处理,最后效果会更稳定,也更容易复用。
相关文章
-
DeepSeek多模态怎么样及保姆级配置教程(codex、claude)实用指南
游戏攻略 2026-10-17
-
WSL2+Docker+Ollama本地部署大模型思路和实践指南(Qwen1.8b)实用指南
游戏攻略 2026-10-17
-
DeepSeek Harness热门插件盘点:10个实用插件,覆盖多Agent、上下文和多模态实用指南
游戏攻略 2026-10-17
-
grep文本搜索与正则表达式完整代码示例实用指南
游戏攻略 2026-10-16
-
AI漫剧伪装直男1‑24集无雾版夸克网盘资源免费分享
游戏攻略 2026-10-15
-
AI漫剧玉僧入尘1-68集无雾无删版夸克网盘资源免费分享
游戏攻略 2026-10-15








