模型变小,能力不减:新浪VibeThinker-3B 开源:AI 推理迎来轻量化新思路
作者:袖梨
2026-06-30
人工智能模型的参数量是否一定要“越大越好”?近日,新浪开源的 VibeThinker-3B 模型给出了一份极具启发性的答卷。尽管该模型仅拥有30亿参数,但在数学、编程等高难度基准测试中,它竟然展现出了足以媲美主流百倍规模大模型的强悍性能,甚至在部分竞赛级任务中超越了多款行业顶尖产品。
VibeThinker-3B 的优异表现并非偶然,而是得益于其独特的训练策略。该模型以阿里 Qwen2.5-Coder-3B 为基底,通过多阶段的精细化“后训练”——涵盖了监督微调、强化学习、自蒸馏及指令微调等环节,将大模型的逻辑推理能力深度浓缩进了3B 的轻量化架构中。测试显示,在 LeetCode 竞赛题目中,它能高效完成128道题中的123道,这一成绩已超过了 GPT-5.2等行业标杆。

目前,VibeThinker-3B 已在Hugging Face和GitHub正式开源。这一动作不仅为开发者提供了一个轻量且高效的工具选择,也为 AI 行业提供了一种全新的优化范式:在特定任务领域,通过精耕细作的后训练,或许能以极低的算力成本,换取堪比“行业巨头”的推理体验。
相关文章
-
用 Go 从零实现 Claude Code(二):命令行循环与对话记忆
游戏攻略 2026-09-20
-
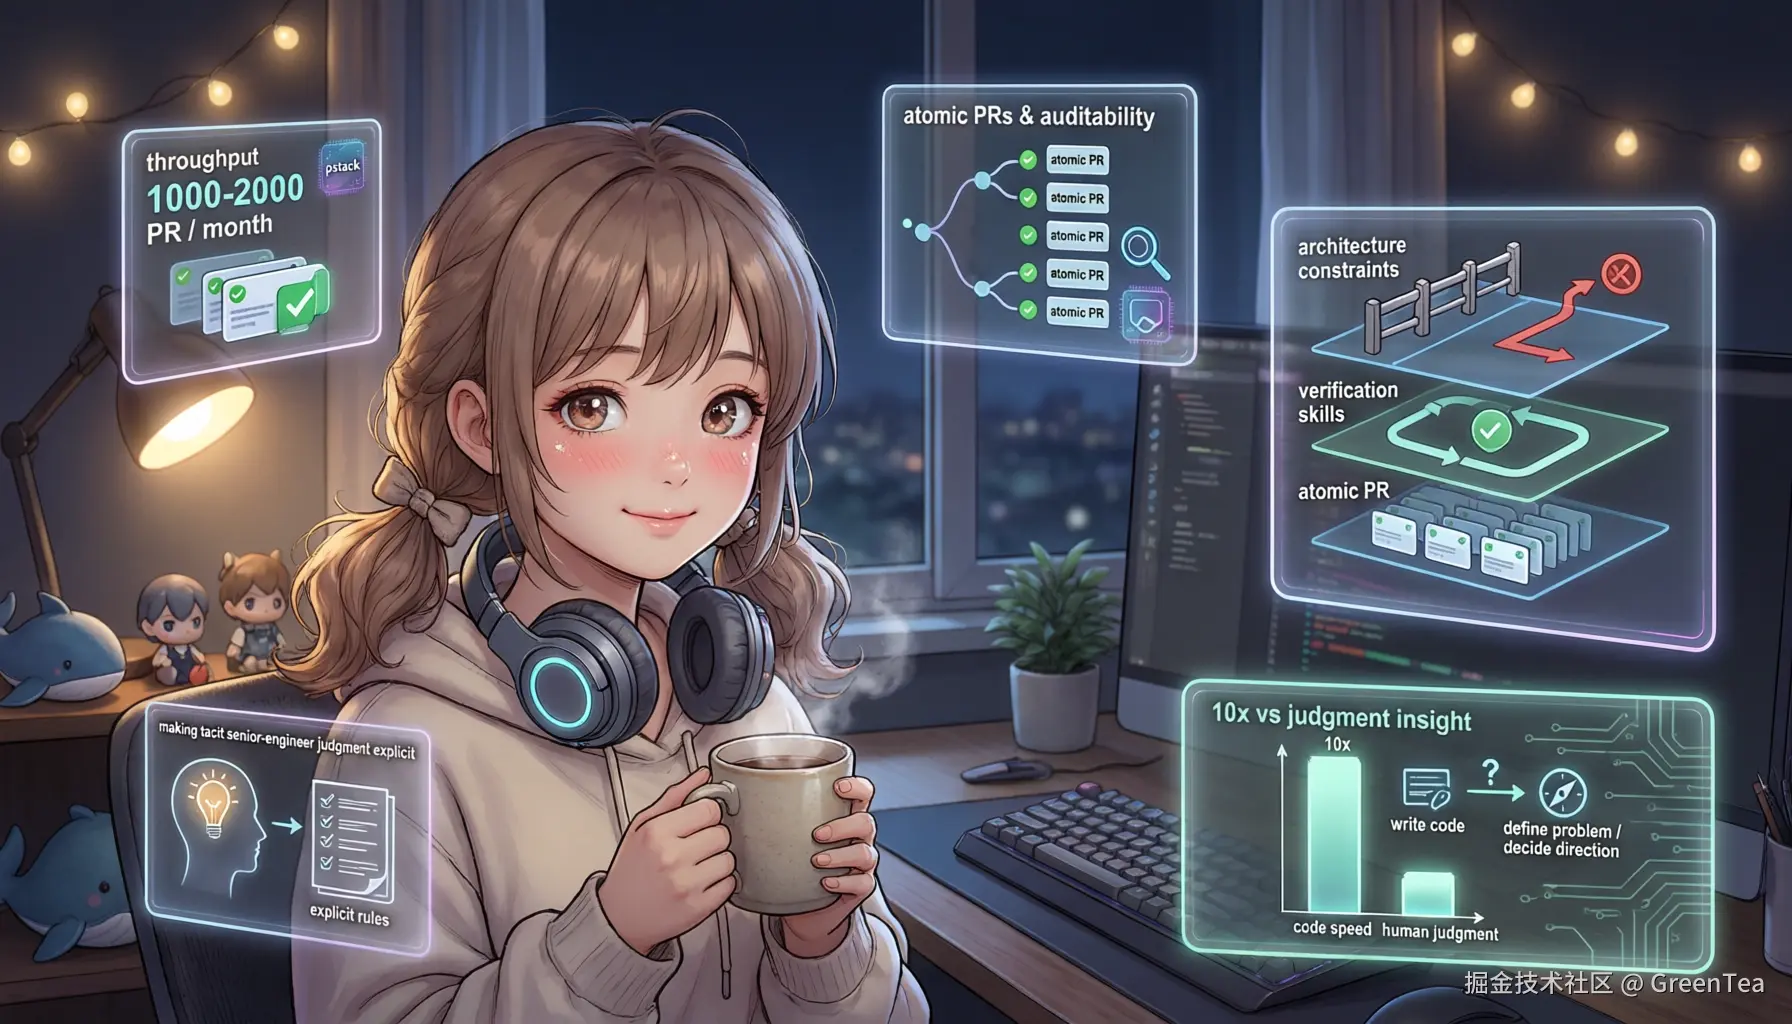
GrokBot 核心成员 Lauren Tan:用 AI 实现每月 2000 个 PR 的工程方法
游戏攻略 2026-09-20
-
企业级 Agent Memory 架构选型:可扩展 Memory Service 如何设计
游戏攻略 2026-09-20
-
Codex 出手:成功拦截网站异常爬虫
游戏攻略 2026-09-20
-
Memory Provider 架构实战:拆解 Hermes、Mem0、Honcho 与 Hindsight 的共同设计
游戏攻略 2026-09-20
-
用Jev构建“智能if”:一次请求完成3项判断与置信度路由
游戏攻略 2026-09-20