Codex 出手:成功拦截网站异常爬虫
网站流量短时间内从每日千余 IP 飙升至数万,看似是增长信号,实际却可能意味着爬虫正在消耗资源并批量抓取内容。面对会修改请求特征、模拟正常浏览器的异常流量,单靠一条 User-Agent 规则并不够。接下来将还原如何借助 Codex 制定分层策略、执行配置并用真实数据验证拦截效果。
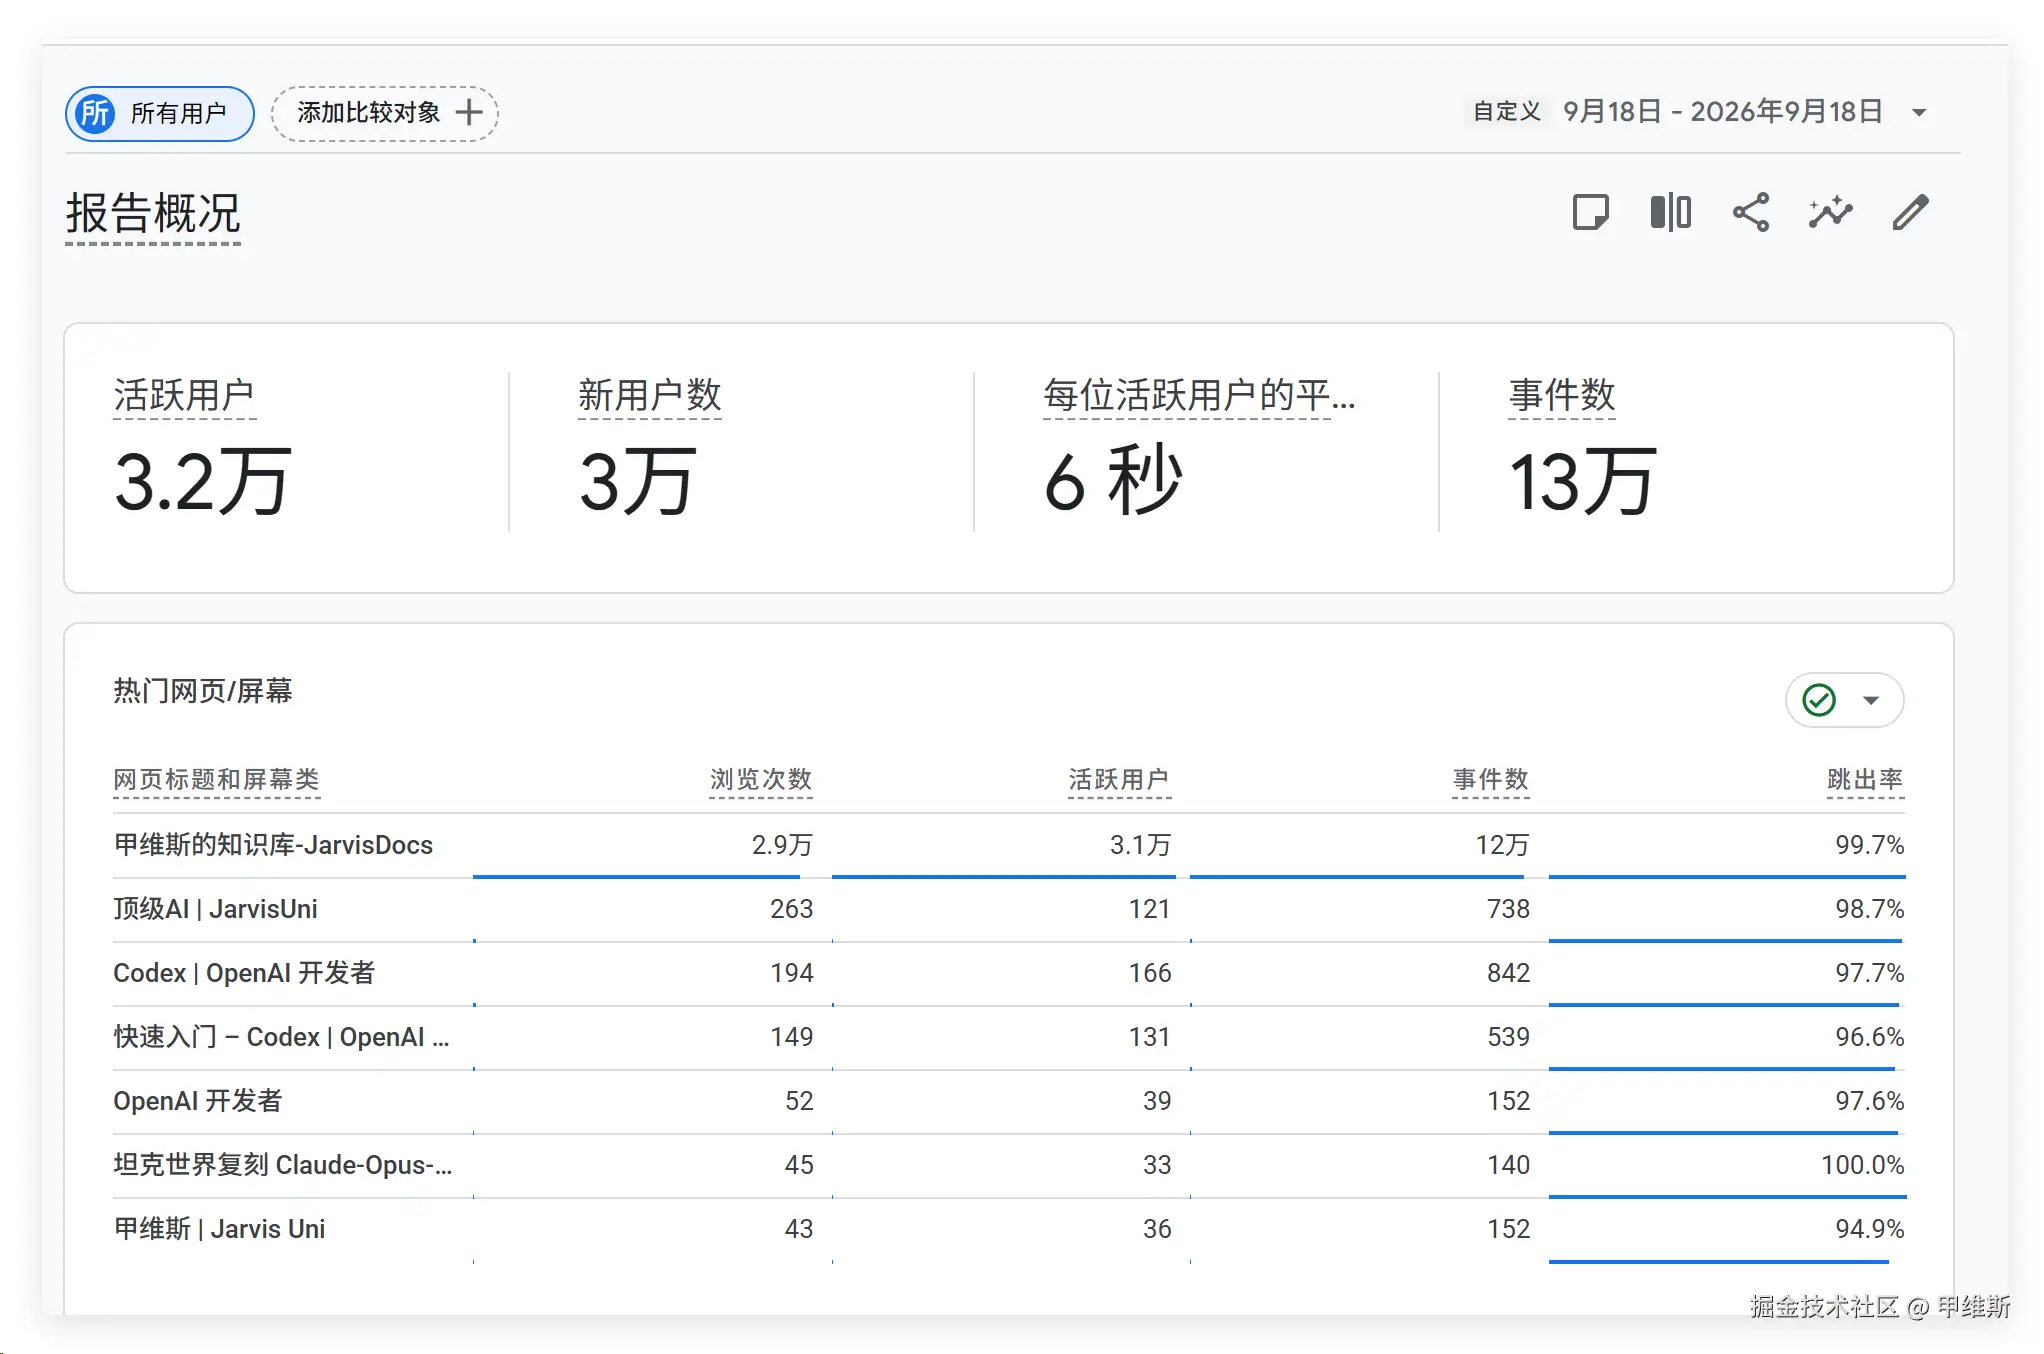
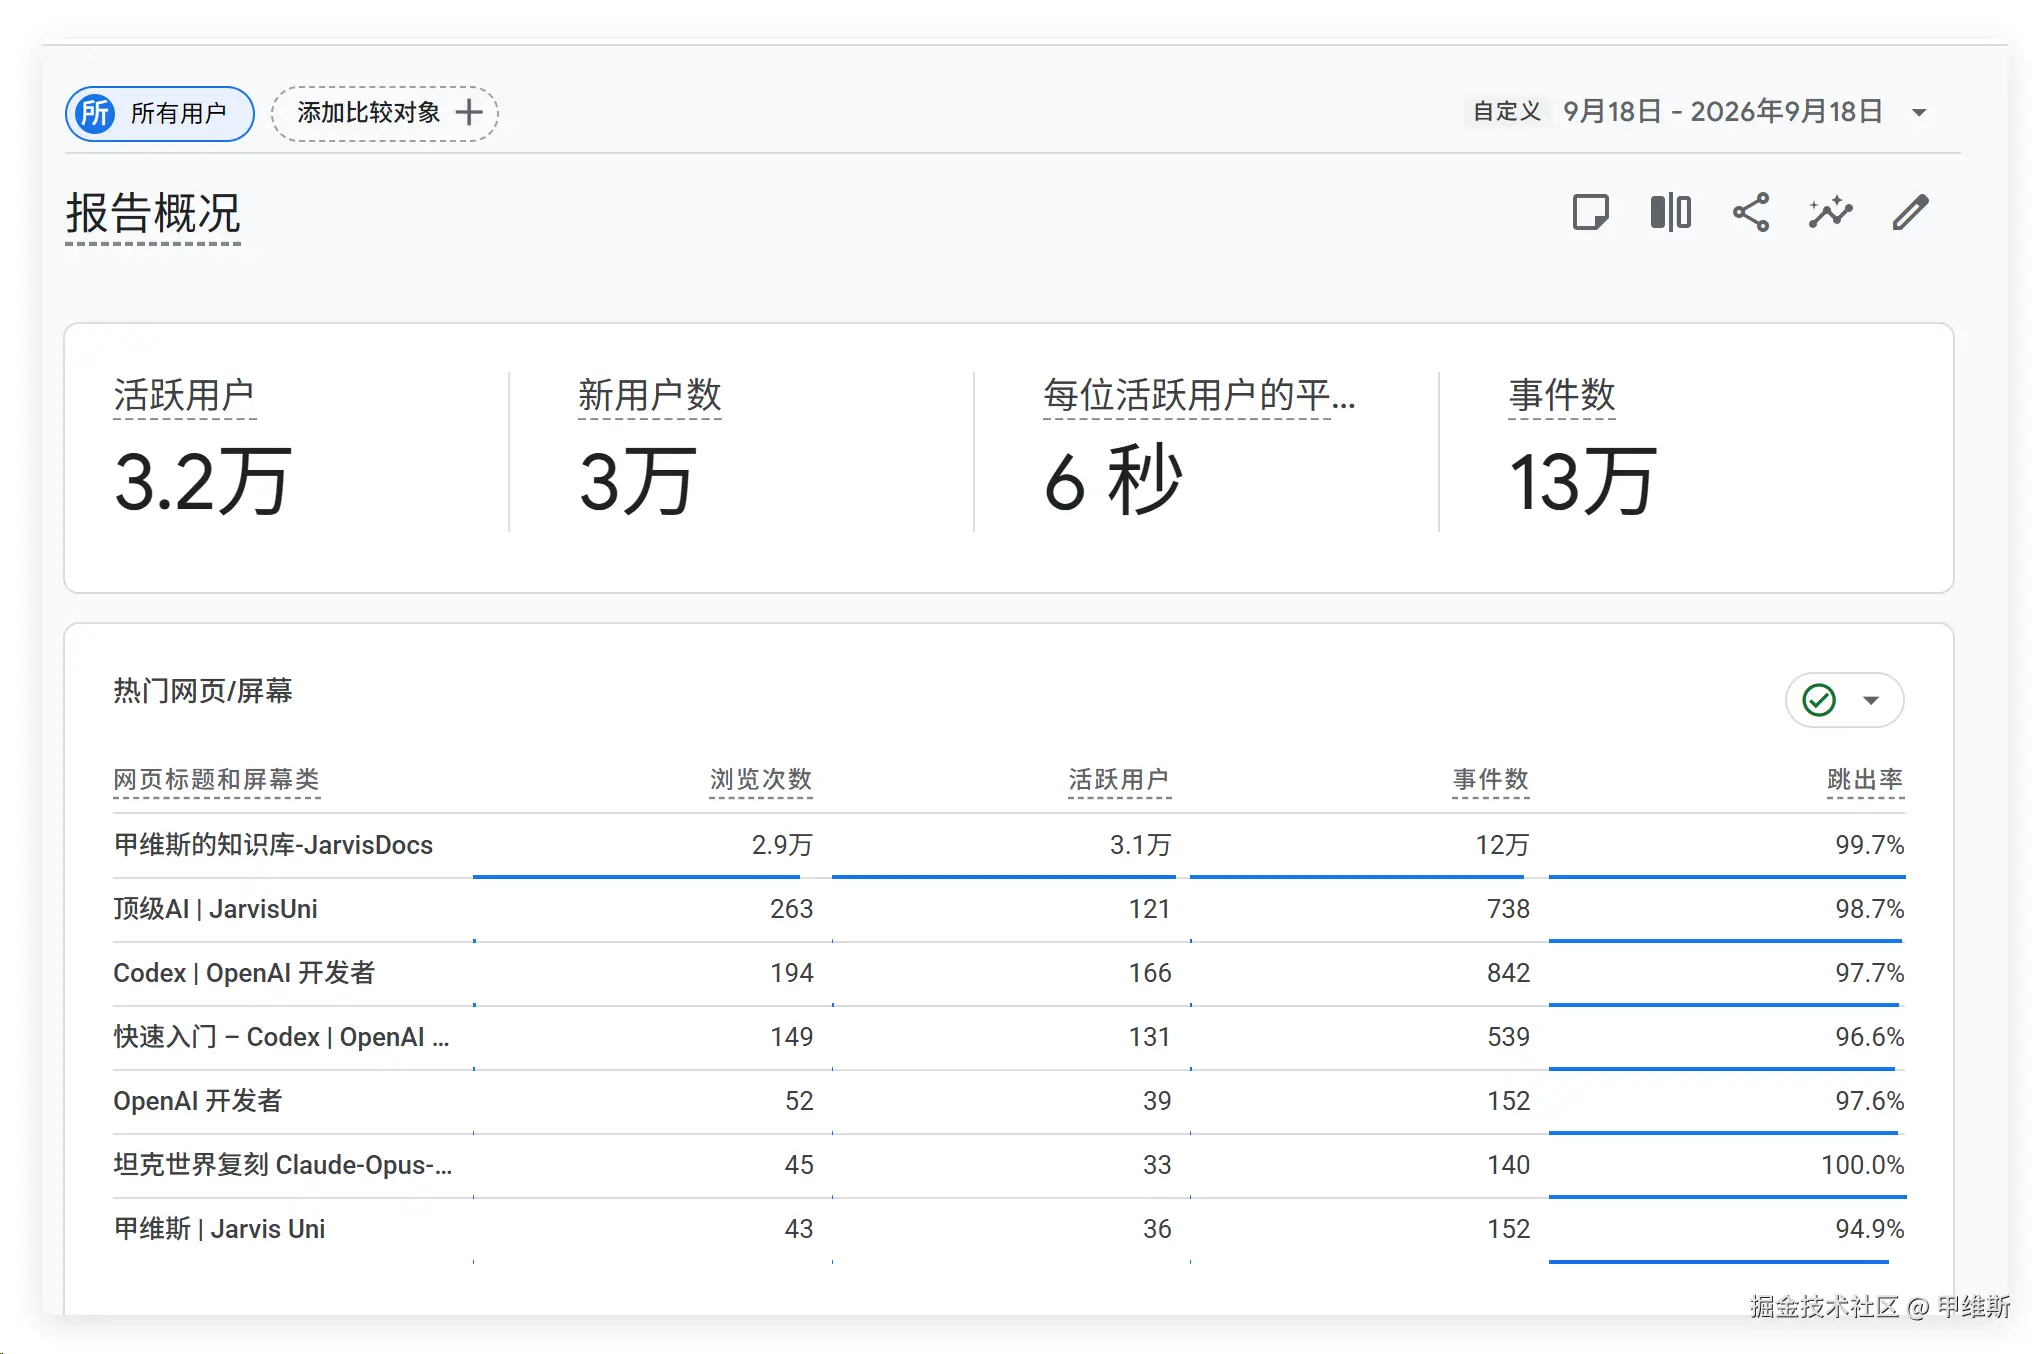
两天功夫,我的个人网站访问量从 1000ip/日,一下干到了 3.2 万,涨了 32 倍!
本来应该庆祝一下,但是这一切都是幻象!
是网络爬虫制造了虚假繁荣,同时消耗了大量网站资源,还抓取了我的几千个文档。
前天,我决定放它 24 小时,没想到它毫无收敛,越偷越猛。
所以我决定出手了!
但是我得想清楚怎么出招,怎么验证效果。
我大致上是有数的,但是具体的规则是一点都不会写的。这个时候 AI 智能体 Codex 就派上用场了!
我来提需求,它来执行和验证。最后成功解决了这个问题,非常丝滑。又是一个完美应用 Agent 解决问题的例子。
当然,这个过程中,还有两个很重要的平台,一个是谷歌的 Analytics 数据统计平台,还有一个是 Cloudflare 云服务平台。 它们是基础设施,Codex 是操作人员。
下面记录一下具体的处理过程。
Round1
首先我对 Codex 说:24 小时过去了,那个 ShapBot 还在搞事情。要不要干它!
它说:确实要给它点颜色看看!
我们基本达成一致!
我就问它具体的方案。
它的建议是:
进入:
jarvisuni.com → 安全性 → 安全规则 → 自定义规则 → 创建规则

规则名称:
Block ShapBot on docs

使用“编辑表达式”,填入:
(http.host eq "doc.jarvisuni.com" and lower(http.user_agent) contains "shapbot")

动作选择:
阻止(Block)

然后部署规则。
这个规则有几个关键点:
只作用于 doc.jarvisuni.com;
不影响主站及其他子域名;
不影响 Googlebot、BingBot、OAI-SearchBot、ChatGPT-User、PerplexityBot;
不要添加 not cf.verified_bot,否则会再次把 ShapBot 放过去;
不要选 Managed Challenge,因为它是身份明确的爬虫,直接 Block 更准确。
它还建议把 robots.txt 也明确拒绝收录!
它已经说得非常全面了,而且考虑得也很细致,在解决问题的同时,也设定了非常清晰的边界。
不会引入额外的问题,从而影响网站的正常流量。
当然,它说的 Robots 这个事,我没有同意,因为人家都这么强抓了,根本不会在意这种君子协议了。
思路已经清晰了,接下来就是让它直接调用我的 Chrome 浏览器,直接创建拦截规则了。
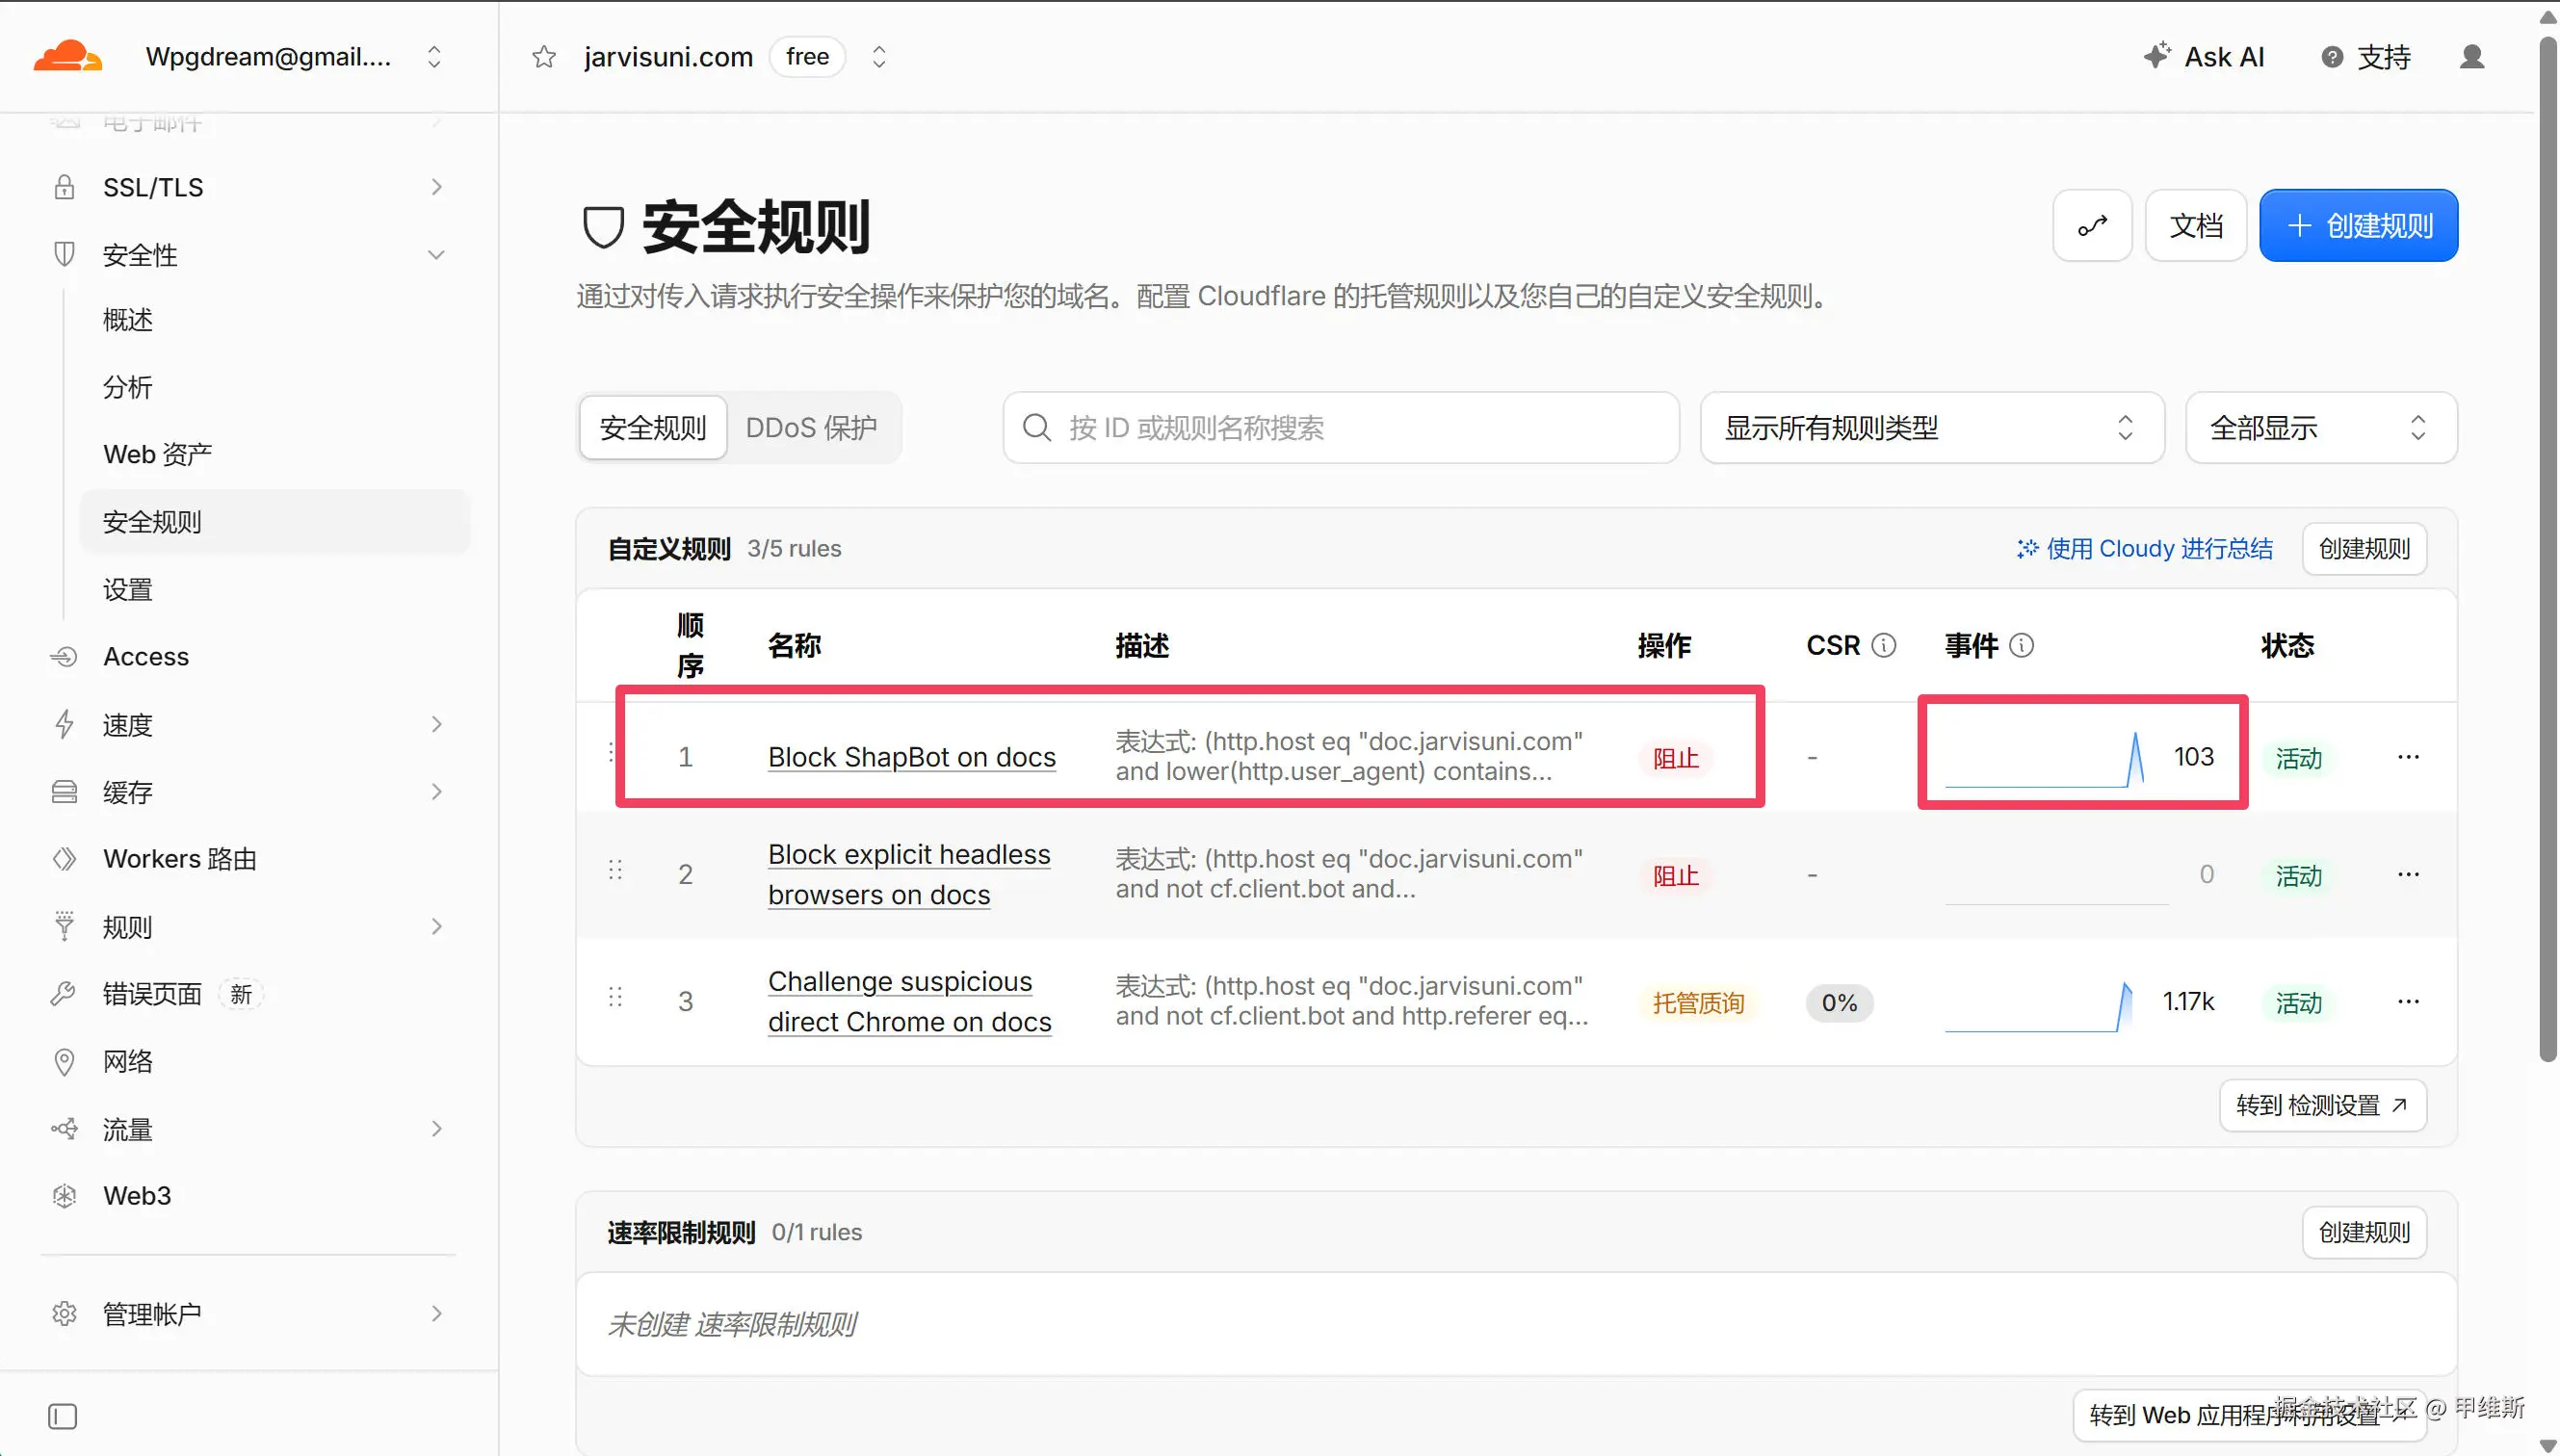
第一个拦截规则轻松搞定,而且从事件中也可以看到 103 次拦截记录了。
这就证明拦截有效了。
而且 Codex 自己也模拟了一下相关请求,确实被拦截了。
但是,我观察了一下,发现谷歌的统计数据,和 CF 的网站统计数据,全部没有明显的变化,也就是说,抓取行为还是存在。
我让Codex分析一下,结论和我观察到的一致!
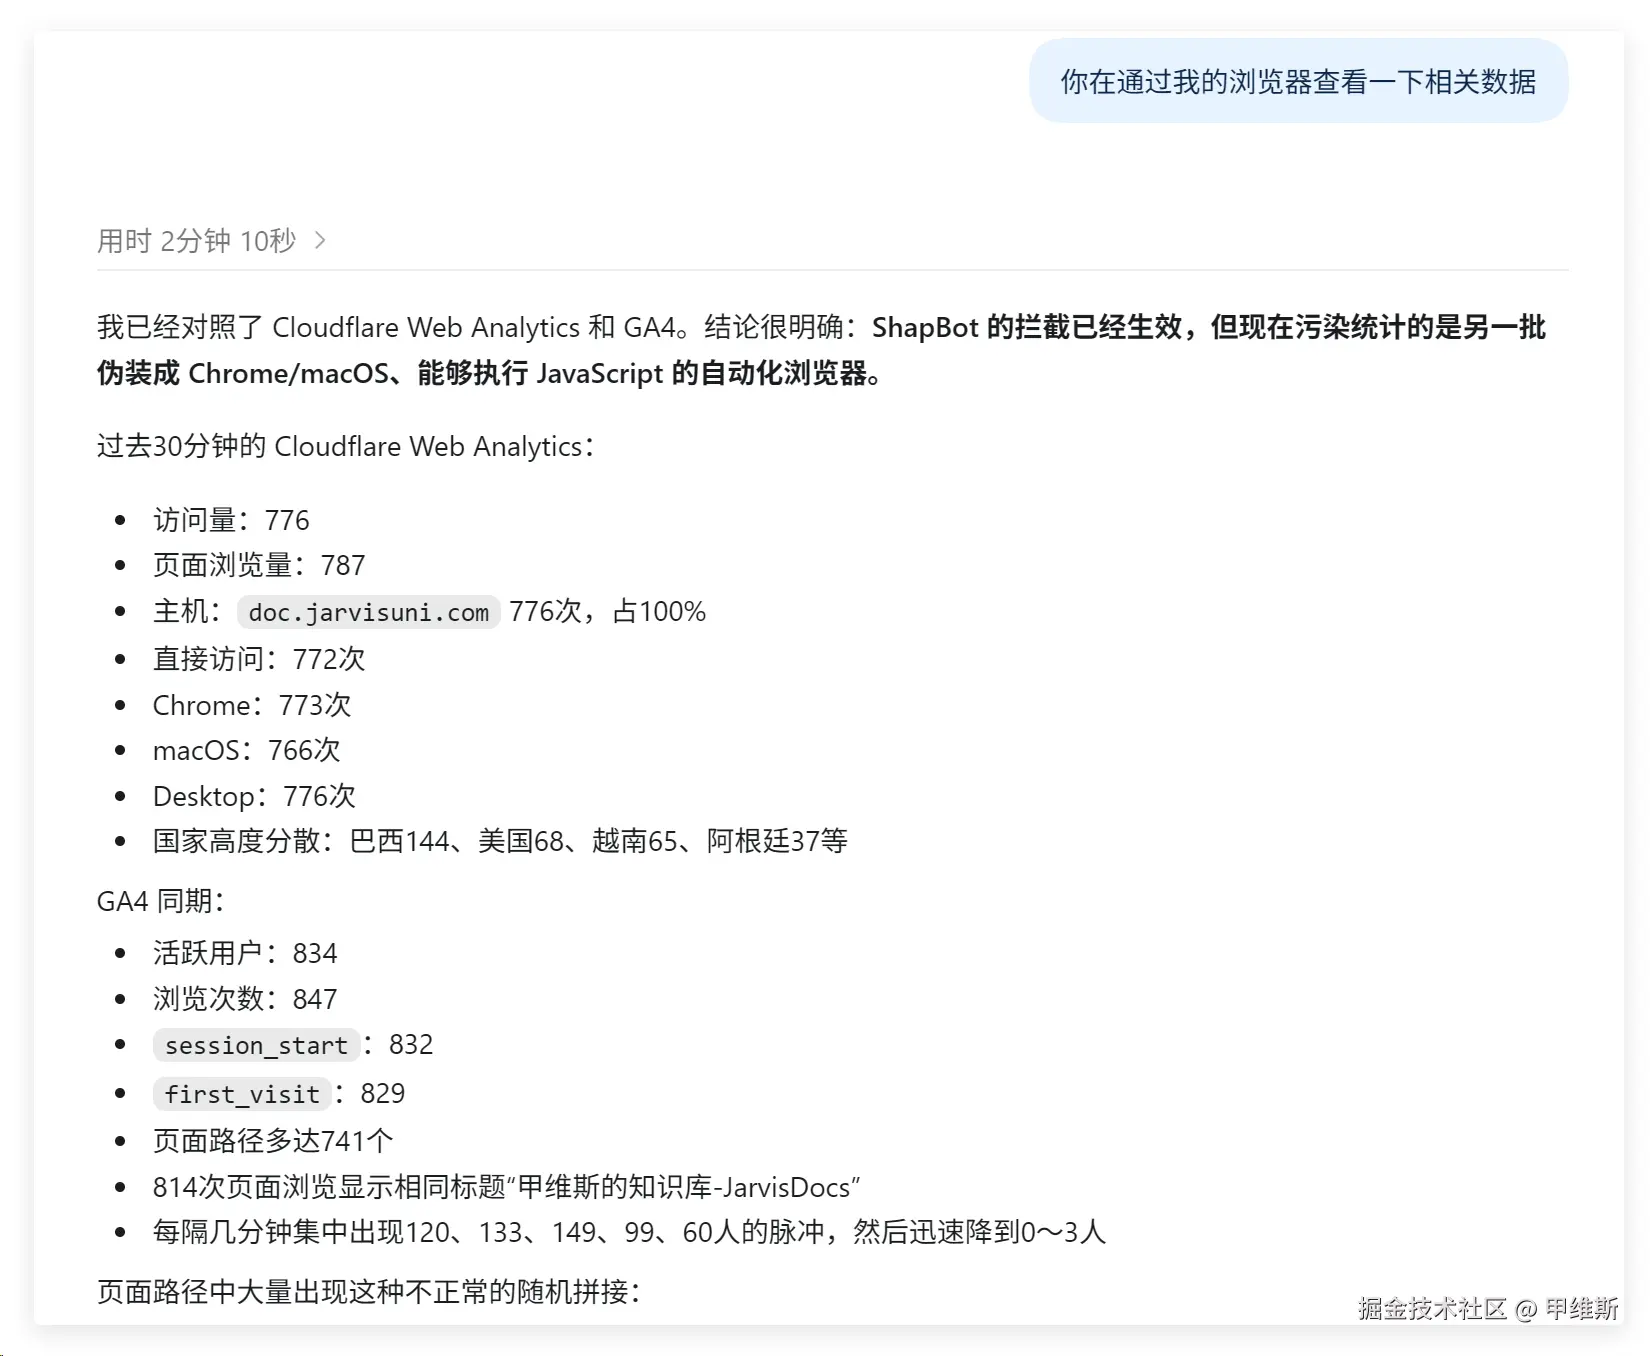
刚才我也说过了,这爬虫很明显就是个流氓,不会遵循君子协定的。它发现我们根据浏览器 Agent 声明判断抓取行为之后,它立马改变了策略,把声明去掉了。
而且这种爬虫明显不是简单的抓取,它肯定是开了很多模拟器,模拟真人的逻辑来抓取网页的。
Round2
遇到这种情况,肯定得继续推进。至于怎么推进,就问Codex了。
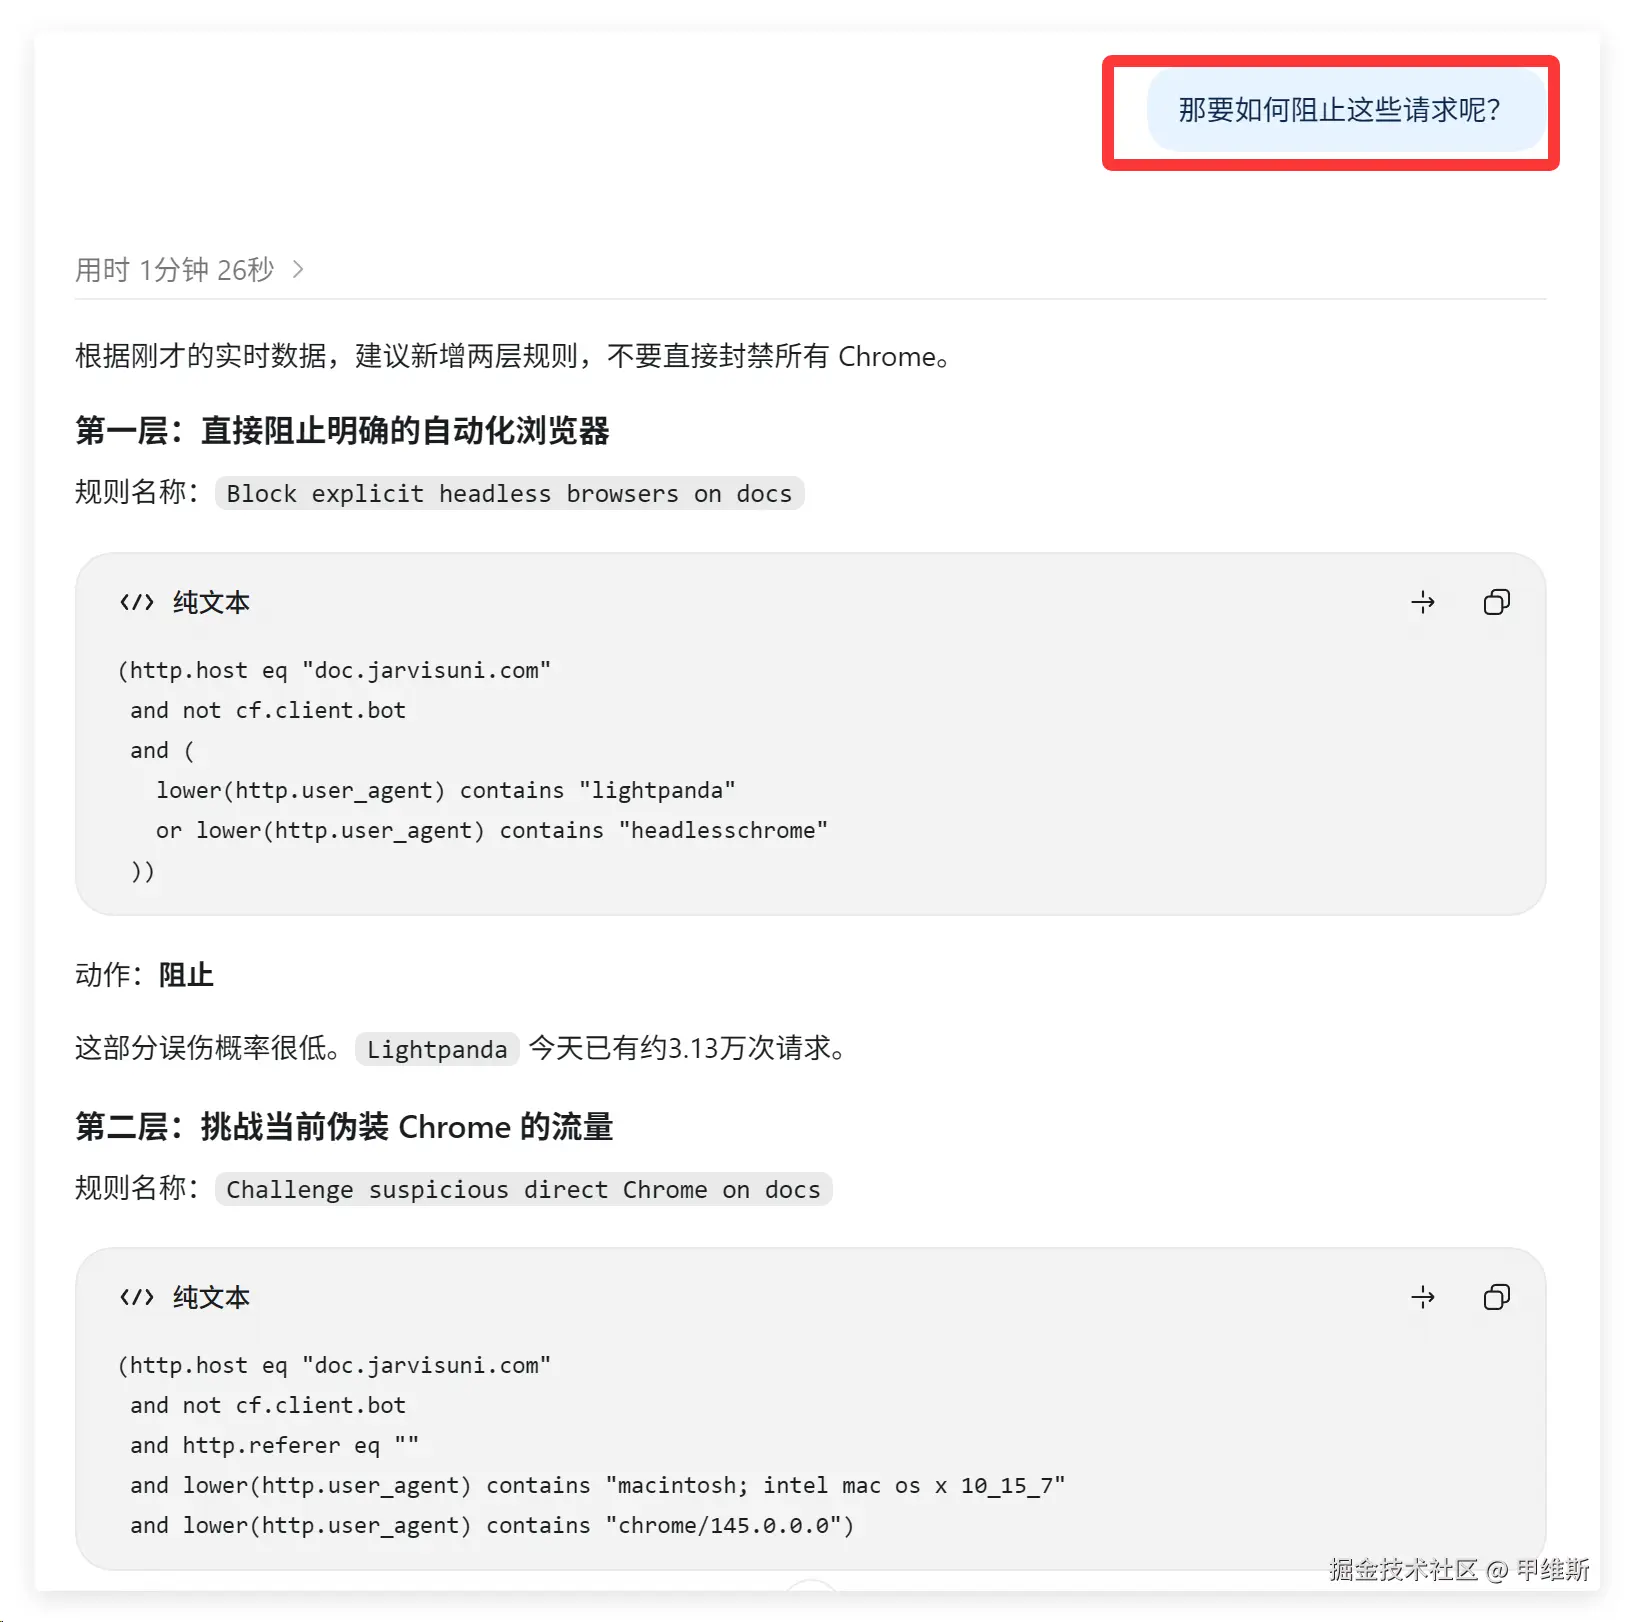
思路很清晰了。
第一层:直接阻止明确的自动化浏览器
第二层:挑战当前伪装 Chrome 的流量
我看了一下它的思路和规则内容,没毛病,就这么干。
然后直接让它帮我创建这两条规则,同时每间隔 30 分钟帮我检查一次谷歌 GA4 和 CF 的流量数据。
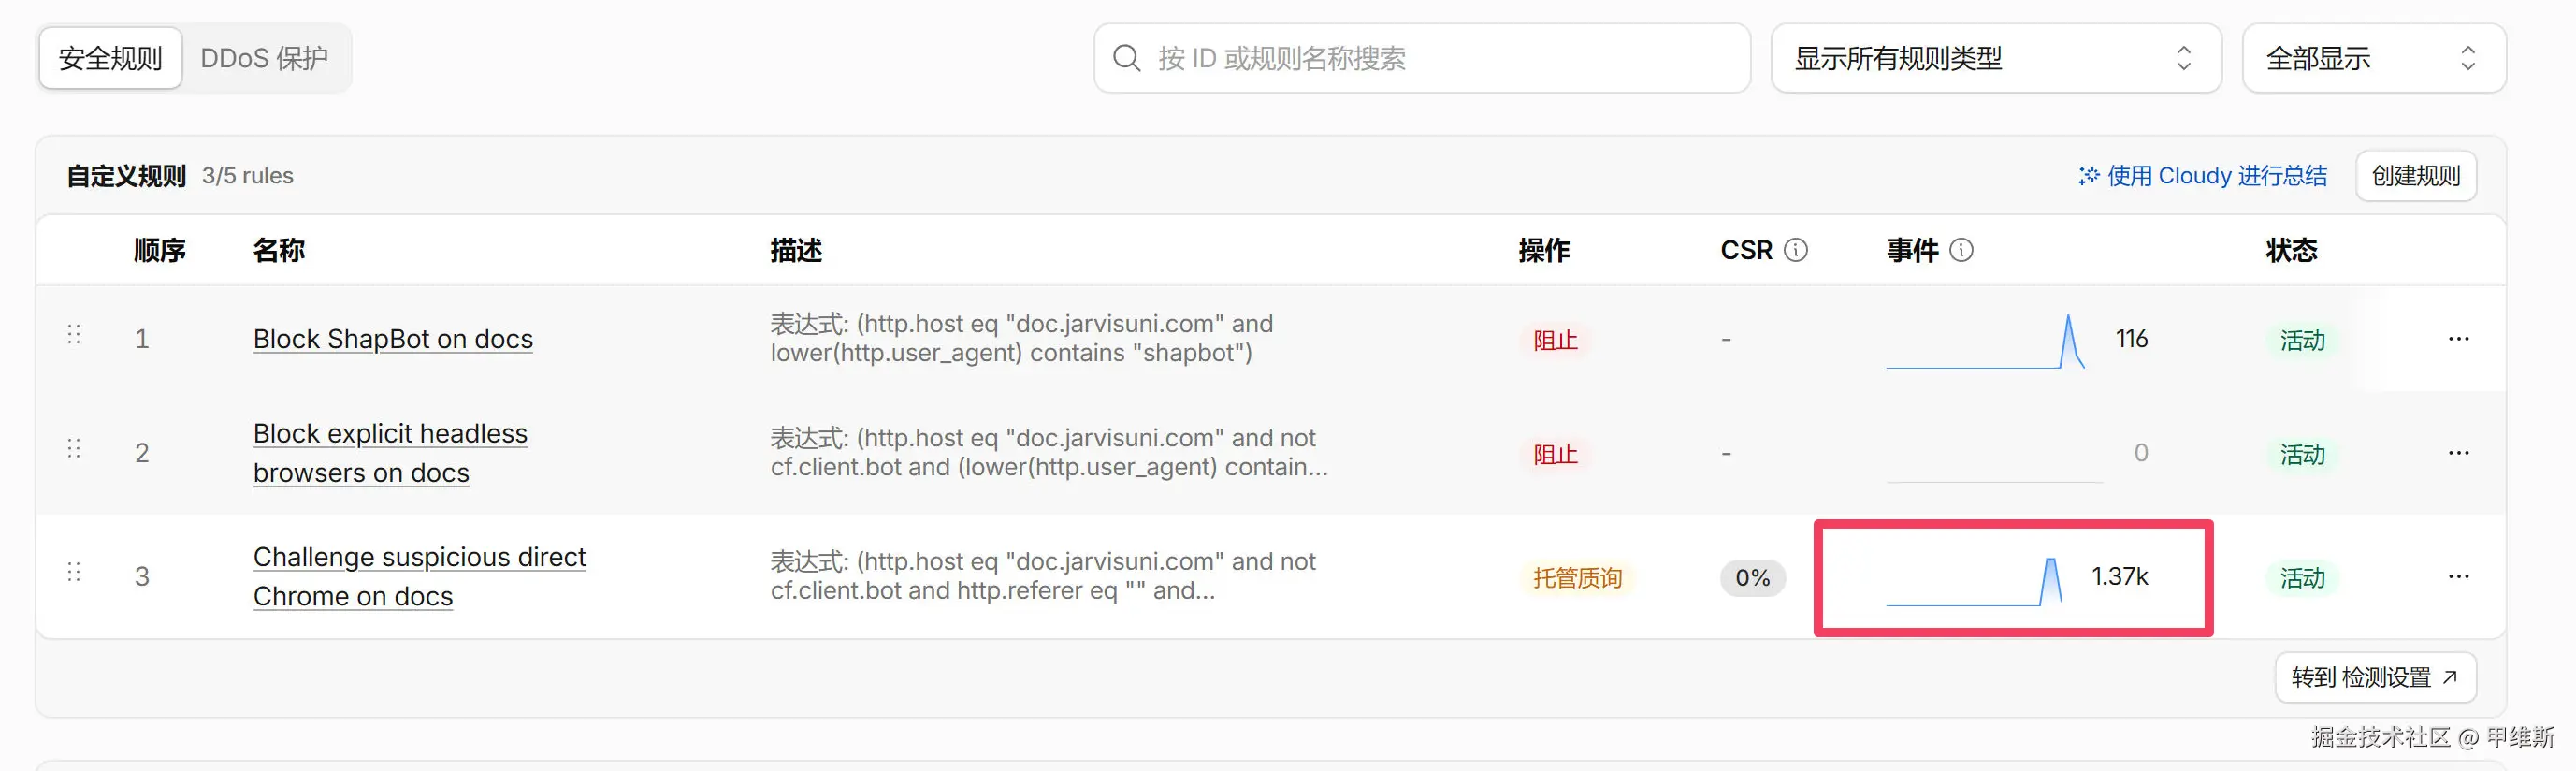
它成功创建了两条拦截规则:
同时创建了一个定时任务:
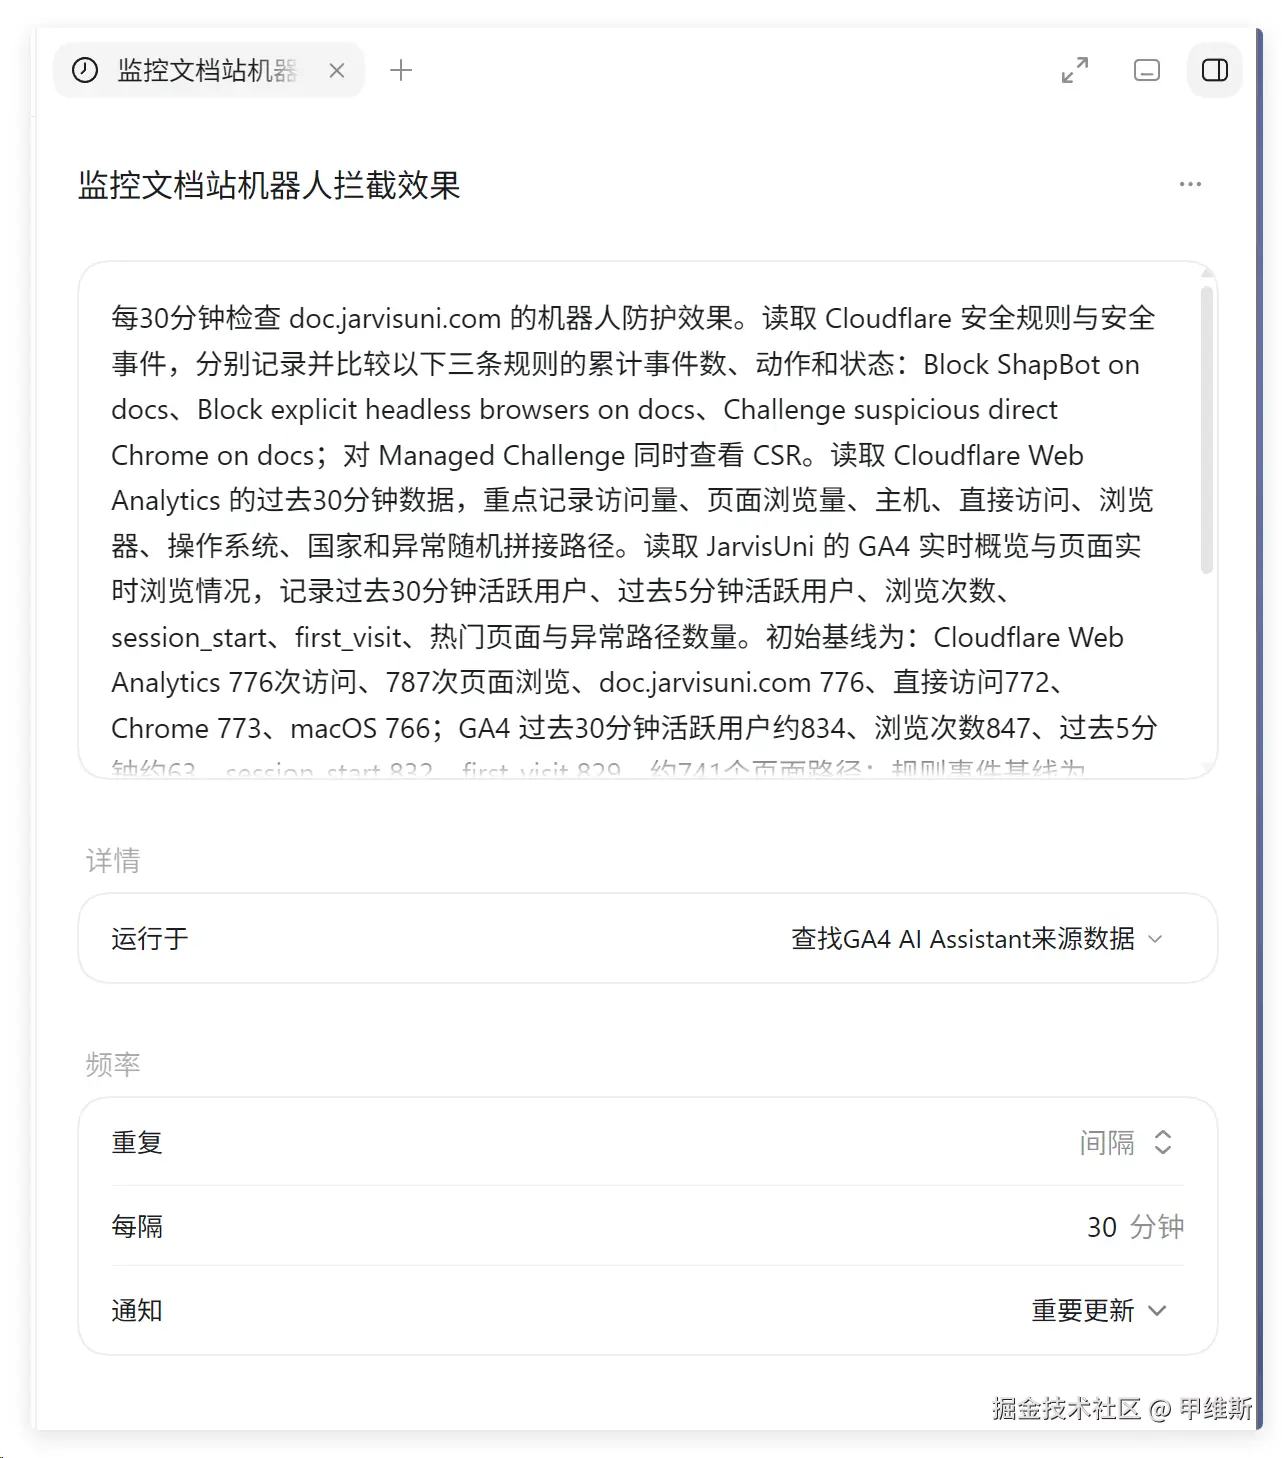
定时任务里面也写好了上下文和提示词。
然后我就玩去了!
回来的时候就看到好消息了:
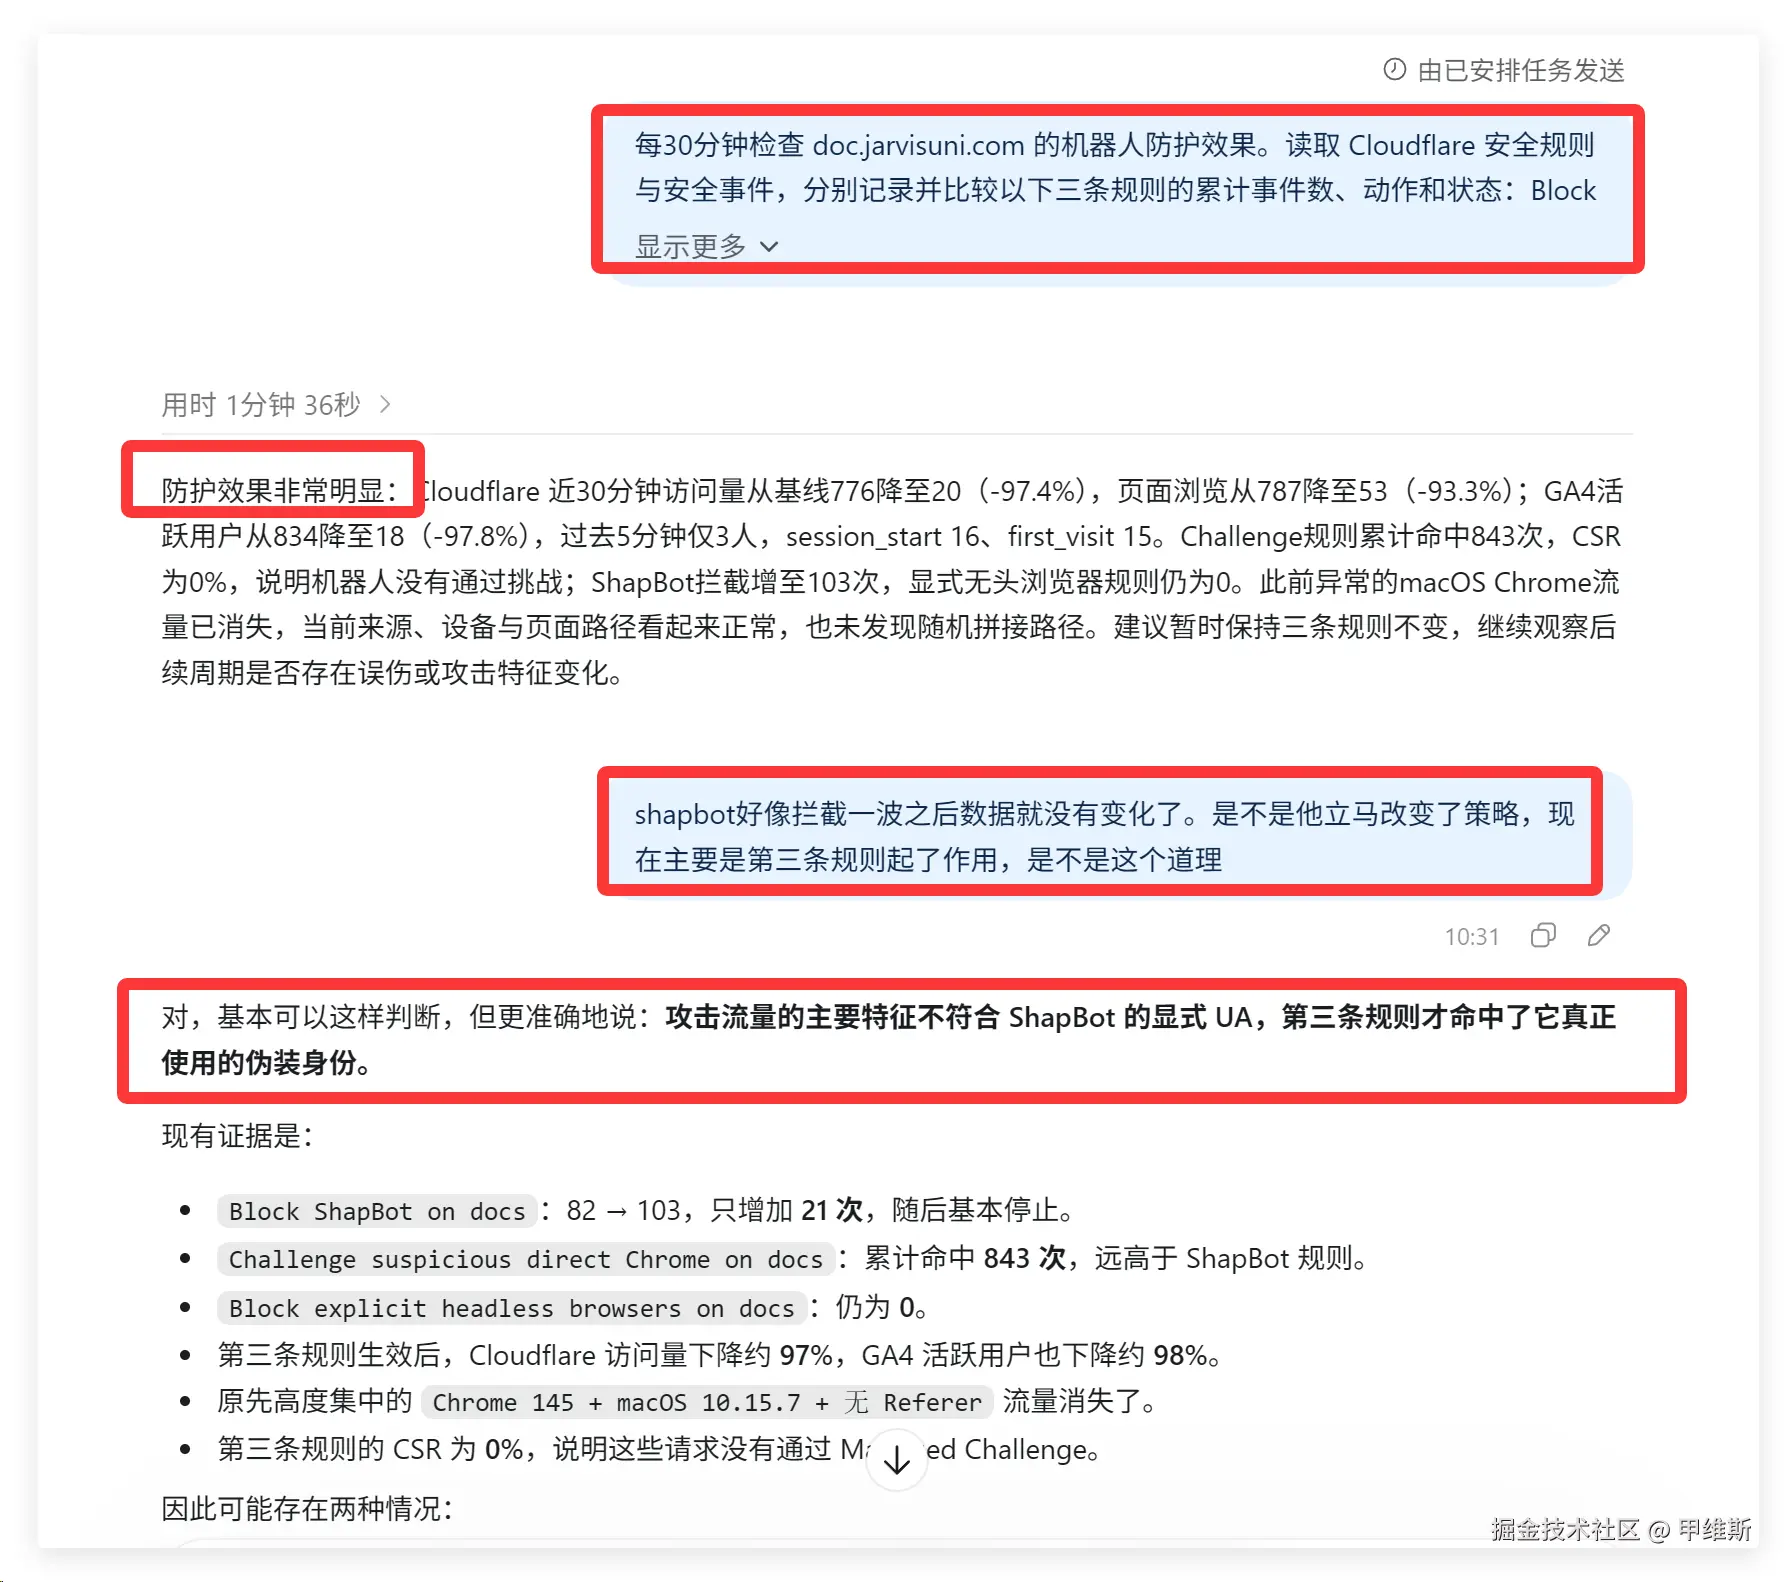
它已经完成了检测!表示防护效果非常明显。
30 分钟后又查了一次:
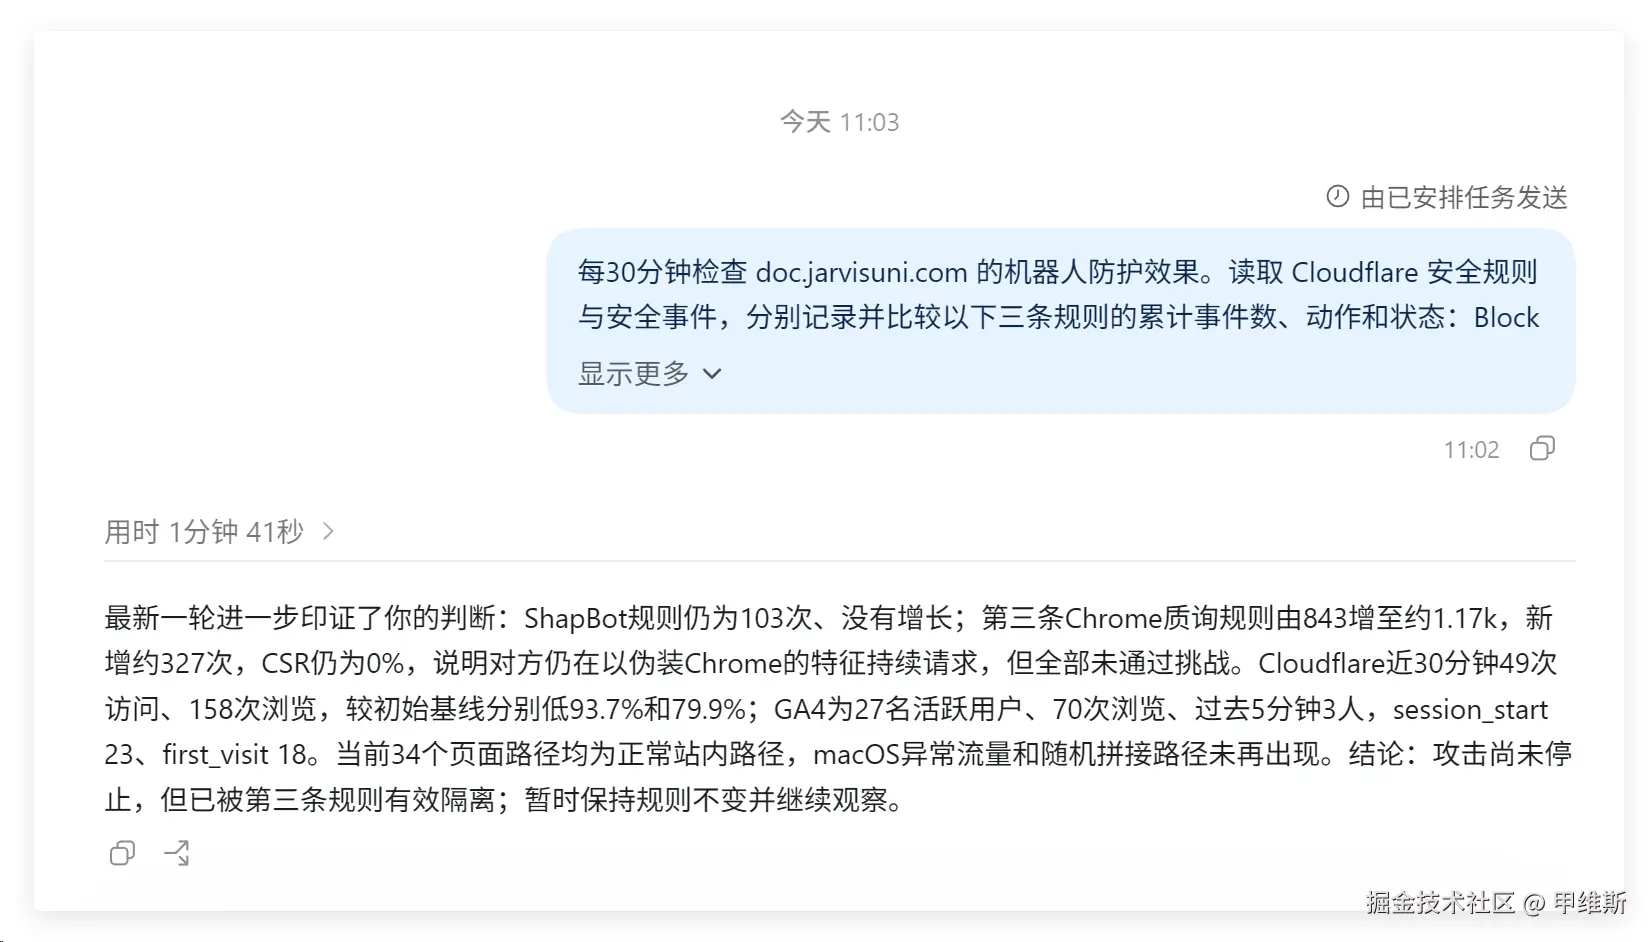
基本落实了,规则 1 生效之后,爬虫就改变策略,然后就被规则 3 给拦截了,规则 2 没有任何命中。
又过了有一天之后,全部命中了!
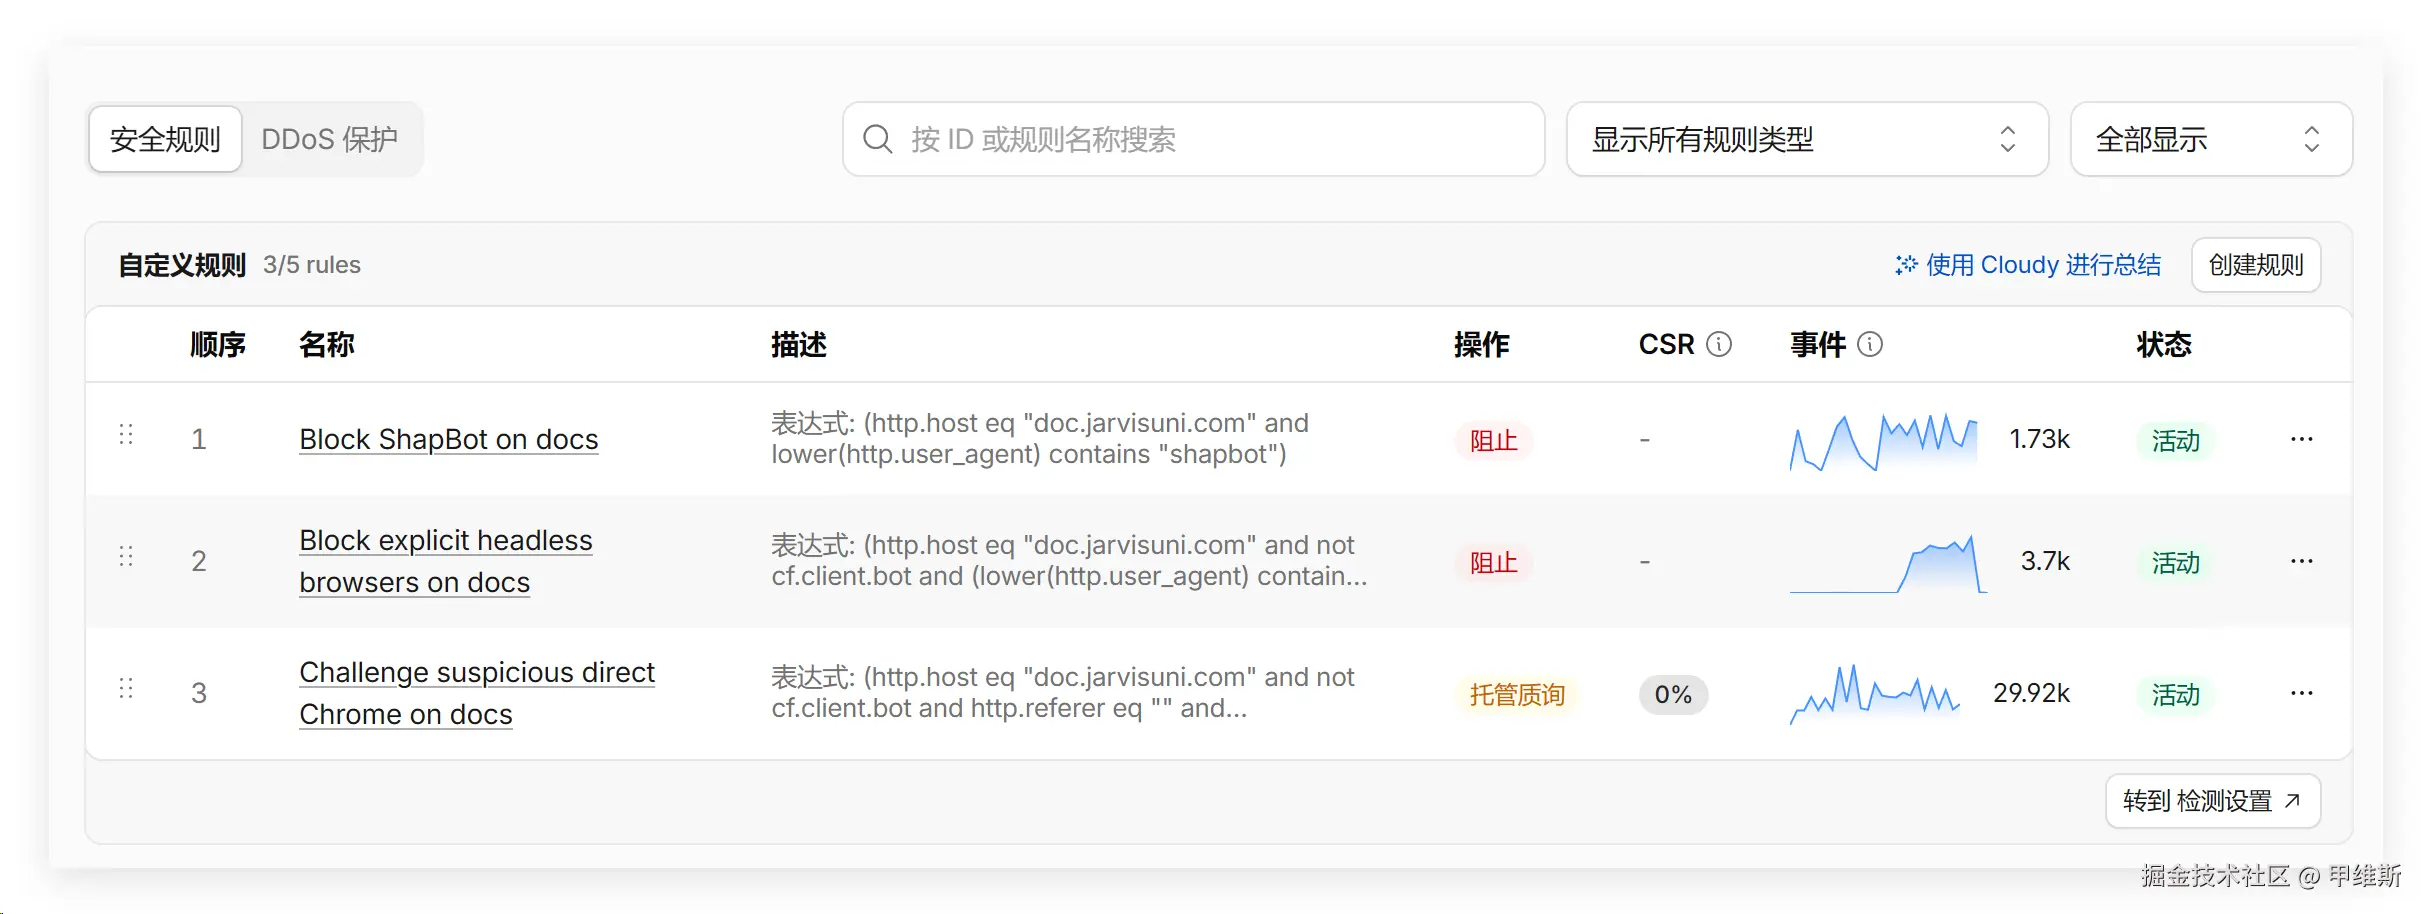
image-20260920083032304
也就是Codex写的每一跳规则都用上了,拦截了3万多请求,最后成功解决了这个问题!
那个爬虫还在努力伪装,希望它赶紧停了吧,别浪费大家资源了。
经过 Codex 的分析,这个爬虫可能是陷入了路径循环,拼接了大量不存在的地址,正常情况抓一波之后应该就消停了。
既然蠢到不知道怎么停,我们只能打服它了!
互联网,还是太凶险了一点,偷啥的都有。但凡你搞得稍微好一点,就立马有人模仿抄袭偷窃。
还好,它们有矛,我有盾,也能干个五五开!
Codex 做这种任务,实在是太轻松了,手拿把掐,稳如老狗。
重点:靠谱!没有在解决问题的时候,引入新的问题。
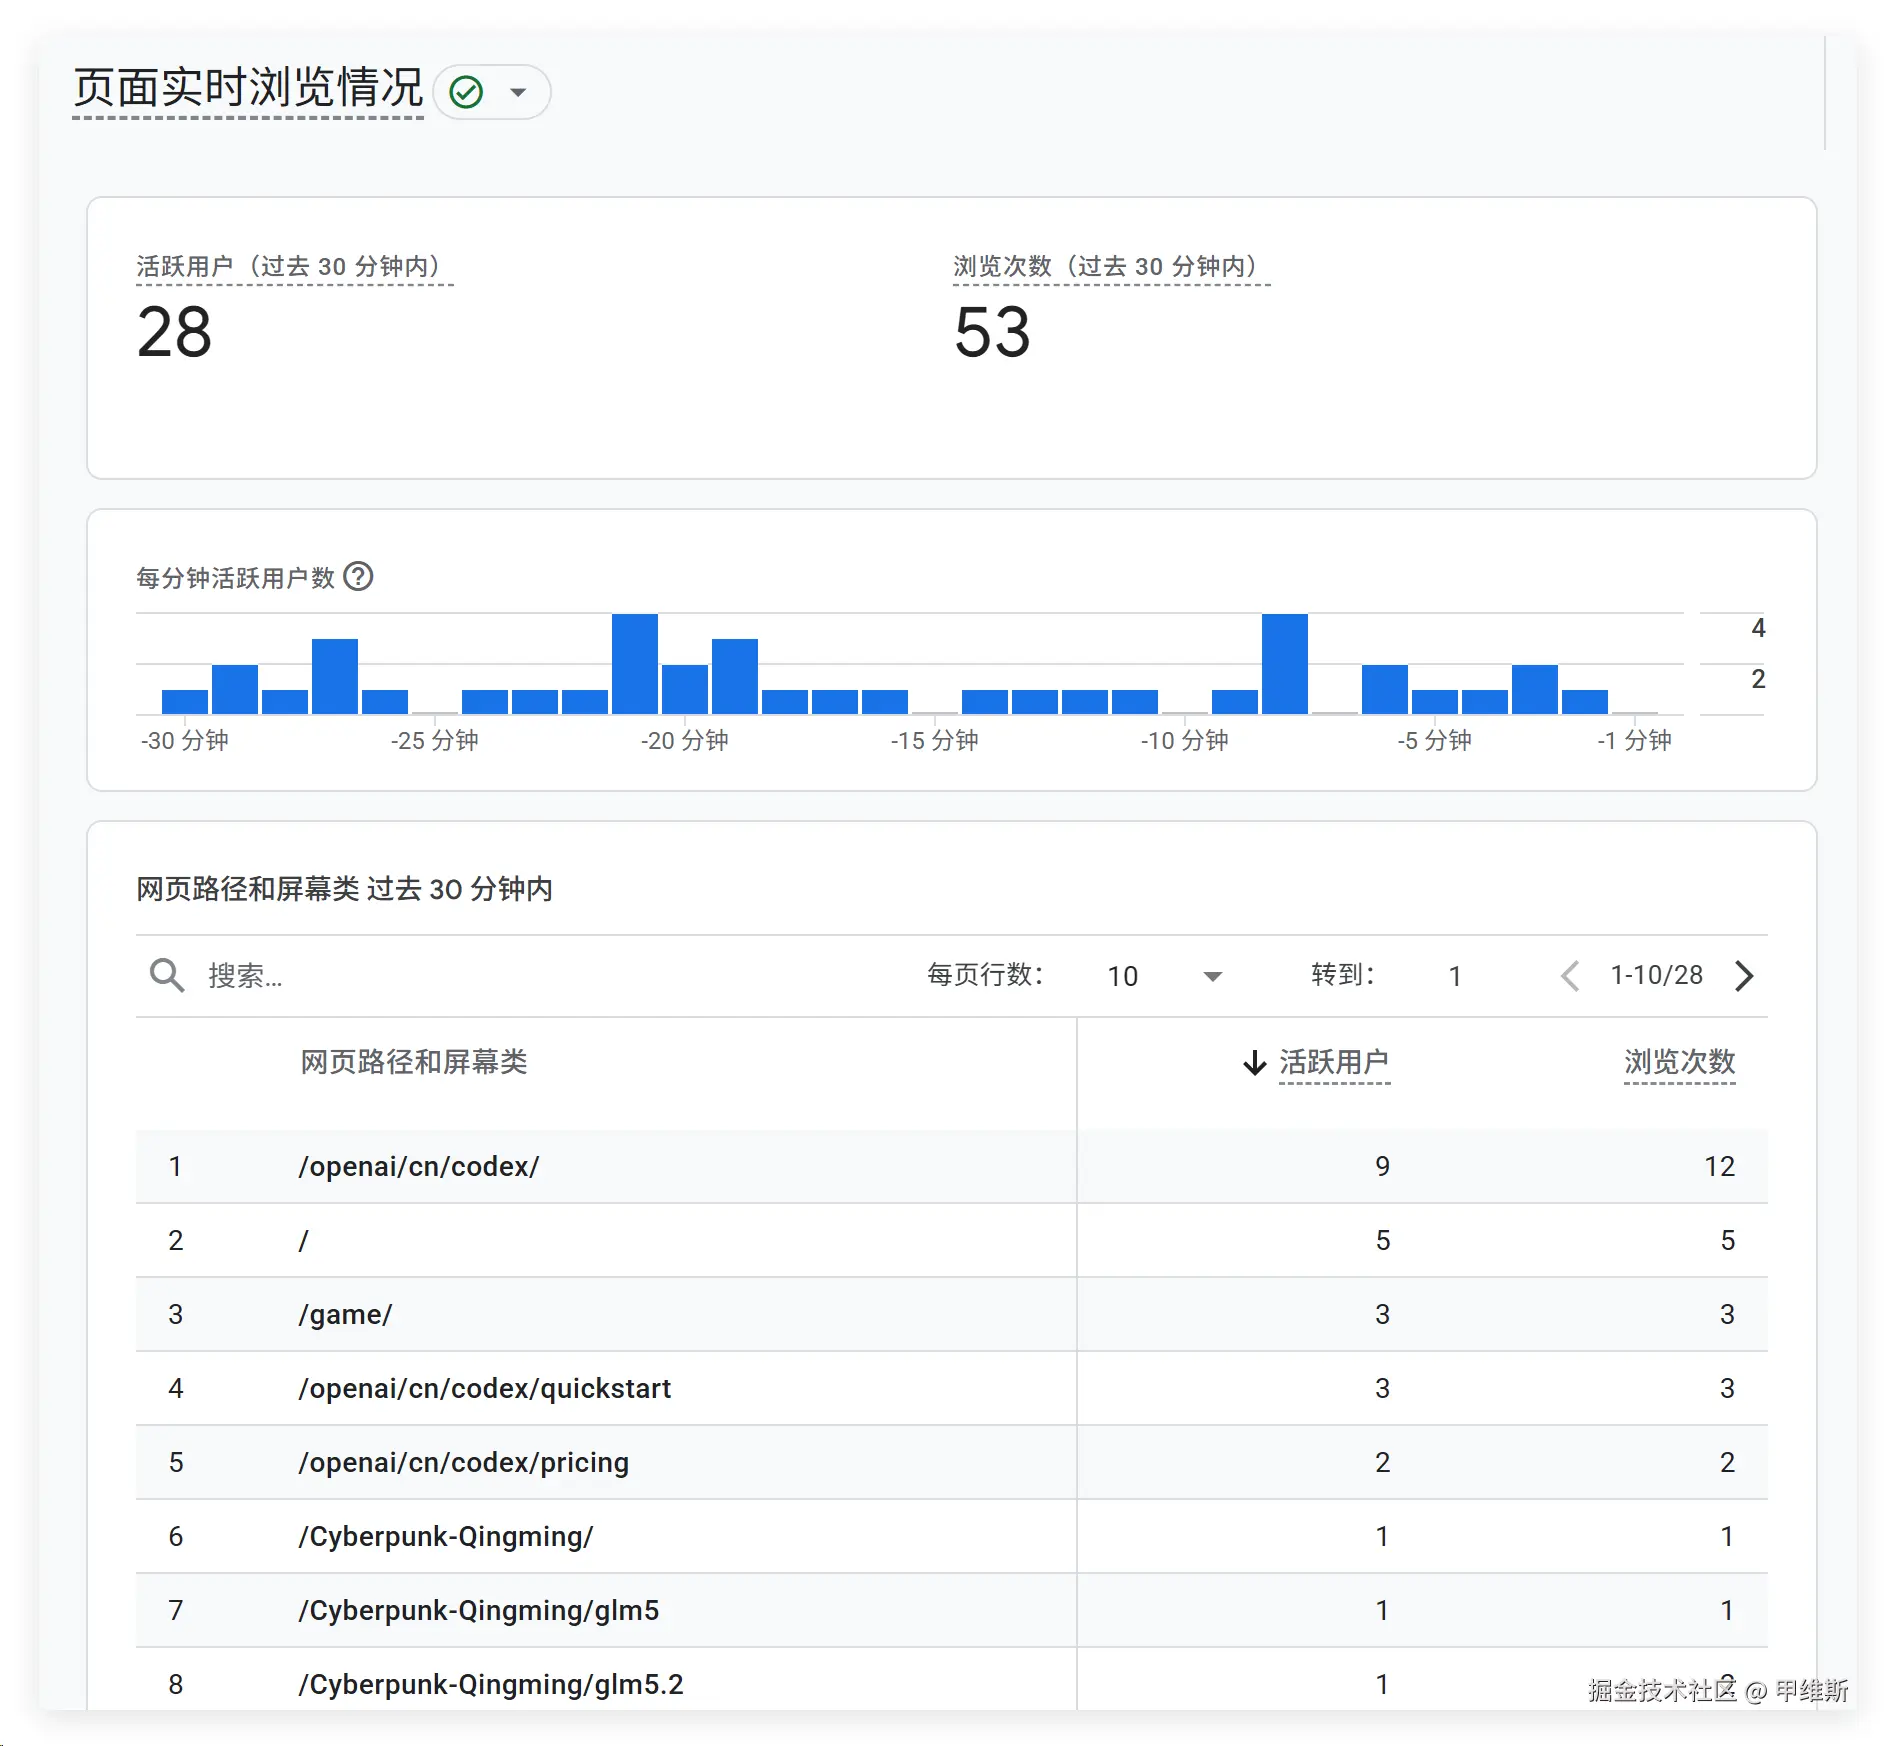
网站已经回归正常,欣慰的是问题解决了,但是怎么有点失落呢? 可能是虚假繁荣看起来太爽了?!
各位人类玩家,请帮我重新找回这种繁荣的感觉!
主域名:jarvisuni.com
如果是新读者,欢迎 follow 我,我只分享真实的测评和真实的操作经验!
后期会进入真正的AI应用阶段,搞网站,软件,搞游戏!
相关文章
-
用 Go 从零实现 Claude Code(二):命令行循环与对话记忆
游戏攻略 2026-09-20
-
GrokBot 核心成员 Lauren Tan:用 AI 实现每月 2000 个 PR 的工程方法
游戏攻略 2026-09-20
-
企业级 Agent Memory 架构选型:可扩展 Memory Service 如何设计
游戏攻略 2026-09-20
-
Codex 出手:成功拦截网站异常爬虫
游戏攻略 2026-09-20
-
Memory Provider 架构实战:拆解 Hermes、Mem0、Honcho 与 Hindsight 的共同设计
游戏攻略 2026-09-20
-
用Jev构建“智能if”:一次请求完成3项判断与置信度路由
游戏攻略 2026-09-20