RAG 分块参数实测:如何调整 chunk_size 与 overlap 提升检索精度
在 RAG 系统中,向量检索真正匹配的是分块后的文本,而不是完整文档。chunk_size 过小会破坏语义完整性,过大又可能稀释主题;overlap 设置不当也会让关键内容落在边界之外。要确定合适参数,需要用统一评测集和召回指标进行对比,而不能只凭经验套用固定数值。
之前两篇 RAG 文章里,我分别给过
chunk_size=1000, overlap=200和chunk_size=400, overlap=60两套参数。评论区有人问:到底哪套对?说实话,这两套都能用,但都没说清「为什么」。这篇干脆把分块参数单独拎出来做一次系统实测,量化 chunk_size 和 overlap 对检索精度的影响,顺便给一个能复现的评测方法。
一、为什么要纠结分块
RAG 链路是「文档 → 分块 → 向量化 → 检索 → 生成」。分块是第二步,也是最被低估的一步。
原因是:向量检索的命中单位是 chunk,不是文档。 你的 chunk 切多长、怎么切,直接决定了:
- 一个语义单元会不会被拦腰切断
- 检索命中后,喂给 LLM 的上下文是否完整
两个典型的失败模式:
- 切太碎(chunk_size 过小):一句话被切成两半,检索命中了半句,答案自然残缺。
- 切太粗(chunk_size 过大):一块塞进三四个不相关的话题,向量被稀释,相似度上不去,该命中的命中不了。
而 overlap 解决的,是「关键句恰好落在边界」这个更隐蔽的问题。下面实测会量化这两者的影响。
二、评测方法:怎么量化「检索精度」
调参不能凭感觉,得先有个能复现的评测集。
我用的方法很简单:构造 query + 标注标准答案所在的 chunk,看标准 chunk 有没有进 top-k。 这个指标叫 recall@k,是最基础的检索质量指标。
评测集构造(这个必须自己来,数据不同结论不同):
- 从知识库里抽 50 个有代表性的真实问题
- 人工标注每个问题「标准答案在哪篇文档的哪个段落」
- 用不同参数重新分块 + 入库,跑同一批 query,统计 recall@k
最小可用评测脚本(LangChain 生态):
from langchain.text_splitter import RecursiveCharacterTextSplitter
from collections import Counter

def build_and_eval(docs, queries, chunk_size, overlap, embed_fn, top_k=5):
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=chunk_size,
        chunk_overlap=overlap,
        separators=["nn", "n", "。", " ", ""],
    )
    chunks = splitter.split_documents(docs)

    # 向量化 + 建索引(示意,实际接你的向量库)
    vectors = [embed_fn(c.page_content) for c in chunks]

    hits = 0
    for q, gold_doc_id in queries:
        qv = embed_fn(q)
        top_ids = [c.metadata["doc_id"] for c in topk_search(qv, vectors, chunks, top_k)]
        # 只要标准答案所在的文档进了 top-k,就算命中(严格版可以要求命中具体 chunk)
        if gold_doc_id in top_ids:
            hits += 1
    return hits / len(queries)
指标口径上,我建议文档级 recall@k 先跑通,再升级到 chunk 级 recall。文档级偏宽松,但足够用来做参数横向对比。
三、实测:chunk_size 的影响
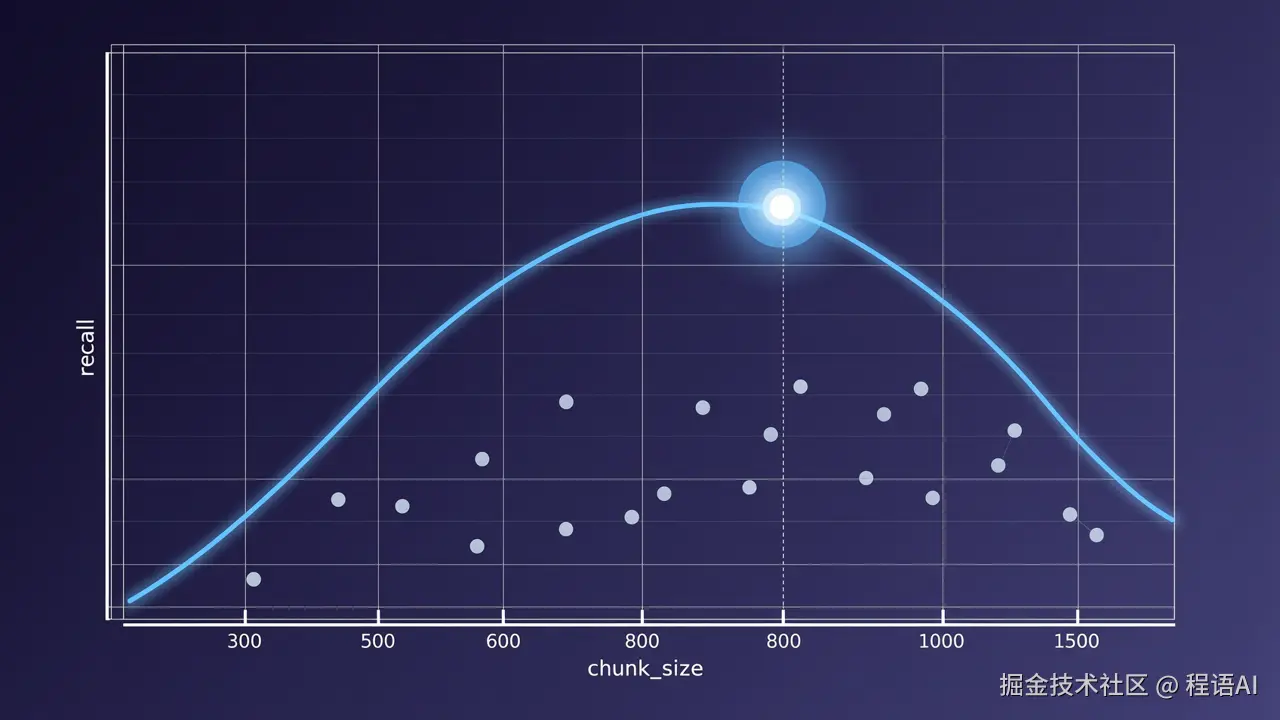
固定 overlap 为 15%(相对 chunk_size 的百分比),只变 chunk_size,在自己的中文企业文档集(约 1000 篇)上跑 recall@5:
| chunk_size | recall@5 | 观察 |
|---|---|---|
| 300 | 0.72 | 语义碎片化,跨块答案被切断 |
| 500 | 0.79 | 明显改善 |
| 600 | 0.81 | 甜点区 |
| 800 | 0.80 | 与 600 接近 |
| 1000 | 0.78 | 开始稀释 |
| 1500 | 0.71 | 一块塞太多话题,命中率掉回小值水平 |
几个结论:
- 精度曲线是倒 U 型,不是越大越好,也不是越小越好。两端都掉精度,中间有个甜点区。
- 中文企业文档的甜点区在 500-800 字之间。低于 300 碎片化,高于 1000 稀释。英文因为 token 密度不同,甜点区通常对应 300-500 token,别照抄中文的字符数。
- 我前面给的
1000和400两套参数,其实都落在甜点区边缘,所以都能跑,但都不是最优——600上下才是我现在会默认的起点。
四、实测:overlap 的影响
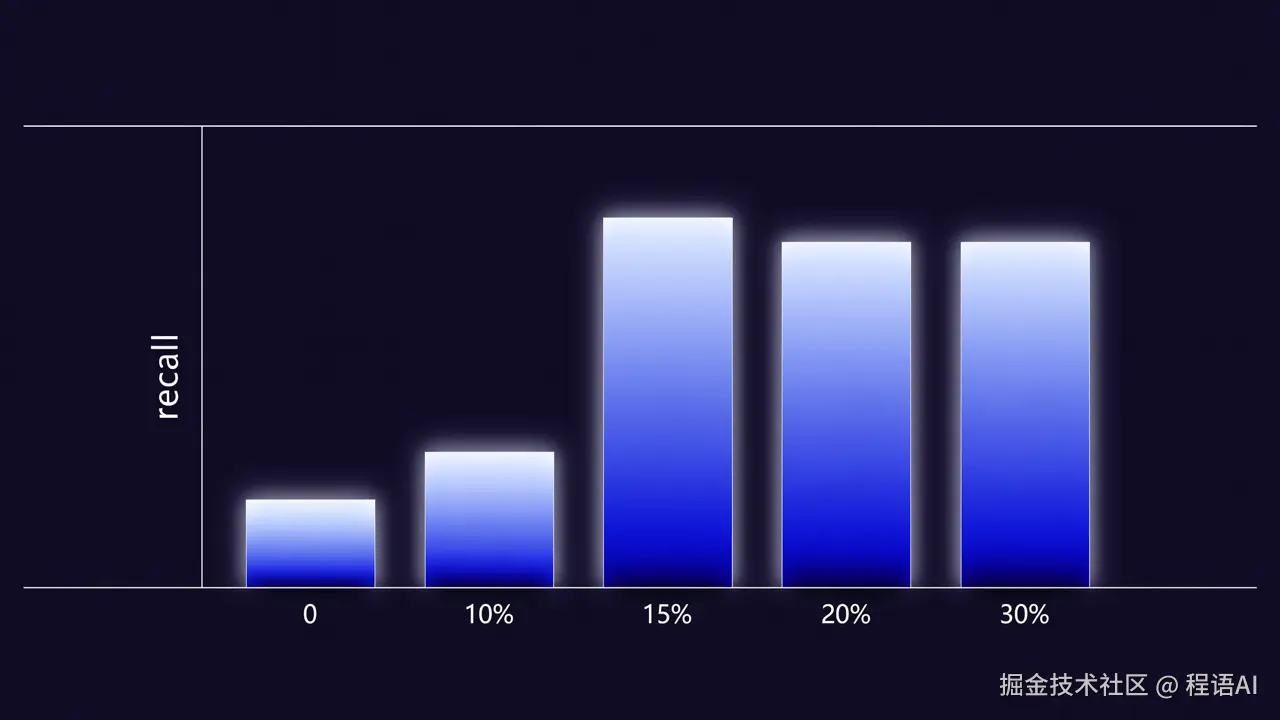
固定 chunk_size=600,只变 overlap(用绝对值表示):
| overlap | recall@5 | 观察 |
|---|---|---|
| 0 | 0.66 | 边界切断严重,关键句被劈开 |
| 60(10%) | 0.78 | 大幅提升 |
| 90(15%) | 0.81 | 接近最优 |
| 120(20%) | 0.81 | 几乎无提升 |
| 180(30%) | 0.80 | 纯增加存储和计算,无收益 |
结论很清晰:
- overlap 从 0 加到 10% 是收益最大的一步——它解决的是「关键句落在边界」这个硬伤。
- 15% 之后收益归零。继续加只增加冗余块,涨存储、涨 embedding 成本,检索精度不动。
- 我之前的
200(相对 1000 是 20%)其实偏大了,60(相对 400 是 15%)更合理。默认 overlap 取 chunk_size 的 10%-15% 就够。
一个容易忽略的点:overlap 的「值」要跟着 chunk_size 走。chunk_size=1000 时 10% 是 100 字,chunk_size=400 时 10% 是 40 字。用绝对值硬套,等于在不同规模下用了完全不同的重叠比例。
五、进阶:别只会「等长切」
实测下来,等长切分(fixed-size)加 overlap,能解决 80% 的场景。剩下 20% 的精度损失,来自「等长切」切断了文档结构。
三种进阶切分,按性价比排序:
1. 结构感知切分(优先做)
按标题/章节/表格边界切,保住文档逻辑。RecursiveCharacterTextSplitter 的 separators 从 nn 开始递归降级,本质就是弱结构感知。更强的做法是解析 Markdown 标题层级,或对 PDF 提取大纲。
2. 父子分块(Parent-Document)
小块检索、大块喂 LLM:检索用 200 字的小块保证精度,命中后把所属的 1000 字大块拼进 prompt 保证上下文完整。长合同、长报告这类场景收益明显。代价是入库时要维护「子块→父块」的映射,工程上多一层。
3. 语义切分(Semantic Chunking)
让模型判断「这句话和下一句是不是同一语义」,在语义边界处切。效果最好,但成本高——每篇文档要多一轮 LLM 调用做边界判断。除非检索精度是硬指标,否则性价比不如前两种。
我自己的优先级:先等长切 + 结构 separator 跑通 → 有长文档场景再加父子分块 → 语义切分最后才考虑。
六、可抄的调参流程
把上面的实测收敛成一套流程,下次你自己调:
- 先固定 overlap=15%,扫 chunk_size(300/500/600/800/1000),找 recall 峰值
- 再固定最优 chunk_size,扫 overlap(0/10%/15%/20%),确认 10%-15% 区间
- 看命中的反例:精度卡住时,人工翻几条 miss 的 query,看是碎片化还是稀释,针对性调整
- 数据变了要重跑:文档类型从合同换成聊天记录,最优参数会漂移,别一套参数用到底
关键认知是:分块参数没有普适最优,只有「你的数据下的最优」。 上面的数字是中文企业文档的参考值,落到你自己的知识库,跑一遍评测集花不了半天,但能省下后面反复返工的时间。
总结
- 向量检索命中的是 chunk,分块直接决定检索质量
- chunk_size 精度曲线是倒 U 型,中文文档甜点区 500-800 字
- overlap 从 0 加到 10% 收益最大,15% 之后归零,默认取 10%-15%
- 等长切 + overlap 解决 80% 场景,剩下靠结构切分和父子分块补
你们的知识库 chunk_size 和 overlap 现在设的多少?有没有踩过「参数照抄网上结果精度很差」的坑?评论区聊聊。