AI 结构化输出的标准解法:从 tool call 到 withStructuredOutput
让大模型稳定返回可直接使用的数据,并不只是要求它“输出 JSON”这么简单。提示词约束可能被 Markdown 包裹或字段类型偏差打破,而 tool call 又暴露了较多底层细节。围绕这些问题,可以从 LangChain 的 withStructuredOutput 入手,梳理结构化输出机制、Schema 校验、流式处理与特殊格式兜底之间的关系。
写在前面:上一期我们聊到结构化输出,结尾抛出了一个灵魂拷问——"tool call 方式更好,output parser 模块还有存在的必要吗?" 当时的答案是开放式的。今天,readme 更新了,直接给出了完整答案。这节课的内容,就是给整个"结构化输出"系列画上句号:从苦口婆心的 prompt 约束,到 LLM 原生的 tool call 机制,再到 LangChain 封装的终极 API
withStructuredOutput,以及流式结构化输出、XML 特殊格式兜底、数据落地建表。全系列用一张"答题卡"比喻讲完。以下所有代码和概念均来自课堂真实文件。
一、上期回顾:让 AI 填表的三种"笨办法"
上期我们把"让 AI 输出 JSON"分成了五级进化——手搓正则、JsonOutputParser、fromNamesAndDescriptions、fromZodSchema、tool call。
用"让 AI 填一张个人信息表"来类比:
| 方案 | 类比 | 问题 |
|---|---|---|
| 手搓正则 | 你说"填姓名",AI 写完后你手动擦掉多余笔迹 | 每次都要自己清理 |
| JsonOutputParser | 你描述"按 JSON 格式填" | AI 字段名自由发挥 |
| fromNamesAndDescriptions | 你指定"姓名写在 name 栏" | 类型还是管不住 |
| fromZodSchema | 你给每个栏位定了类型规则 | 依赖 LLM 认真听你说话 |
所有 output parser 方案都有一个共同的软肋——靠 prompt 说服 LLM。你苦口婆心地写"必须返回 JSON""birth_year 必须是数字""不要加 markdown",但 LLM 是语言模型,它的第一反应是跟你"说人话"。
readme 上一期总结过这个痛点:
"大模型按照我们的格式要求返回一个 JSON。失败了——json 固定格式输出,被 markdown 格式包裹,llm 输出常是 markdown 格式。"
这就是"口头描述填表"的宿命——AI 听懂了,但总忍不住画蛇添足。
二、tool call:LLM 天生就会的"官方答题卡"
今天 readme 更新后的核心论断:
"tool——参数的 schema 约束,顺手完成了 llm 输出的格式化、结构化。来自 llm 原生的工作机制。非常严苛且准确的校验参数。"
关键词:原生(native)。
为什么 tool call 更可靠?
Output parser 是靠 prompt 说服 LLM——LLM 是在"被迫营业",它本质上还是想写散文。
Tool call 不一样——LLM 在训练时就学会了"按 schema 输出参数"。给它一个工具定义 + schema,它会直接以结构化的 tool_calls 格式返回参数,不需要你教它 JSON 是什么。
readme 说得更直白:
"没有必要 output parser 了,tool calls 的参数,也能拿到结构化的数据,而且因为 tool_calls llm 自身的机制,会更严格、更好。"
两个"更"——更严格、更好。
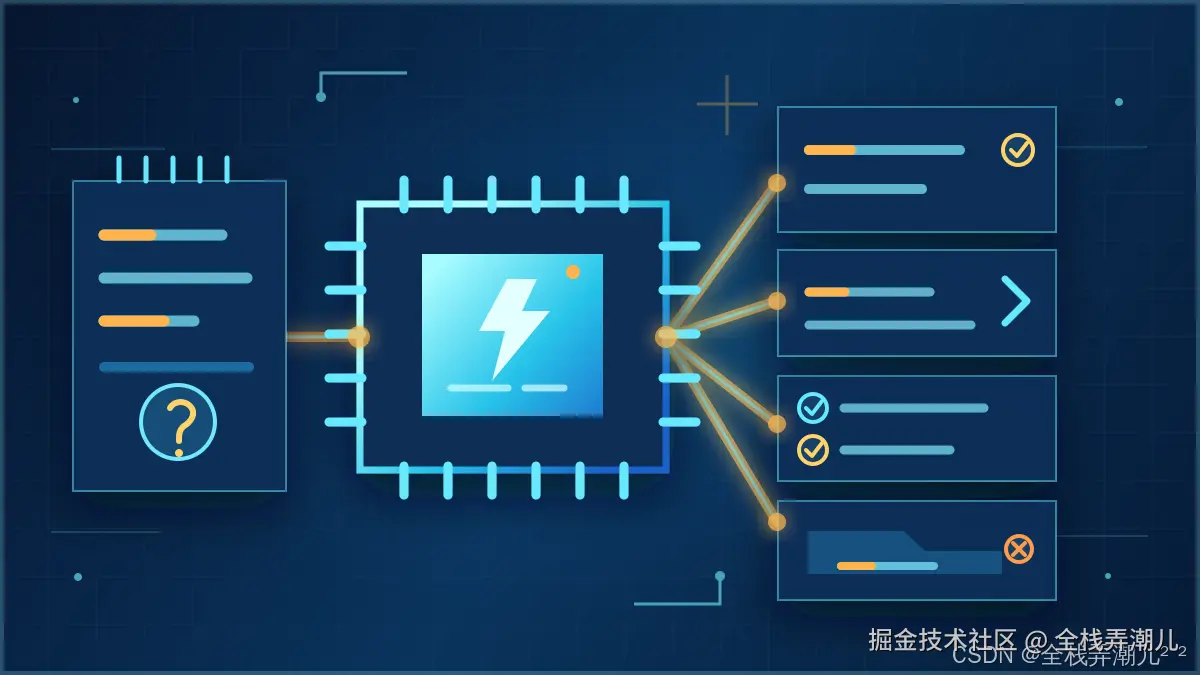
类比:output parser 是让 AI 用"自由发挥"的方式填表,你事后检查纠错;tool call 是直接递给 AI 一张官方答题卡——它收到 schema 的那一刻就知道该往哪个格子填什么,格式不会错,因为这是它吃饭的本事。
tool-call-args.mjs:答题卡长这样
const scientistSchema = z.object({
    name: z.string().describe('姓名'),
    birth_year: z.number().describe('出生年份'),
    nationality: z.string().describe('国籍'),
    fields: z.array(z.string()).describe('研究领域列表'),
});

const modelWithTool = model.bindTools([
    {
        name: 'extract_scientist_info',
        description: '提取和结构化科学家的详细信息',
        schema: scientistSchema,
    }
]);

const response = await modelWithTool.invoke('介绍一下爱因斯坦');
console.log(response.tool_calls[0].args);
bindTools 把 schema 包装成一个"工具"绑给模型。模型收到"介绍一下爱因斯坦",会自动决定调用 extract_scientist_info 这个工具,参数就是结构化的:
{
  "name": "阿尔伯特·爱因斯坦",
  "birth_year": 1879,
  "nationality": "瑞士/美国",
  "fields": ["理论物理", "量子力学"]
}
这次文件末尾多了一行注释,画出了完整的流程:
// que -> llm 生成 -> tool 想解决 -> schema 解析参数 -> 结构化数据
用户问题 → LLM 生成 → 工具想解决 → schema 解析参数 → 结构化数据。工具没被执行,它只是"想解决"——LLM 生成参数的过程本身就是结构化输出。
tool call 的问题:太"底层"了
但 bindTools 有个毛病——它暴露了太多细节:你要自己起工具名(extract_scientist_info)、自己写描述('提取和结构化科学家的详细信息')、自己从 response.tool_calls[0].args 里取数据。
readme 点破了:
"为了语义化,langchain 封装了 withStructuredOutput(schema)。高阶的 API,它的内部实现 tool call。"
bindTools 是底层机制,withStructuredOutput 是语义化封装。
三、withStructuredOutput:把野路子变成正规军
with-structured-output.mjs 是今天的核心 demo:
import { ChatOpenAI } from "@langchain/openai";
import { z } from "zod";

const model = new ChatOpenAI({ ... });

const scientistSchema = z.object({
    name: z.string().describe('姓名'),
    birth_year: z.number().describe('出生年份'),
    nationality: z.string().describe('国籍'),
    fields: z.array(z.string()).describe('研究领域列表'),
});

// tool call 讨巧的做法,升级为语义化更好的 withStructuredOutput
// 底层 tool call
const structuredModel = model.withStructuredOutput(scientistSchema);

const result = await structuredModel.invoke('介绍一下爱因斯坦');
console.log(result);
console.log('-----------------');
console.log(JSON.stringify(result, null, 2));
代码注释说得明明白白:
"tool call 讨巧的做法,升级为语义化更好的 withStructuredOutput。底层 tool call。"
对比 bindTools 和 withStructuredOutput
| 对比项 | bindTools(底层) | withStructuredOutput(高层) |
|---|---|---|
| 要起工具名 | 是(extract_scientist_info) | 不需要 |
| 要写工具描述 | 是 | 不需要 |
| 取数据 | response.tool_calls[0].args | 直接 result |
| 可读性 | 低 | 高 |
| 返回结构 | 带工具调用的完整响应 | 纯结构化数据 |
withStructuredOutput(schema) 返回一个结构化模型——你传一个 Zod Schema 进去,得到一个新模型。这个模型的行为跟普通模型一样(有 invoke、stream),但返回的一定是符合 schema 的结构化数据。
一行 API,从"求 AI 给 JSON"升级成"AI 直接给数据"。
降级机制:不是所有模型都支持 tool call
readme 特意提了一句:
"有的大模型不支持 tool call,降级为使用 Prompt + JSON 描述来做。"
withStructuredOutput 内部会自动检测模型能力:
模型支持 tool call?
  ├── 是 → 走 tool call 机制(原生、严格)
  └── 否 → 降级为 Prompt + JSON 描述(output parser 老路)
你永远只写一份代码,LangChain 帮你选最优路径。 这就是高阶 API 的价值——把复杂留给自己,把简单留给开发者。
四、终极进化线
readme 更新后给出了完整的进化线:
"JsonOutputParser → StructuredOutputParser(fromNamesAndDescriptions + fromZodSchema)→ tool call(args) → model.withStructuredOutput(schema) 可读性。"
JsonOutputParser         只要合法 JSON
    ↓
StructuredOutputParser   固定字段名(fromNamesAndDescriptions)
    ↓
StructuredOutputParser   精确类型(fromZodSchema)
    ↓
tool call(args)          原生机制、更严格(但太底层)
    ↓
withStructuredOutput     语义化封装、可读性最高(终极形态)
从下往上看,每一级都比上一级"更省心、更可靠"。整条线的本质,是把控制权从 prompt 技巧转移到模型原生能力——你越少依赖"说服 LLM",输出就越稳定。
五、那 output parser 是不是可以丢了?
readme 亲手问出了这个问题:
"output-parser 模块是不是可以丢了?"
然后自己回答:
"不可以。格式化输出,不知有 JSON 格式,XML、YAML 等。推荐用的是 model.withStructuredOutput,格式特殊,用 output_parser 解析。"
注意这里的错别字"不知"应该是"不止"——意思很明确:JSON 不是唯一的格式化输出需求。
- JSON →
withStructuredOutput(默认首选) - XML、YAML 等特殊格式 →
output_parser
xml-output-parser.mjs:XML 格式的兜底
import { XMLOutputParser } from "@langchain/core/output_parsers";

const parser = new XMLOutputParser();

const question = `
请提取一下文本中的任务信息:爱因斯坦生于1879年,是一位伟大的物理学家。
${parser.getFormatInstructions()}
`;

const response = await model.invoke(question);
const result = parser.parse(response.content);
同样的套路——getFormatInstructions() 约束 prompt,parse() 解析结果。只不过这次约束的是 XML 格式。
文件开头的注释是一段很有意思的技术考古:
// xml -> json
// <h1>title<span>副标题<b>qxh❤zzy</b></span></h1> 老钱 老一代的数据交换标准
// {
//     "title": "title",
// }
// fetch 后端api,返回json 格式 数据交换的事实标准
// XMLHttpRequest 老时代数据交换 xml ajax
信息量很大:
| 时代 | 数据交换格式 | 载体 |
|---|---|---|
| 老一代 | XML | XMLHttpRequest(ajax) |
| 现在 | JSON | fetch |
XMLHttpRequest 名字里的 XML 就是历史遗留——当年 Ajax 刚出现时以为世界会以 XML 交换数据,结果 JSON 成了事实标准。但 XML 没死——有些老系统、有些特殊场景还在用。所以 XMLOutputParser 依然有存在的价值。
特殊格式用 output_parser,常规 JSON 用 withStructuredOutput——readme 的最终结论:
"推荐用的是 model.withStructuredOutput,格式特殊,用 output_parser 解析。"
六、流式 + 结构化:答题卡也可以边填边看
上上期讲了流式输出(SSE 水管),上期讲了结构化输出。今天的新 demo——两者合体:流式结构化输出。
stream-with-structured-output.mjs:
const schema = z.object({
    name: z.string().describe('姓名'),
    birth_year: z.number().describe('出生年份'),
    death_year: z.number().describe('死亡年份'),
    nationality: z.string().describe('国籍'),
    occupation: z.string().describe('职业'),
    famous_work: z.array(z.string()).describe('著名的作品'),
    biography: z.array(z.string()).describe('简短传记'),
});

const structuredModel = model.withStructuredOutput(schema);

const prompt = `详细莫扎特信息。`;

const stream = await structuredModel.stream(prompt);  // stream 替代 invoke
let chunkCount = 0;
let result = null;

for await (const chunk of stream) {
    chunkCount++;
    console.log(chunk);
    result = chunk;
    console.log(JSON.stringify(result, null, 2));
}
console.log(result);
console.log(`接收流式数据完成,共接收 ${chunkCount} 个 chunk`);
withStructuredOutput + stream = 结构化流式
structuredModel.stream(prompt) — withStructuredOutput 返回的模型支持 stream() 方法。流式输出和结构化约束可以同时生效——LLM 一边生成,一边按 schema 校验,每个 chunk 都是合法的结构化片段。
代码在循环里不断更新 result——最后一个 chunk 就是完整结果。每个 chunk 用 JSON.stringify(result, null, 2) 打印成可读格式,方便观察结构化数据的生成过程。
为什么需要流式结构化?
想想场景——LLM 生成一篇长回答(比如莫扎特传记),普通 invoke 要等几十秒。流式让用户边等边看,体验好。但纯文本流式容易,结构化数据怎么流式?
答案:每个 chunk 都是一个合法的部分结构化对象——字段名、嵌套结构在生成过程中就是正确的。这就是 withStructuredOutput 内部 tool call 机制的功劳——它约束了 LLM 从第一个 token 起就按 schema 输出,而不是"先生成散文,最后再转 JSON"。
另一个文件:骨架占位
stream-structured-partial.mjs 只有一行注释:
// 流式结构化输出,
看起来是课堂先建了骨架文件,真正的实现写在 stream-with-structured-output.mjs 里。这个文件说明课堂是从命名开始逐步搭建 demo——学习路径本身也是从"建文件、写注释"开始的。
七、数据落地:结构化数据的终点是数据库
拿到了结构化数据,然后呢?——存起来。
create-table.mjs 用 mysql2 连接 MySQL,建了一个 friends 表:
import mysql from 'mysql2/promise';

const connetionConfig = {
    host: "localhost",
    port: 3307,          // 注意:3307,不是默认的3306
    user: "root",
    password: "123456",
    multipleStatements: true,
};

const connection = await mysql.createConnection(connetionConfig);

await connection.query(`
    CREATE DATABASE IF NOT EXISTS hello
    CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
`);
await connection.query(`USE hello;`);

await connection.query(`
    CREATE TABLE IF NOT EXISTS friends (
        id INT AUTO_INCREMENT PRIMARY KEY,
        name VARCHAR(50) NOT NULL,
        gender VARCHAR(10),                -- 性别
        birth_date DATE,                   -- 出生日期
        company VARCHAR(100),              -- 公司
        title VARCHAR(100),                -- 职位
        phone VARCHAR(20),                 -- 当前手机号
        wech@t VARCHAR(50)                 -- 微信号
    )
`);
几个值得注意的细节:
端口 3307 不是 3306
默认 MySQL 端口是 3306,这里用 3307——说明本机可能有多个 MySQL 实例,或者用了 Docker 端口映射(前面学的 Docker 知识:宿主机端口:容器端口,3307 映射到容器内的 3306)。
utf8mb4 + utf8mb4_unicode_ci
CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci
utf8mb4:完整的 UTF-8——支持四字节字符(emoji 等)utf8mb4_unicode_ci:排序规则,ci= case insensitive(不区分大小写)
如果用老式的 utf8,遇到 emoji 会直接报错。建库就用 utf8mb4 是现在的标准实践。
friends 表:通讯录字段
friends 表存的是"朋友"信息——姓名、性别、出生日期、公司、职位、手机号、微信号。每一列都有注释,对应结构化数据的一个字段。
注意这里跟结构化输出的联系——如果把"提取朋友信息"交给 LLM(比如从一段聊天记录里提取),LLM 结构化输出的字段就正好对应这张表的列。tool call 提取结构化数据 → 存入 friends 表,一条完整的 AI 数据流水线:
一段文字(聊天记录/简历)
  ↓ withStructuredOutput(schema 校验)
结构化 JSON
  ↓ INSERT INTO friends
MySQL 数据库
create-table.mjs 出现在这批文件里不是巧合——它是整条流水线的最后一环:数据落地。
八、选型决策树(最终版)
把几节课的结构化输出知识汇总成最终决策树:
需要 LLM 返回结构化数据?
  │
  ├── 常规 JSON 格式?
  │     └── 是 → model.withStructuredOutput(schema)   ← 首选,语义化 + 自动降级
  │           ├── 要流式? → .stream()
  │           └── 要同步? → .invoke()
  │
  ├── XML / YAML 等特殊格式?
  │     └── 是 → XmlOutputParser 等 output_parser
  │           (getFormatInstructions 约束 + parse 解析)
  │
  └── 想了解底层原理?
        └── bindTools + tool_calls[0].args(手动版 tool call)
readme 的最终结论一句话总结:
"推荐用的是 model.withStructuredOutput,格式特殊,用 output_parser 解析。"
九、整个系列的知识地图
把几节课串起来,结构化输出系列的完整地图:
第一课:JsonOutputParser      —— 能拿到 JSON 就行
第二课:StructuredOutputParser —— 字段名 + 类型都固定(fromNamesAndDescriptions / fromZodSchema)
第三课:tool call              —— LLM 原生机制,更严格更准确(bindTools 手动版)
第四课:withStructuredOutput   —— 语义化封装,内部走 tool call,不支持则自动降级
第五课:流式结构化输出          —— withStructuredOutput().stream(),边生成边校验
第六课:XMLOutputParser        —— 特殊格式兜底,output parser 存在的意义
第七课:create-table           —— 结构化数据的终点:落库
每一课解决一个具体问题,最终拼成完整的答案。
PS:回到上期那个灵魂拷问——"output parser 还有存在的必要吗?"今天的答案是:JSON 用 withStructuredOutput,XML/YAML 特殊格式用 output_parser,两手抓,两手都要硬。LLM 天生会填官方答题卡(tool call),但遇到 XML 这种"方言考卷",还是得靠 output_parser 这个翻译在旁边兜底。