拆解 OmniDocBench:评测机制与开源、闭源 OCR 模型接入实战
评估真实 PDF 解析系统时,只看字符准确率往往会掩盖结构错误:文字虽然识别正确,表格关系、公式格式或阅读顺序却可能已经丢失。OmniDocBench 将这些能力纳入统一评测链路,关键不仅在指标,还在预测结果如何与结构化标注匹配。下面将从这一主线梳理框架原理及模型接入过程。
本文不仅介绍 OmniDocBench 是什么,更重点讨论:它是如何评测 OCR / Document AI 模型的,以及如何把自己的开源模型、闭源 API 模型接入统一的评测体系。
1. 为什么 OCR 不能只看 Accuracy?
如果只是识别一张身份证、一行文字或者一段扫描文本,那么传统 OCR(Optical Character Recognition,光学字符识别)的 Accuracy(准确率)确实可以提供一定参考。
但真实世界中的 PDF 文档远比“识别文字”复杂。
例如下面这样一页论文:
┌──────────────────────────────────────┐
│                Title                 │
├───────────────────┬──────────────────┤
│ Paragraph         │ Figure           │
│ Paragraph         │                  │
│ Paragraph         │                  │
├───────────────────┴──────────────────┤
│              Formula                 │
├──────────────────────────────────────┤
│              Table                   │
│                                      │
└──────────────────────────────────────┘
一个完整的 Document AI(文档人工智能)系统需要同时解决:
- 文本识别
- 标题识别
- 段落识别
- 表格识别
- 公式识别
- 图片 / 图表识别
- 版面布局识别
- 阅读顺序恢复
- 表格结构恢复
- 数学公式结构恢复
- Markdown / HTML 等结构化结果生成
因此:
Document Parsing(文档解析)不是简单的 OCR。
假设两个模型最终都识别出了:
The total revenue increased by 20%.
从传统 OCR 的角度看,两者可能都是 100 分。
但是如果原始 PDF 是:
              Revenue
┌───────────────────────────────┐
│ 2023 │ 100M │ +20%            │
│ 2024 │ 120M │ +20%            │
└───────────────────────────────┘
模型 A 输出:
| 2023 | 100M | +20% |
| 2024 | 120M | +20% |
模型 B 输出:
2023 100M +20%
2024 120M +20%
两者的文字内容可能差别不大,但文档结构完全不同。
这就是 OmniDocBench 要解决的问题。
2. OmniDocBench 是什么?
OmniDocBench 可以理解为一个面向真实 PDF 文档解析场景的综合 Benchmark(基准测试 / 基准评测)框架。
它不是单纯测试 OCR,而是围绕整个文档解析链路建立评测体系。
官方当前数据集包含:
- 1651 个 PDF 页面
- 10 种文档类型
- 5 种布局类型
- 5 种语言类型
- 28 类 Block-Level(块级)标注
- 4 类 Span-Level(跨度级)标注
- Reading Order(阅读顺序)
- Page Attribute(页面属性)
- Text Attribute(文本属性)
- Table Attribute(表格属性)
同时支持:
- End-to-End Evaluation(端到端评测)
- Layout Detection(版面布局检测)
- Table Recognition(表格识别)
- Formula Recognition(公式识别)
- Text OCR(文本识别)
以及:
- Normalized Edit Distance(归一化编辑距离)
- BLEU(基于 n-gram 重叠的文本生成评价指标)
- METEOR(基于词元匹配的文本生成评价指标)
- TEDS(Tree Edit Distance based Similarity,基于树编辑距离的相似度)
- COCODet / COCO Detection Metrics(COCO 目标检测评价指标)
等指标。
官方当前仓库已经更新到 v1.7。
其中 v1.6 引入了 MGAM(Multi-Granularity Adaptive Matching,多粒度自适应匹配),v1.7 又加入了 Qianfan-OCR leaderboard(排行榜)和 skills-based evaluation(基于能力项的评测);2026 年 7 月还增加了社区维护的 EvalScope 集成,用于 OpenAI-compatible model endpoint(OpenAI 兼容模型服务端点)的统一评测。
3. OmniDocBench 的核心思想
如果把整个评测流程抽象出来,大致可以理解为:
                    OmniDocBench
                         │
                         ▼
                ┌─────────────────┐
                │   Ground Truth  │
                │   真实标注数据   │
                └────────┬────────┘
                         │
                         │
                         ▼
┌───────────────┐    ┌───────────────┐
│ OCR / VLM /   │──▶│   Prediction  │
│ Document AI   │    │   预测结果     │
└───────────────┘    └───────┬───────┘
                             │
                             ▼
                     ┌───────────────┐
                     │    Matching   │
                     │     匹配       │
                     └───────┬───────┘
                             │
              ┌──────────────┼──────────────┐
              ▼              ▼              ▼
           Text            Table          Formula
           文本             表格             公式
              │              │              │
              ▼              ▼              ▼
           Metric          Metric         Metric
           指标计算          指标计算         指标计算
              │              │              │
              └──────────────┼──────────────┘
                             ▼
                    Result / Report
                       结果 / 报告
这里最关键的并不是 Metric(指标)本身。
而是:
Prediction → Matching → Metric
也就是:
模型输出什么 → 和 Ground Truth 怎么对应 → 最后怎么计算分数。
这也是理解 OmniDocBench 源码最重要的一条主线。
4. OmniDocBench 的数据集结构
一个典型的数据目录可以理解为:
OmniDocBench/
├── images/
│   ├── xxx.jpg
│   ├── xxx.jpg
│   └── ...
│
├── pdfs/
│   ├── xxx.pdf
│   ├── xxx.pdf
│   └── ...
│
└── OmniDocBench.json
其中:
images/
保存页面图像。
pdfs/
保存对应 PDF。
而:
OmniDocBench.json
保存完整的结构化 Ground Truth(真实标注 / 标准答案)。
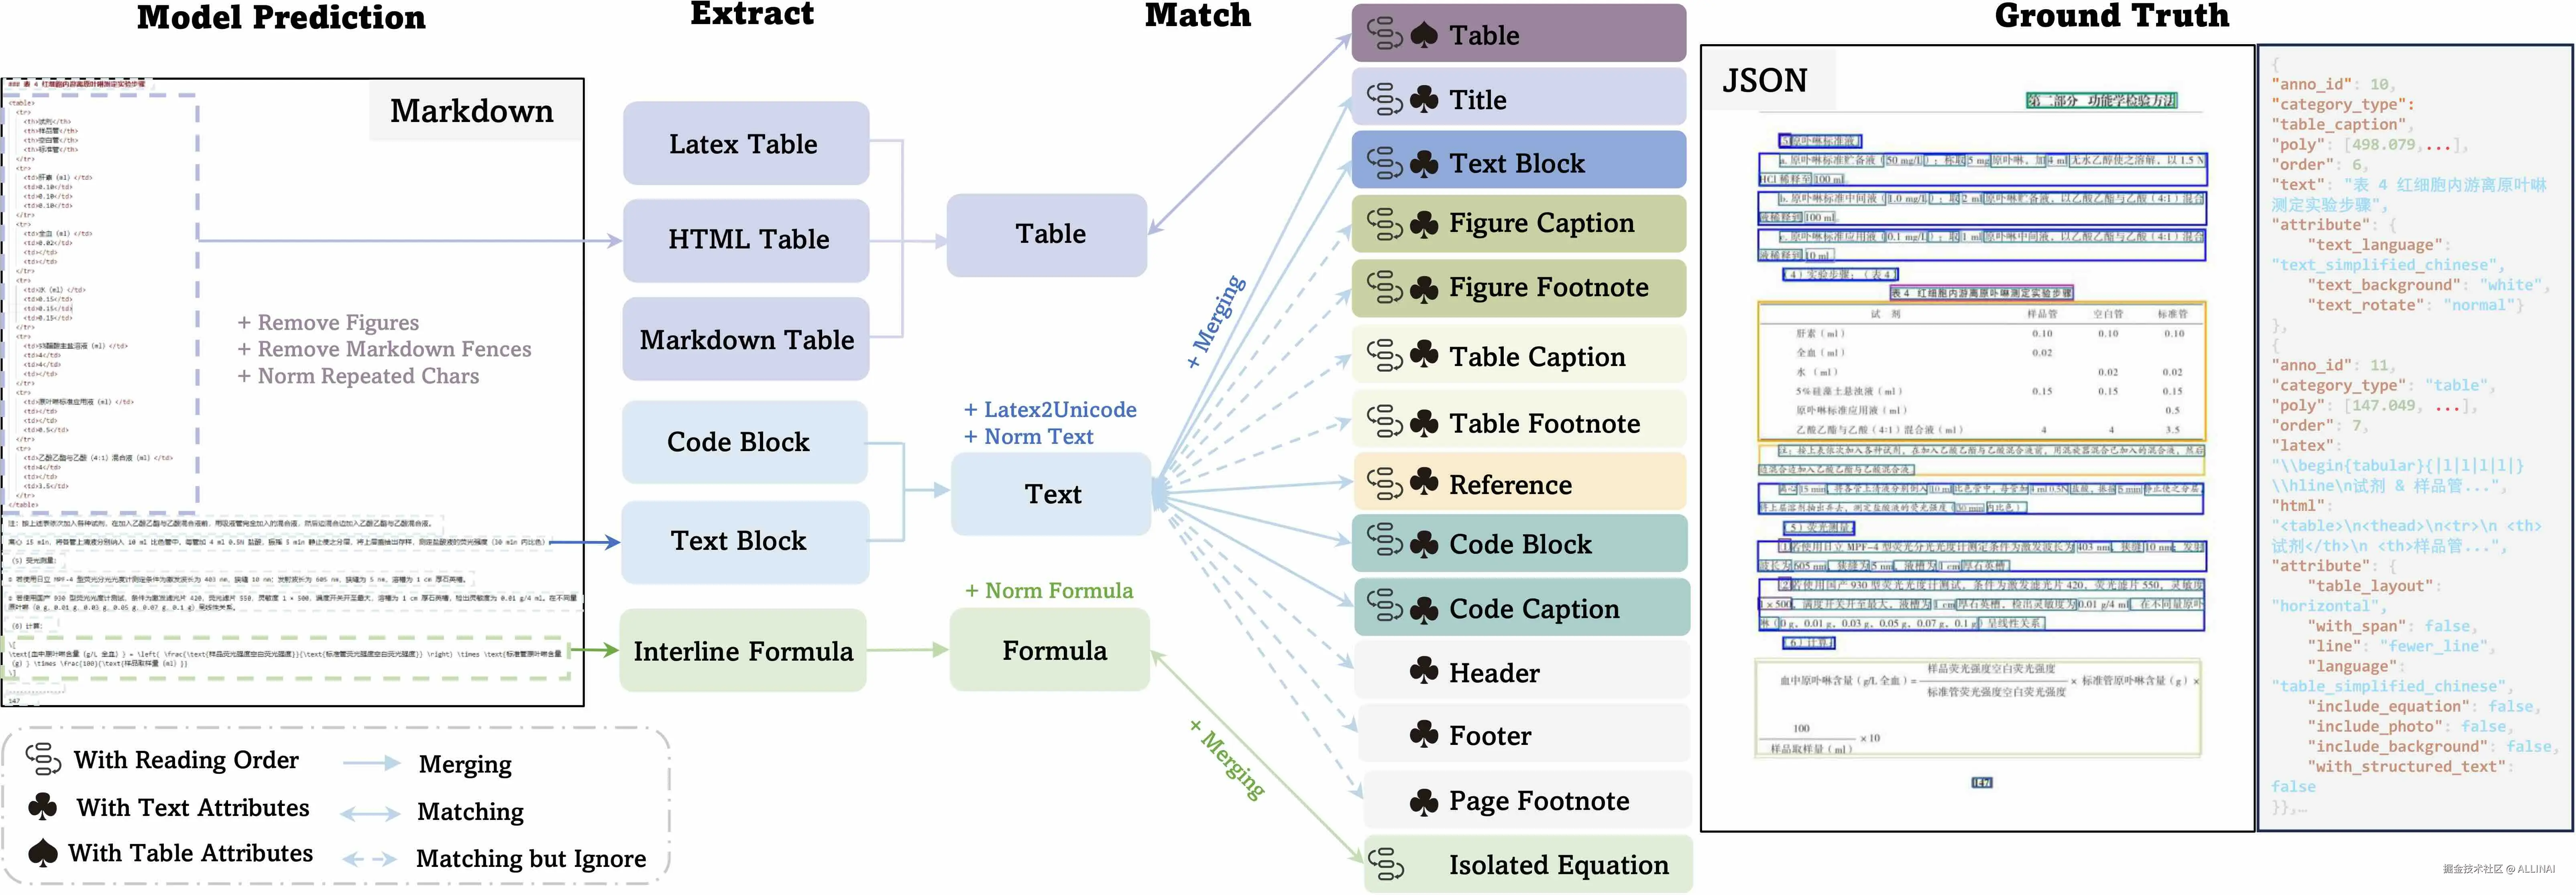
它并不只是保存纯文本,还包含文档元素的位置、类别、内容、属性以及阅读顺序等信息,例如:
layout_dets
category_type
poly
ignore
order
anno_id
text
latex
html
attribute
line_with_spans
merge_list
page_info
因此,一个非常重要的认识是:
OmniDocBench 的核心 Ground Truth 是结构化 JSON,而不是简单的 Markdown。
这点对于理解后面的 End-to-End Evaluation 非常重要。
4.1 End-to-End Prediction 为什么是 Markdown?
在官方 End-to-End Evaluation(端到端评测)中,模型需要提供整页 PDF 解析结果。
Prediction(预测结果)通常以每页一个 Markdown 文件的形式保存:
images/
    page_001.jpg
    page_002.jpg

prediction/
    page_001.md
    page_002.md
对应关系:
page_001.jpg
      │
      ▼
OCR / VLM / Document Parser
      │
      ▼
page_001.md
这里需要特别注意:
“模型的 End-to-End Prediction 使用 Markdown”并不等于“OmniDocBench 的 Ground Truth 就是 Markdown”。
官方实际上提供两种 End-to-End Evaluation 方式:
                     End-to-End Evaluation
                              │
                 ┌────────────┴────────────┐
                 ▼                         ▼
              end2end                     md2md
                 │                         │
        JSON Ground Truth         Markdown Ground Truth
                 │                         │
                 └────────────┬────────────┘
                              │
                              ▼
                    Markdown Prediction
其中:
end2end
是官方更推荐的方式。
因为它能够保留 OmniDocBench JSON 中的:
category
attribute
ignore
order
page_info
等结构化信息,从而支持更细粒度的评测、过滤和 Attribute-Level Evaluation(属性级评测)。
5. Block-Level 和 Span-Level
理解 OmniDocBench 的 Annotation(标注)体系非常重要。
5.1 Block-Level
Block-Level(块级)主要描述页面中的较大结构区域。
例如:
Text
Title
Table
Figure
Formula
Header
Footer
...
可以把它理解为:
Page
 ├── Title
 ├── Text
 ├── Figure
 ├── Table
 ├── Formula
 └── Text
每一个 Block 通常具有:
bbox
category
text
attribute
order
其中:
bbox:区域坐标category:元素类别text:识别内容attribute:元素属性order:阅读顺序
6. Span-Level
Span-Level(跨度级)更加细粒度。
例如一段文本:
The equation x² + y² = z² is important.
其中可能进一步标记:
Text
 ├── Text Line
 ├── Inline Formula
 ├── Subscript
 └── Text
因此 OmniDocBench 并不是:
Page → OCR
而是:
Page
 │
 ├── Block
 │    ├── Text
 │    ├── Table
 │    ├── Formula
 │    └── Figure
 │
 └── Span
      ├── Text Line
      ├── Inline Formula
      └── Subscript
这种设计使得评测可以从“整页分数”进一步深入到:
到底是哪一种文档元素出了问题?
7. Attribute-Level Evaluation(属性级评测)
OmniDocBench 一个非常有价值的设计是 Attribute-Level Evaluation。
例如某些页面可能具有:
handwritten
dense_text
multi_column
complex_table
formula
那么最终可以得到类似:
Overall Score: 82.4

Dense Text:       75.2
Complex Table:    61.8
Formula:          89.4
Handwritten:      72.1
Multi Column:     84.7
这比单纯输出:
Score = 82.4
有意义得多。
因为工程师真正需要知道的是:
模型为什么只有 82 分?
如果发现:
Text       95
Formula    92
Table      58
那么模型的问题显然集中在 Table Recognition(表格识别)。
这直接影响 Model Selection(模型选型)。
而这也是官方推荐 end2end 的重要原因之一:JSON Ground Truth 保留了更加丰富的类别和属性信息,可以进一步做属性级结果分析。
8. OmniDocBench 的 Evaluation Pipeline
从工程角度,可以把评测流程拆成:
Dataset
   │
   ▼
Ground Truth Loader(真实值加载)
   │
   ▼
Prediction Loader(预测值加载)
   │
   ▼
Normalization(归一化)
   │
   ▼
Matching(匹配)
   │
   ▼
Metric Calculation(指标计算)
   │
   ▼
Attribute Aggregation(属性聚合)
   │
   ▼
Report
对应源码通常可以理解成几个核心模块:
dataset
task
metrics
registry
configs
tools
utils
其中:
dataset
负责数据读取和数据结构处理。
task
负责不同任务。
metrics
负责具体指标计算。
registry
负责任务、数据集、Metric 等对象注册。
configs
负责 YAML 配置。
tools
负责数据转换、可视化、模型推理等工具。
9. Matching:真正容易被低估的核心模块
很多人第一次接触 Benchmark 时会认为:
Prediction
    ↓
Metric
    ↓
Score
实际上中间还有一个非常重要的过程:
Prediction
    ↓
Matching
    ↓
Metric
假设 Ground Truth 是:
Paragraph A
Paragraph B
Paragraph C
模型输出:
Paragraph A + B
Paragraph C
那么:
GT:
A
B
C

Prediction:
A+B
C
到底怎么比较?
如果简单按照:
A ↔ A+B
B ↔ ?
C ↔ C
就会产生明显的评分偏差。
因此:
Matching 并不是一个简单的数据结构操作,而是整个 Benchmark 公平性的核心之一。
10. no_split / simple_match / quick_match
OmniDocBench 提供多种匹配方式。
10.1 no_split
match_method: no_split
可以理解为:
不进行细粒度文本块匹配,直接把内容整体拼接后进行比较。
优点:
- 简单
- 快
- 不容易受到段落切分影响
缺点:
- 无法提供足够细粒度的结果
- 定位问题能力较弱
- 不适合分析复杂的结构差异
11. simple_match
match_method: simple_match
首先进行段落切分:
Prediction
   │
   ├── Paragraph 1
   ├── Paragraph 2
   └── Paragraph 3
然后进行一对一匹配。
它比 no_split 更精细,但要求模型的 Paragraph Segmentation(段落分段)比较准确。
12. quick_match(快速匹配)
在官方 End-to-End 配置中,quick_match 是一个非常常见的匹配方式。
match_method: quick_match
它在基础分段的基础上加入:
- Truncation(截断)
- Merging(合并)
- Adjacency Search(邻接搜索)
目的就是:
减少模型仅仅因为段落切分方式不同而产生的非必要扣分。
例如 Ground Truth:
A
B
C
Prediction:
A+B
C
quick_match 会尝试找到更加合理的匹配关系。
因此:
模型识别错误
和:
模型只是分段方式不同
能够更好地区分。
官方当前 End-to-End 配置示例也使用 quick_match,并提供了与匹配超时、Fallback(回退)相关的参数。
13. MGAM:v1.6 之后非常重要的变化
OmniDocBench v1.6 引入 MGAM:
MGAM(Multi-Granularity Adaptive Matching,多粒度自适应匹配)
它解决的是 Matching Bias(匹配偏差)问题。
核心思想可以概括为:
Ground Truth
     │
     │ 保持不变
     ▼
┌─────────────────────┐
│ Prediction          │
│                     │
│ Granularity 1       │
│ Granularity 2       │
│ Granularity 3       │
│ ...                 │
└──────────┬──────────┘
           │
           ▼
      Search Best Match
        搜索最佳匹配
也就是说:
不改变 Ground Truth,而是在 Prediction(预测结果)侧寻找更加合理的分段粒度。
这对于 Document Parsing 特别重要。
例如:
GT:
┌─────────────────────┐
│ 一个完整的大段落       │
└─────────────────────┘
模型可能输出:
Line 1
Line 2
Line 3
Line 4
Line 5
如果直接做 Block-Level Matching,模型可能因为预测粒度不同而受到明显影响。
MGAM 的目标就是减少这种由预测粒度差异造成的 Matching Bias。
官方 v1.6 更新说明也明确描述了这一设计:保持 Ground Truth 不变,只在 Prediction 一侧进行自适应粒度调整。
14. Text OCR 的评测
Text OCR 主要关注:
GT Text
    ↕
Prediction Text
核心指标之一是:
Normalized Edit Distance(归一化编辑距离)
15. Edit Distance 是什么?
Edit Distance(编辑距离)用于衡量两个字符串之间需要多少次编辑操作才能互相转换。
例如:
GT:
hello

Prediction:
helo
只需要删除一个 l。
因此:
Edit Distance = 1
常见编辑操作包括:
Insert
Delete
Replace
也就是:
- 插入
- 删除
- 替换
16. 为什么需要 Normalized Edit Distance?
因为:
hello
和:
This is a very long paragraph...
长度完全不同。
如果直接使用 Edit Distance:
error = 5
对短文本和长文本的意义不同。
因此需要进行归一化。
可以简单理解成:
Normalized Error
≈
Edit Distance / Reference Length
然后进一步转换成:
Similarity
=
1 - Normalized Error
实际实现应以 OmniDocBench 当前代码中的定义为准。
核心思想就是:
减少文本长度差异对最终评分的影响。
17. CER / WER 与 OmniDocBench
传统 OCR 系统经常使用:
CER
WER
其中:
- CER(Character Error Rate,字符错误率)
- WER(Word Error Rate,词错误率)
但对于多语言 Document Parsing:
中文
英文
公式
符号
特殊字符
Markdown
单纯使用 CER / WER 并不能完整描述文档解析质量。
因此 OmniDocBench 使用更加适合其场景的 Normalized Edit Distance,同时结合表格、公式和布局等其他指标。
18. Table Recognition:表格为什么不能只做文本比较?
考虑:
A | B
--|--
1 | 2
3 | 4
和:
A B
1 2
3 4
文字内容可能完全一致。
但第一种保留了:
Column
Row
Cell
结构。
第二种没有。
因此 Table Recognition(表格识别)需要同时评价:
Content
+
Structure
这也是 TEDS 出现的原因。
19. TEDS
TEDS:
TEDS(Tree Edit Distance based Similarity,基于树编辑距离的相似度)
它把 HTML Table 看成一棵树。
例如:
<table>
  <tr>
    <td>A</td>
    <td>B</td>
  </tr>
</table>
可以抽象成:
table
 └── tr
      ├── td
      └── td
因此比较的就不只是:
A
B
而是:
Table Structure
+
Cell Structure
+
Cell Content
这就是为什么:
表格评测不能简单地使用字符串 Edit Distance。
20. Formula Recognition:公式为什么更特殊?
假设 Ground Truth:
x^2 + y^2 = z^2
模型输出:
x^{2}+y^{2}=z^{2}
从字符串角度:
不完全一致
但是从公式的视觉表现来看:
可能完全等价
因此 Formula Recognition(公式识别)需要更加特殊的指标。
OmniDocBench 中使用:
CDM
用于公式的视觉层面比较。
核心思路可以理解为:
LaTeX
  │
  ▼
Rendering(渲染)
  │
  ▼
Image
  │
  ▼
Visual Similarity(视觉相似度)
也就是说:
Formula String
最终被转换成:
Rendered Formula Image
然后再进行视觉比较。
这解决了大量:
LaTeX 写法不同
但:
最终视觉结果相同
的情况。
21. Layout Detection
Layout Detection(版面布局检测)关注:
Where?
What?
也就是:
这个区域在哪里?
这个区域是什么类型?
例如:
┌─────────────────────────┐
│          Title          │
├─────────────┬───────────┤
│ Text        │ Figure    │
│ Text        │           │
├─────────────┴───────────┤
│          Table          │
└─────────────────────────┘
模型需要预测:
bbox
category
这类任务本质上与目标检测类似。
因此 OmniDocBench 使用:
COCODet / COCO Detection Metrics(COCO 目标检测评价指标)
包括:
mAP
mAR
其中:
- mAP(mean Average Precision,平均精度均值)
- mAR(mean Average Recall,平均召回率均值)
22. End-to-End Evaluation
End-to-End Evaluation(端到端评测)是 OmniDocBench 最值得关注的能力之一。
它不是:
只评 OCR
也不是:
只评 Layout
而是直接评价模型对整页 PDF 文档的解析能力。
整体流程可以理解为:
PDF Page
   ↓
Document Parser
   ↓
Markdown
   ↓
OmniDocBench
   ↓
整体评测
但是这里有一个非常容易被误解的地方:
OmniDocBench 的 End-to-End Evaluation 并不只有一种评测方式。
官方提供:
End-to-End Evaluation
        │
        ├── end2end
        │      ├── Ground Truth:OmniDocBench JSON
        │      └── Prediction:Markdown
        │
        └── md2md
               ├── Ground Truth:OmniDocBench Markdown
               └── Prediction:Markdown
官方推荐:
end2end
而不是简单地把 End-to-End 理解为:
Markdown ↔ Markdown
22.1 end2end:JSON Ground Truth + Markdown Prediction
end2end 是官方更加推荐的 End-to-End Evaluation 方式。
其输入关系是:
OmniDocBench.json
        │
        │ Ground Truth
        ▼
     Matching
        ▲
        │ Prediction
        │
page_001.md
也就是:
Ground Truth
=
OmniDocBench JSON
而:
Prediction
=
模型生成的整页 Markdown
因此:
JSON Ground Truth
        +
Markdown Prediction
        ↓
Matching
        ↓
Text / Formula / Table / Reading Order
        ↓
Metric
这种方式最大的价值在于:
JSON Ground Truth 中保存了 Markdown 本身无法完整表达的结构化标注信息。
例如:
category
attribute
ignore
order
page_info
因此官方明确推荐 end2end,因为它能够保留样本的 category 和 attribute 信息,并支持特殊类别忽略以及属性级结果输出。
22.2 end2end 评测哪些维度?
官方当前 End-to-End Evaluation 可以评测四个核心维度:
Text Paragraphs
Display Formulas
Tables
Reading Order
例如官方配置可以理解为:
end2end_eval:
  metrics:
    text_block:
      metric: [Edit_dist, BLEU, METEOR]

    display_formula:
      metric: [Edit_dist, CDM]

    table:
      metric: [TEDS, Edit_dist]

    reading_order:
      metric: [Edit_dist]

  dataset:
    dataset_name: end2end_dataset

    ground_truth:
      data_path: ./data/OmniDocBench.json

    prediction:
      data_path: ./prediction

    match_method: quick_match
其中:
ground_truth.data_path
指向 OmniDocBench JSON。
而:
prediction.data_path
指向模型输出的 Markdown 文件目录。
22.3 Prediction 目录是什么样的?
例如:
prediction/
├── page_0001.md
├── page_0002.md
├── page_0003.md
└── ...
如果原始页面图像是:
page_0001.jpg
page_0002.jpg
page_0003.jpg
那么 Prediction 就对应:
page_0001.md
page_0002.md
page_0003.md
也就是:
.jpg → .md
文件名保持对应。
官方 README 当前也明确说明,Prediction 是模型对整页 PDF 页面解析产生的 Markdown 文件目录。
23. 为什么官方推荐 end2end?
原因并不是:
JSON 比 Markdown 更高级
而是:
JSON Ground Truth 保存了更加丰富的评测信息。
例如:
category
attribute
ignore
reading order
page information
这些信息对于分析模型质量非常重要。
假设两个模型最终:
Overall Score
都差不多。
模型 A:
Text       95
Table      62
Formula    94
模型 B:
Text       91
Table      89
Formula    91
如果只做简单 Markdown-to-Markdown(Markdown 到 Markdown)比较,很多结构化信息很难进一步分析。
而 end2end 保留了 JSON Ground Truth 中的属性和类别信息,因此可以进一步做:
Attribute-Level Evaluation
Category Filtering
Ignore Rules
Page-Level Analysis
这就是官方推荐 end2end 的核心原因。
24. md2md 是什么?
md2md 可以理解为:
Markdown-to-Markdown Evaluation(Markdown 到 Markdown 评测)。
它是 OmniDocBench 提供的第二种 End-to-End Evaluation 方法。
它的结构非常直观:
Ground Truth Markdown
          ↓
       Matching
          ↑
          │
Prediction Markdown
          ↓
        Metric
这里:
Ground Truth
=
OmniDocBench Markdown
而:
Prediction
=
模型生成的整页 Markdown
也就是:
GT Markdown
      │
      │
      ▼
  Markdown Parser
      │
      ▼
   Matching
      ▲
      │
Prediction Markdown
官方保留 md2md 的主要原因,是为了与已有的 Markdown-to-Markdown 评测方式保持一致。
因此它并不是错误的方式。
只是:
如果希望充分利用 OmniDocBench 的结构化标注信息,官方更推荐
end2end。
24.1 md2md 的 Ground Truth
典型目录可以理解为:
ground_truth/
├── page_0001.md
├── page_0002.md
├── page_0003.md
└── ...
模型 Prediction:
prediction/
├── page_0001.md
├── page_0002.md
├── page_0003.md
└── ...
然后:
GT Markdown
      ↕
Prediction Markdown
      ↓
Matching
      ↓
Metrics
官方还允许配置:
ground_truth:
  data_path: ./data/mds
  page_info: ./data/OmniDocBench.json
其中:
page_info
主要用于获取页面级属性。
如果不需要页面属性评测,可以省略。
而如果需要基于页面属性进行:
filter
则需要提供 page_info。
25. end2end 和 md2md 到底怎么选?
可以直接记成下面这张图:
                   End-to-End Evaluation
                            │
             ┌──────────────┴──────────────┐
             │                             │
             ▼                             ▼
          end2end                         md2md
             │                             │
             ▼                             ▼
     JSON Ground Truth             Markdown Ground Truth
             │                             │
             └──────────────┬──────────────┘
                            │
                            ▼
                 Markdown Prediction
                            │
                            ▼
                        Matching
                            │
                            ▼
                        Metrics
选择建议:
如果你是在研究 OmniDocBench 本身
优先:
end2end
因为:
JSON GT
+
Markdown Prediction
可以最大程度利用 OmniDocBench 的标注信息。
如果你已经有一套 Markdown-to-Markdown 评测体系
可以使用:
md2md
这样更容易与已有 Markdown 评测结果保持一致。
因此:
md2md是官方支持的方式,但end2end是官方更推荐的方式。
26. 自己的 OCR 模型怎么接入?
这是实际开发中最重要的部分。
假设你有一个模型:
class MyOCR:
    def predict(self, image):
        ...
如果目标是做 End-to-End Evaluation,那么最常见的接入方式是:
Image
  ↓
MyOCR / Document Parser
  ↓
Markdown
  ↓
Prediction Directory
  ↓
OmniDocBench
例如:
Image
  ↓
My Model
  ↓
page_0001.md
  ↓
end2end
  ↓
OmniDocBench
关键不是修改 OmniDocBench 的 Metric。
而是:
根据你要评测的任务,把模型输出适配到 OmniDocBench 对应的 Prediction 格式。
对于 End-to-End:
模型输出
   ↓
整页 Markdown
   ↓
end2end / md2md
而对于 Text / Formula / Table Recognition(文本 / 公式 / 表格识别)等单模块任务,官方还支持结构化 JSON Prediction,因此不能简单地说“所有任务都必须转成 Markdown”。
27. Model Adapter
建议设计一个 Model Adapter(模型适配器):
class OmniDocBenchAdapter:

    def __init__(self, model):
        self.model = model

    def predict(self, image):
        result = self.model.predict(image)
        return self.to_markdown(result)

    def to_markdown(self, result):
        ...
然后:
adapter = OmniDocBenchAdapter(model)

for image in images:
    markdown = adapter.predict(image)

    save_prediction(
        image=image,
        markdown=markdown
    )
这样:
Your Model
    ↓
Adapter
    ↓
Standard Prediction
    ↓
OmniDocBench
对于 End-to-End:
Standard Prediction
=
Page-level Markdown
而对于其他单模块任务,则应该按照对应任务的 JSON Schema(JSON 数据结构)和配置要求生成 Prediction。
28. 为什么一定要设计 Adapter?
因为模型输出差异非常大。
例如:
OCR 模型
{
  "text": "hello world",
  "bbox": [10, 20, 100, 50]
}
Document VLM
# Title

This is a paragraph.

| A | B |
|---|---|
| 1 | 2 |
云端 OCR API
{
  "pages": [
    {
      "blocks": [...]
    }
  ]
}
如果直接把这些数据塞进 Benchmark:
Benchmark
 ├── Model A format
 ├── Model B format
 ├── Model C format
 └── Model D format
很快就会失控。
更合理的是:
                   ┌── Model A
                   │
                   ├── Model B
                   │
                   ├── Model C
                   │
                   └── Model D
                         │
                         ▼
                 ┌──────────────┐
                 │    Adapter   │
                 └──────┬───────┘
                        ▼
                Standard Output
                        │
                        ▼
                 OmniDocBench
这里的 Standard Output(标准化输出)应该根据具体任务确定:
End-to-End
    ↓
Markdown

Single-module Recognition / Detection
    ↓
JSON
这样才是真正可扩展的架构。
29. 评测开源 OCR 模型
对于 Open Source Model(开源模型),通常有三种接入方式。
29.1 本地 OCR Engine
例如:
PaddleOCR
Tesseract
EasyOCR
模型部署在本地。
流程:
Image
 ↓
Local OCR Engine
 ↓
JSON / Text
 ↓
Markdown Builder
 ↓
Prediction
 ↓
OmniDocBench
这种方式的优点:
- 无 API 成本
- 可离线
- 可重复
- 可以控制模型版本
- 可以控制 GPU
- 方便 Debug
缺点:
- 需要维护模型环境
- GPU 资源成本较高
- 不同模型部署复杂度不同
30. Document VLM
近年来大量文档模型已经从传统 OCR 转向:
Document VLM(文档视觉语言模型)
典型形式:
Image
 ↓
Vision Encoder
 ↓
LLM
 ↓
Markdown
例如:
Qwen-VL
InternVL
MinerU
PaddleOCR-VL
DeepSeek-OCR
这种模型通常更适合:
复杂文档
表格
公式
图文混排
多栏布局
如果模型本身已经能够直接输出整页 Markdown,那么接入 End-to-End Benchmark 会非常方便:
Image
 ↓
Document VLM
 ↓
Markdown
 ↓
Prediction Directory
 ↓
end2end
31. vLLM / OpenAI-compatible Server
如果模型可以部署为:
vLLM
SGLang
OpenAI-compatible Server
那么评测会更加简单。
架构:
OmniDocBench Runner
        │
        ▼
OpenAI-compatible API
        │
        ▼
      Model
        │
        ▼
     Markdown
例如:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="EMPTY"
)
然后:
response = client.chat.completions.create(
    model="my-ocr-model",
    messages=[
        {
            "role": "user",
            "content": "Parse this document..."
        }
    ]
)
这样模型就可以被统一封装成一个:
Model Provider
官方当前仓库也已经提供了社区维护的 EvalScope 集成,可以用于 OpenAI-compatible model endpoint 的 OmniDocBench 评测。
32. 评测闭源 OCR API
闭源模型的评测方式与本地模型最大的区别是:
Inference(推理)
发生在远程服务器。
例如:
OmniDocBench
      │
      ▼
OCR API
      │
      ▼
Cloud Model
      │
      ▼
Prediction
这类模型包括:
Cloud OCR API
Document AI API
Multimodal API
对于 End-to-End Evaluation,只要最终能够把远程 API 的结果统一转换成:
page_0001.md
page_0002.md
...
就可以进入相同的评测流程。
因此:
Benchmark 不应该关心模型是在本地运行,还是通过远程 API 运行。
它只应该关心:
Input
    ↓
Prediction
    ↓
Evaluation
33. OCRProvider 抽象
建议建立统一接口:
from abc import ABC, abstractmethod


class OCRProvider(ABC):

    @abstractmethod
    def parse(self, image):
        pass
然后:
class LocalOCRProvider(OCRProvider):

    def parse(self, image):
        return local_model.predict(image)
云端:
class CloudOCRProvider(OCRProvider):

    def parse(self, image):
        return api_client.parse(image)
最终:
             OCRProvider
                 │
        ┌────────┴────────┐
        │                 │
   Local Provider    Cloud Provider
        │                 │
        ▼                 ▼
   Local Model         API Model
这样 Benchmark Runner(基准测试运行器)不需要关心:
模型到底部署在哪里?
只需要关心:
provider.parse(image)
34. DocumentParser Protocol(协议)
进一步可以抽象成:
from typing import Protocol


class DocumentParser(Protocol):

    def parse(self, image) -> str:
        """
        Return Markdown representation.
        """
        ...
所有 End-to-End 模型都遵循:
Image
  ↓
parse()
  ↓
Markdown
这样:
PaddleOCR
MinerU
Qwen-VL
GPT
Gemini
Claude
自研模型
都可以统一进入 End-to-End Benchmark。
这里要注意:
这个 Protocol 是你自己的工程抽象,并不是说 OmniDocBench 官方要求所有模型必须实现这个 Python 接口。
它只是为了让你的 Benchmark Runner 更容易统一管理不同模型。
35. 闭源 API 评测最容易忽略的问题
真正做 API Benchmark(API 基准评测)时,最大的坑通常不是代码。
而是:
Cost(成本)
Latency(延迟)
Reliability(可靠性)
Version
Prompt(提示词)
Rate Limit(速率限制)
如果这些变量没有控制好,那么:
Model A = 90
Model B = 88
并不一定意味着:
A > B
有可能只是:
Prompt 不一样
Version 不一样
输入分辨率不一样
Sampling 不一样
导致的。
36. Cost
假设:
1651 pages
每页 API 成本:
$0.01
那么:
1651 × $0.01
≈ $16.51
如果进行:
10 次实验
就是:
$165.1
所以:
API Benchmark 必须设计 Prediction Cache(预测缓存)。
37. Prediction Cache
建议 Cache Key(缓存键)包含:
model
model_version
prompt
temperature
image_hash
input_resolution
例如:
cache_key = hash(
    model +
    model_version +
    prompt +
    temperature +
    image_hash +
    input_resolution
)
这样:
相同输入
+
相同模型
+
相同 Prompt
可以直接复用预测结果。
更完整的工程实现还可以加入:
system_prompt
max_tokens
provider
API parameters
preprocessing version
避免因为实验参数变化而错误命中缓存。
38. Retry 与 Backoff
API 调用一定会出现:
Timeout
Rate Limit
Network Error
5xx
Service Unavailable
因此需要:
Retry(重试)
和:
Backoff(退避)
例如:
for attempt in range(max_retries):

    try:
        return call_api()

    except Exception:
        sleep(
            min(
                2 ** attempt,
                30
            )
        )
典型策略:
1s
2s
4s
8s
16s
实际生产环境还应该区分:
可重试错误
不可重试错误
例如:
429
5xx
Timeout
通常可以重试。
而:
Authentication Error
Invalid Request
Invalid Output
则通常应该直接记录失败。
39. Rate Limit
Rate Limit(速率限制)是闭源 API Benchmark 的另一个问题。
例如:
RPM = Requests Per Minute
TPM = Tokens Per Minute
QPS = Queries Per Second
如果你的并发:
100 workers
而 API 只允许:
20 QPS
那么:
100 workers
并不会让评测快 5 倍。
反而可能导致:
429
Timeout
Retry
最终更慢。
因此:
Concurrency(并发数)应该由模型服务能力决定,而不是由本地 CPU 数量决定。
40. Temperature
对于生成式模型:
temperature
也会影响结果。
如果 Benchmark 用于模型横向比较,通常建议:
temperature = 0
或者使用模型 API 推荐的确定性参数。
否则同一个模型:
Run 1 → 82.1
Run 2 → 80.7
Run 3 → 83.2
你很难判断:
模型变化
还是:
Sampling Randomness(采样随机性)
造成的。
因此至少应该:
固定随机性参数
固定 Prompt
固定输入
固定模型版本
41. Prompt 必须固定
如果比较:
Model A
Model B
Model C
但使用:
Prompt A
Prompt B
Prompt C
那么最终比较的其实是:
Model
+
Prompt
而不是单纯的 Model。
因此应该固定:
Prompt
Image Resolution
Temperature
Max Tokens
Model Version
然后只改变:
Model
如果不同模型必须使用不同 Prompt,那么就应该明确记录这种差异,而不能把结果直接理解成纯粹的模型能力比较。
42. Input Resolution
Input Resolution(输入分辨率)也非常重要。
例如同一张 PDF:
72 DPI
和:
200 DPI
得到的图片质量差异巨大。
尤其是:
小字体
公式
扫描文档
表格
手写内容
因此:
Benchmark 的输入必须标准化。
建议建立:
Canonical Page Image
也就是标准化页面图像。
然后所有模型使用:
同一份 Image
进行推理。
这样才能保证:
Model A
Model B
Model C
面对的是完全相同的输入。
43. Open Source vs Closed Source 的统一评测
最终可以建立:
                 Benchmark Runner
                       │
        ┌──────────────┼──────────────┐
        │              │              │
        ▼              ▼              ▼
    Local Model     API Model      VLM Server
        │              │              │
        └──────────────┼──────────────┘
                       ▼
                   Prediction
                       │
                       ▼
                 OmniDocBench
                       │
        ┌──────────────┼──────────────┐
        ▼              ▼              ▼
      Text           Table          Formula
        │              │              │
        └──────────────┼──────────────┘
                       ▼
                    Report
这样就可以做到:
Open Source Model(开源模型)和 Closed Source Model(闭源模型)在同一套数据、同一套输入、同一套 Metric 下进行比较。
真正需要标准化的不是模型本身,而是:
Dataset
Input
Prediction Format
Evaluation Config
Metric
44. 多模型横向评测
实际项目中,通常不是:
评测一个模型
而是:
Model A
Model B
Model C
Model D
例如:
models:
  - name: model_a
    provider: local

  - name: model_b
    provider: vllm

  - name: model_c
    provider: cloud
然后:
                    Benchmark Dataset
                           │
          ┌────────────────┼────────────────┐
          ▼                ▼                ▼
       Model A           Model B          Model C
          │                │                │
          ▼                ▼                ▼
      Prediction       Prediction       Prediction
          │                │                │
          └────────────────┼────────────────┘
                           ▼
                    OmniDocBench
                           │
                           ▼
                     Quality Matrix
                       质量矩阵
最终得到:
| Model | Text | Table | Formula | Overall |
|---|---|---|---|---|
| Model A | 94.2 | 72.1 | 89.4 | 85.2 |
| Model B | 91.7 | 86.3 | 92.1 | 89.4 |
| Model C | 96.1 | 80.2 | 91.7 | 89.3 |
这才是真正有工程价值的 Benchmark。
45. 不要只看 Overall Score
例如:
Model A = 90
Model B = 88
看起来:
Model A > Model B
但是进一步分析:
               Model A    Model B

Text              96        91
Table             62        89
Formula           94        91
Layout            95        90
如果你的业务是:
财务报表
那么 Model B 可能明显更好。
如果你的业务是:
普通文本 PDF
那么 Model A 可能更好。
所以:
Overall Score 用于排序,Attribute-Level Evaluation 用于决策。
46. Benchmark 的公平性问题
Benchmark 并不天然公平。
至少存在:
Dataset Bias
Metric Bias
Matching Bias
Distribution Bias
分别是:
- Dataset Bias(数据集偏差)
- Metric Bias(指标偏差)
- Matching Bias(匹配偏差)
- Distribution Bias(数据分布偏差)
例如:
Benchmark
80% English
20% Chinese
那么:
Overall Score
实际上更加偏向 English OCR。
所以真正做模型选型时:
Overall Score 只能回答“平均情况下谁更好”,不能直接回答“谁更适合我的业务”。
47. 一个更加合理的评测矩阵
建议至少按照:
Language
Document Type
Layout
Content Type
Attribute
拆分。
例如:
                  Text   Table   Formula
Chinese             95     82       91
English             97     88       93
Japanese             91     79       88
Handwritten          76     70       81
Dense Layout         83     72       86
这样才能真正回答:
模型到底适合什么场景?
48. Docker 部署
OmniDocBench 官方目前提供 Docker 复现环境。
例如:
docker pull ghcr.io/zeng-weijun/omnidocbench-eval:repro-ubuntu2204
当前官方验证环境包含:
Python 3.10.x
TeX Live 2025
ImageMagick 7.1.1-47
Ghostscript 9.55.0
这些依赖尤其与 CDM 等公式评测流程有关。官方仓库当前也建议优先使用 Docker 来获得更稳定的复现环境。
49. 为什么 CDM 需要这么多依赖?
因为它不是简单:
string compare
而是:
LaTeX
 ↓
PDF / Image Rendering
 ↓
Image Comparison
所以需要:
TeX Live
ImageMagick
Ghostscript
例如:
Formula
  ↓
pdflatex
  ↓
PDF
  ↓
ImageMagick
  ↓
PNG
  ↓
CDM
这也是为什么:
直接 pip install 并不一定意味着环境已经完整。
当前官方配置也明确要求 CDM 环境具备可工作的 TeX Live、ImageMagick 和 Ghostscript。
50. Conda 部署
如果不使用 Docker,可以创建:
conda create -n omnidocbench python=3.10 -y
conda activate omnidocbench
然后:
git clone <repo_url>
cd OmniDocBench

pip install -e .
验证:
python -c
"from src.core.pipeline import run_config_file; print('OK')"
官方当前项目要求 Python 3.10 以上且小于 3.12,并且 CDM 需要额外的系统级依赖。
51. 运行 OmniDocBench
核心入口:
python pdf_validation.py
    --config configs/end2end.yaml
也就是说:
代码
+
数据
+
模型结果
最终由:
YAML Config
统一控制。
对于当前官方 end2end 配置,核心就是:
Ground Truth JSON
+
Prediction Markdown Directory
+
Evaluation Config
然后运行:
pdf_validation.py
官方 README 当前也明确采用这种方式运行 End-to-End Evaluation。
52. YAML 配置
一个典型的 end2end 配置结构可以理解为:
end2end_eval:
  metrics:
    text_block:
      metric: [Edit_dist, BLEU, METEOR]

    display_formula:
      metric: [Edit_dist, CDM]

    table:
      metric: [TEDS, Edit_dist]

    reading_order:
      metric: [Edit_dist]

  dataset:
    dataset_name: end2end_dataset

    ground_truth:
      data_path: ./data/OmniDocBench.json

    prediction:
      data_path: ./prediction

    match_method: quick_match
真正使用时应以仓库当前版本提供的配置模板为准。
配置文件的好处是:
代码逻辑
和:
实验参数
彻底分离。
53. Worker 并发
OmniDocBench 当前存在多个并行阶段,例如:
match_workers
cdm_workers
teds_workers
分别可以理解为:
页面匹配
公式渲染
表格 TEDS
对应的并发 Worker(工作进程)数量。
官方当前 README 建议根据可用 CPU / RAM 控制并发,并特别指出 CDM Worker 的内存开销较大。
例如:
dataset:
  match_workers: 2

metrics:
  display_formula:
    cdm_workers: 2

  table:
    teds_workers: 2
如果:
内存 8 GB
那么:
workers = 20
显然不是一个合理配置。
尤其是 CDM 当前约需要较高的单 Worker 内存,因此不能简单按照 CPU 核数无限增加并发。
54. 一个值得注意的工程问题
CDM 属于比较重的计算模块。
实际部署中,如果出现:
CDM = 0
CDM = NaN
不要马上认为:
模型公式识别完全错误。
应该首先排查:
CDM Runtime
Worker
Memory
Rendering
Ghostscript
ImageMagick
TeX Live
等基础设施问题。
尤其在:
CI
Docker
低内存服务器
共享服务器
环境中,这类问题更值得注意。
55. Prediction 目录设计
对于 End-to-End Evaluation,建议:
prediction/
├── page_0001.md
├── page_0002.md
├── page_0003.md
└── ...
文件名应该和页面图像一一对应:
page_0001.jpg
        ↓
page_0001.md
而不是:
prediction/
├── result1.json
├── result2.json
└── random_output.txt
不过这里需要再次强调:
这个 Markdown Prediction 目录是官方 End-to-End Evaluation 的输入格式,不代表 OmniDocBench 的所有任务都必须使用 Markdown。
例如单模块的:
Text Recognition
Formula Recognition
Table Recognition
Layout Detection
Formula Detection
在官方评测代码中还存在结构化 JSON Prediction 路径。
因此更准确的理解是:
End-to-End
    ↓
Markdown Prediction

Single Module
    ↓
根据任务使用对应 JSON / Prediction Schema
56. Benchmark Runner
如果准备长期评测多个模型,建议不要每次手动:
python inference.py
python pdf_validation.py
而是自己写一个 Benchmark Runner(基准测试运行器)。
例如:
class BenchmarkRunner:

    def run_model(self, model):
        predictions = model.infer()
        self.save_predictions(predictions)

    def evaluate(self):
        return run_omnidocbench()

    def report(self, result):
        ...
最终:
BenchmarkRunner
      │
      ├── Prepare Dataset
      │
      ├── Run Model
      │
      ├── Save Prediction
      │
      ├── Run Evaluation
      │
      ├── Aggregate Metrics
      │
      └── Generate Report
对于 End-to-End 模型:
Run Model
    ↓
Markdown Prediction
    ↓
OmniDocBench end2end
对于单模块任务:
Run Model
    ↓
Task-specific Prediction
    ↓
对应 Evaluation
这样整个工程会更加清晰。
57. 推荐的工程目录
如果是一个真正长期维护的项目,我会推荐:
document-benchmark/
│
├── configs/
│   ├── models.yaml
│   ├── benchmark.yaml
│   └── prompts.yaml
│
├── providers/
│   ├── base.py
│   ├── local.py
│   ├── vllm.py
│   └── cloud.py
│
├── adapters/
│   ├── paddleocr.py
│   ├── mineru.py
│   ├── qwen_vl.py
│   └── custom_model.py
│
├── inference/
│   └── runner.py
│
├── cache/
│
├── predictions/
│
├── evaluation/
│   └── omnidocbench.py
│
├── reports/
│
└── main.py
这已经不再是:
一个测试脚本
而是一个真正的:
Document AI Quality Platform(文档人工智能质量平台)
58. API 模型建议增加 Failure Analysis
对于闭源模型,我建议不要只保存:
prediction.md
还应该保存:
{
  "model": "xxx",
  "version": "xxx",
  "latency": 2.31,
  "status": "success",
  "retry_count": 0,
  "input_tokens": 1234,
  "output_tokens": 2345
}
如果失败:
{
  "status": "failed",
  "error_type": "rate_limit"
}
错误类型建议至少区分:
network_error
timeout
rate_limit
authentication_error
server_error
model_failure
invalid_output
infrastructure_failure
这就是 Failure Analysis(失败分析)。
它的价值在于:
区分“模型质量差”和“模型服务失败”。
例如:
Overall = 72
并不一定代表模型本身只能得到 72。
如果其中:
10% pages = timeout
那么真正的模型质量可能完全不同。
59. Latency 也应该记录
对于 Production(生产环境)模型:
Quality
只是一个维度。
还应该记录:
Latency
Cost
Throughput
Error Rate
例如:
| Model | Score | Latency | Cost/Page | Error Rate |
|---|---|---|---|---|
| A | 91 | 2.1s | $0.01 | 0.2% |
| B | 89 | 0.4s | $0.002 | 0.1% |
| C | 94 | 8.3s | $0.04 | 1.3% |
那么:
Score
最高的 C 不一定是最终选择。
因为生产环境真正关心的是:
Quality
+
Cost
+
Latency
+
Reliability
60. Production Benchmark
如果你的目标是生产环境,而不是科研论文,那么建议:
Benchmark Score
+
Production Metrics
一起看。
最终可以得到:
Quality
 ├── Text
 ├── Table
 ├── Formula
 └── Layout

Performance
 ├── Latency
 ├── Throughput
 └── GPU Memory

Reliability
 ├── Error Rate
 ├── Timeout
 └── Retry

Cost
 ├── Cost/Page
 └── Cost/1M Pages
这才是企业真正需要的模型选型依据。
61. CI/CD 中自动跑 Benchmark
如果团队正在开发 OCR 模型,那么可以把 Benchmark 放进 CI/CD(持续集成 / 持续交付)。
例如:
Git Push
   ↓
Train Model
   ↓
Build Docker Image
   ↓
Inference
   ↓
OmniDocBench
   ↓
Quality Gate
Quality Gate(质量门禁)可以设置:
Text Score >= 0.95
Table TEDS >= 0.85
Formula CDM >= 0.90
Overall >= 0.90
如果:
Overall = 0.87
那么:
CI FAILED
这样模型质量就从:
人工观察
变成:
自动化工程约束
62. Quality Regression
更重要的是 Quality Regression(质量回归)。
例如:
v1.0

Text       95
Table      87
Formula    91
升级到:
v1.1

Text       96
Table      81
Formula    93
Overall 可能仍然上涨。
但:
Table
明显下降。
如果只看 Overall:
没问题
如果看 Regression:
发现表格能力退化
这就是 Benchmark 真正的工程价值。
63. A/B Test
A/B Test(对照实验)也可以直接建立在 OmniDocBench 之上。
例如:
Model A
vs
Model B
固定:
Dataset
Prompt
Image
Temperature
Inference Parameters
只改变:
Model
然后:
ΔText
ΔTable
ΔFormula
ΔOverall
最终回答:
新模型到底有没有真正提升?
如果进一步结合页面级结果,还可以回答:
提升发生在哪些页面?
下降发生在哪些页面?
64. 不要把 Benchmark 当成最终真理
这是整篇文章最重要的工程结论之一。
Benchmark 不是:
Truth
而是:
Measurement
也就是:
测量工具。
假设:
OmniDocBench = 90
不代表:
Production Quality = 90
因为你的真实业务可能是:
合同
发票
病历
财报
扫描件
中文手写
而 Benchmark 的数据分布不一定完全匹配。
所以:
Benchmark 是模型能力的参考坐标,不是业务质量的最终答案。
65. 企业应该建立自己的 Business Dataset
因此实际项目建议:
OmniDocBench
+
Business Dataset
例如:
OmniDocBench
     │
     ├── Academic
     ├── Financial
     ├── Newspaper
     ├── Textbook
     └── Handwritten

Business Dataset
     │
     ├── Invoice
     ├── Contract
     ├── Receipt
     ├── Bank Statement
     └── Internal Report
然后:
Research Benchmark
+
Production Benchmark
共同决定模型选型。
这样可以避免:
公开 Benchmark 很高
但:
真实业务效果很差
的问题。
66. 一个完整的企业级评测架构
最终可以构建:
                         Document AI
                             │
                    ┌────────┴────────┐
                    │                 │
              Open Source        Closed Source
                    │                 │
                    ▼                 ▼
                Adapter            Provider
                    │                 │
                    └────────┬────────┘
                             ▼
                     Benchmark Runner
                             │
              ┌──────────────┼──────────────┐
              ▼              ▼              ▼
           Inference       Cache         Metadata
              │              │              │
              └──────────────┼──────────────┘
                             ▼
                       Prediction
                             │
                             ▼
                       OmniDocBench
                             │
              ┌──────────────┼──────────────┐
              ▼              ▼              ▼
            Text           Table          Formula
              │              │              │
              └──────────────┼──────────────┘
                             ▼
                       Quality Matrix
                             │
              ┌──────────────┼──────────────┐
              ▼              ▼              ▼
          Dashboard       CI/CD          Model Selection
其中:
End-to-End
可以进一步展开成:
Prediction
    │
    ├── end2end
    │      ├── JSON Ground Truth
    │      └── Markdown Prediction
    │
    └── md2md
           ├── Markdown Ground Truth
           └── Markdown Prediction
这才是一个完整的 Document AI Evaluation Pipeline(文档人工智能评测流水线)。
67. 常见问题
Q1:OmniDocBench 是 OCR Benchmark 吗?
不完全是。
更准确地说,它是:
面向 Document Parsing 的综合 Benchmark。
OCR 只是其中一个模块。
Q2:为什么我的 OCR 很准,但 Overall 分数不高?
可能是:
Table
Formula
Layout
Reading Order
出现问题。
建议查看:
Attribute-Level Result
Per Page Result
Per Element Result
而不是只看 Overall。
Q3:为什么模型输出 Markdown?
对于 OmniDocBench 的 End-to-End Evaluation,模型需要提供整页 PDF 解析结果,而官方将 Markdown 作为 Prediction 的标准输入形式。
但是需要特别注意:
模型 Prediction
=
Markdown
并不意味着:
Ground Truth
=
Markdown
官方提供两种方式:
end2end
JSON Ground Truth
+
Markdown Prediction
以及:
md2md
Markdown Ground Truth
+
Markdown Prediction
其中官方推荐:
end2end
因为 JSON Ground Truth 保留了更加丰富的 category、attribute、ignore 等信息,可以进行更细粒度的评测。
Q4:为什么不直接比较 Markdown 字符串?
因为:
Markdown Segmentation
存在大量结构上的差异。
例如:
# Title
和:
Title
=====
表达的是类似的标题结构。
又或者:
A
B
C
和:
A+B
C
只是分段方式不同。
所以需要:
Normalization
+
Matching
+
Metric
而不是简单:
pred == gt
这也是为什么 OmniDocBench 中 Matching 是非常重要的模块。
Q5:end2end 和 md2md 有什么区别?
一句话:
end2end
=
JSON Ground Truth
+
Markdown Prediction
而:
md2md
=
Markdown Ground Truth
+
Markdown Prediction
官方推荐:
end2end
因为它能够保留 OmniDocBench JSON 中的:
category
attribute
ignore
等结构化信息。
而:
md2md
更适合已经存在 Markdown-to-Markdown 评测需求的场景。
Q6:OmniDocBench 所有任务都必须输出 Markdown 吗?
不是。
这是一个非常重要的区别。
对于:
End-to-End Evaluation
模型整页 Prediction 使用 Markdown。
但对于:
Text Recognition
Formula Recognition
Table Recognition
Layout Detection
Formula Detection
官方评测代码还提供结构化 JSON Prediction 的方式。
因此不能简单理解为:
OmniDocBench
=
所有模型输出 Markdown
更准确的是:
End-to-End
↓
Markdown Prediction
Single Module
↓
Task-specific Prediction
官方当前的技能说明也明确区分了 End-to-End 的 Markdown 输入与单模块 Recognition / Detection 的 JSON 输入。
Q7:闭源模型可以公平比较吗?
可以,但必须固定:
Input
Prompt
Resolution
Temperature
Model Version
Dataset
并记录:
Cost
Latency
Error
Retry
否则很难做到真正可复现。
68. 最后:真正值得学习的不是 pdf_validation.py
如果你只是想快速跑一次 Benchmark,那么:
python pdf_validation.py
--config configs/end2end.yaml
就够了。
但如果你是一名专业 Python 开发工程师,我更建议把 OmniDocBench 当成一个案例来研究:
如何设计 Benchmark?
如何设计 Dataset?
如何设计 Matching?
如何设计 Metric?
如何处理多模型?
如何统一 Local / API Model?
如何处理 Cache?
如何处理 Retry?
如何保证 Reproducibility?
如何做 Regression Test?
如何做 Quality Gate?
这才是 OmniDocBench 真正值得学习的地方。
69. 总结
整个 OmniDocBench 可以浓缩成一句话:
它不是简单地判断 OCR “识别对不对”,而是试图回答一个更复杂的问题:一个 Document AI 模型,能不能把真实世界中的复杂 PDF,稳定、准确地还原成结构化文档?
从工程角度,可以把整个体系记成:
PDF
│
▼
Document AI
│
▼
Prediction
│
▼
Matching
│
┌─────────┼─────────┐
▼ ▼ ▼
Text Table Formula
│ │ │
▼ ▼ ▼
EditDist TEDS CDM
│ │ │
└─────────┼─────────┘
▼
Evaluation
│
▼
Quality Matrix
│
▼
Model Selection
而 End-to-End 本身还可以进一步拆成:
End-to-End
│
┌────────┴────────┐
▼ ▼
end2end md2md
│ │
▼ ▼
JSON Ground Truth Markdown Ground Truth
│ │
└────────┬────────┘
│
▼
Markdown Prediction
│
▼
Matching
│
▼
Metric
其中:
官方更推荐
end2end,因为它不是简单地把两个 Markdown 文件进行比较,而是利用 OmniDocBench JSON 中丰富的 category、attribute、ignore 等信息进行更完整的端到端评测。
而在真实项目中,再进一步:
OmniDocBench
+
Business Dataset
+
Production Metrics
+
Regression Test
+
CI/CD
最终形成完整的:
Document AI Evaluation Pipeline(文档人工智能评测流水线)
如果把它真正落地,那么你就不再是在“跑一个 OCR Benchmark”,而是在构建一套可以持续回答下面这些问题的工程系统:
哪个模型最好?
为什么最好?
在哪些文档上最好?
哪个模块退化了?
新版本有没有回归?
API 模型是否值得它的成本?
本地模型是否值得部署?
模型升级后质量有没有提升?
这也是 OmniDocBench 对专业开发工程师来说最有价值的地方。
官方资料
OmniDocBench 官方仓库:
GitHub - opendatalab/OmniDocBench
论文:
OmniDocBench: Benchmarking Diverse PDF Document Parsing with Comprehensive Annotations
官方仓库当前 README 已经包含 Docker、Conda、End-to-End、end2end / md2md、各类 Metric、模型推理脚本以及 OpenAI-compatible endpoint 等使用说明。