借助 Profile 定位大模型训练性能瓶颈
同一套模型和相同数量的 GPU,在不同训练配置下可能呈现截然不同的吞吐表现。面对利用率波动、扩容收益偏低或多卡同步等待,仅凭经验调整参数往往难以触及根因。要准确区分计算、通信与数据加载瓶颈,需要从框架和系统两个层面采集时间线,再用可量化的证据指导优化。
摘要
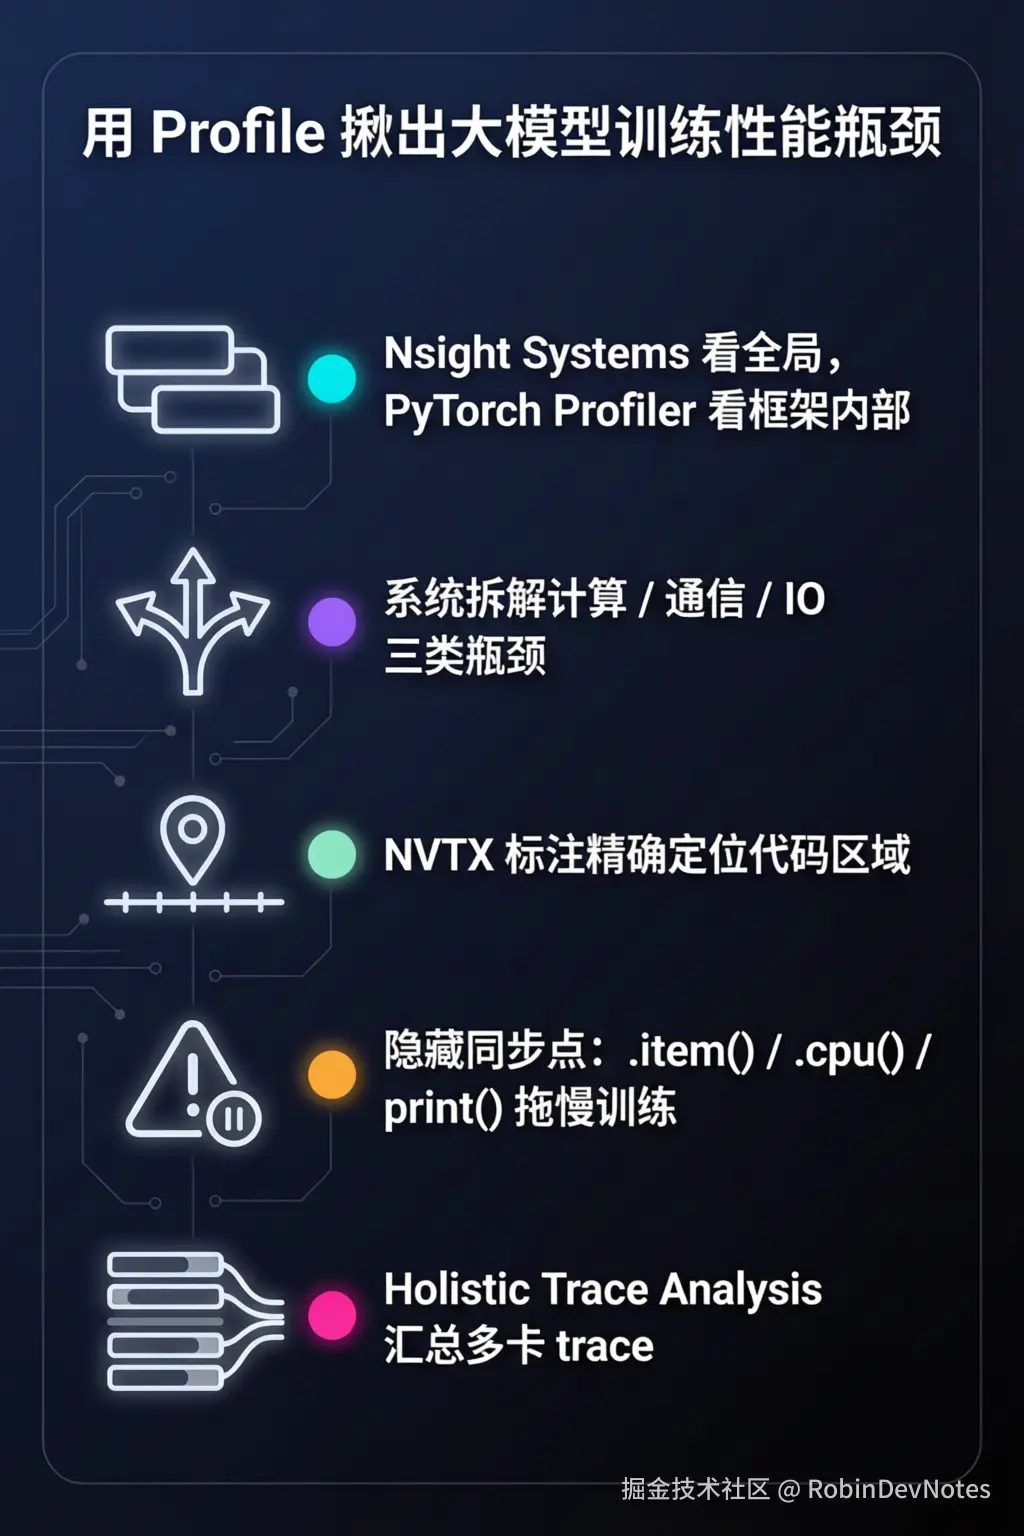
大模型训练"跑起来"和"跑得快"完全是两回事——同样的模型、同样的卡数,GPU 利用率可能相差一倍以上,原因往往藏在计算、通信、IO 三个环节里,肉眼很难判断到底卡在哪一步。Nsight Systems 和 PyTorch Profiler 是目前工程实践中最常用的一对性能分析工具,前者看系统全局、后者看框架内部,配合起来能把"训练慢"这种模糊感受,拆解成一个个可以定位、可以量化的具体问题。
背景与问题
多卡分布式训练涉及数据加载、前向反向计算、梯度通信、优化器更新等多个环节,任何一个环节出现停顿都会拖累整体吞吐。常见的表现是:GPU 利用率曲线忽高忽低、多机训练的加速比明显低于理论值、扩容后吞吐提升不明显。这些现象背后,通常对应三类瓶颈:
- 计算瓶颈:算子本身效率低,或者存在不必要的 CPU-GPU 同步打断了异步执行。
- 通信瓶颈:梯度同步、张量并行的 all-reduce/all-gather 没有被计算充分掩盖,GPU 在等通信。
- IO 瓶颈:数据加载/预处理跟不上训练消耗速度,GPU 在等数据。
不做系统性的 profile,单凭经验猜测很容易调错方向——比如把时间花在优化算子上,结果真正的问题其实是 DataLoader 的 num_workers 设置不合理。
核心思路与优势
分层分析是这套方法论的核心:先用宏观工具找到"哪个阶段慢",再用微观工具搞清楚"为什么慢"。
- PyTorch Profiler 基于 CUPTI,能同时采集 CPU 算子调度和 CUDA kernel 执行信息,是从框架层面切入的第一站。它能直接暴露 dataloader 停顿、host-to-device 拷贝耗时、autograd 各阶段耗时;分布式训练时,NCCL 通信 kernel 和计算 kernel 会被记录在同一条时间线上,两者是否重叠一眼可见。
- Nsight Systems 是系统级工具,能看到 CPU、GPU、操作系统调度之间的完整交互时间线,尤其擅长发现 PyTorch Profiler 覆盖不到的系统层问题(比如 CPU 调度延迟、跨进程通信开销)。
- 两者结合再加上 Meta 开源的 Holistic Trace Analysis(HTA),可以把单机分析扩展到多机多卡场景,按 rank 拆解计算/通信/空闲时间占比,快速定位负载不均衡或掉队节点(straggler)。
这套组合拳的优势在于:不依赖猜测,每一个优化动作都能用 profile 数据验证效果,优化前后的对比也有据可查。
面向人群
- 正在做大模型预训练或微调、需要提升 GPU 集群利用率的算法与基础设施工程师。
- 负责分布式训练性能调优、经常被问"为什么训练这么慢"却说不清具体原因的 MLOps/性能工程师。
- 希望系统掌握 Nsight Systems + PyTorch Profiler 联合分析方法论的技术读者。
实践步骤
第一步:用 PyTorch Profiler 做框架层扫描
在训练循环中包一层 torch.profiler.profile,用 schedule 控制采集窗口,避免全程采集带来过大开销:
import torch
from torch.profiler import profile, ProfilerActivity, schedule, tensorboard_trace_handler

with profile(
    activities=[ProfilerActivity.CPU, ProfilerActivity.CUDA],
    schedule=schedule(wait=1, warmup=2, active=5),
    on_trace_ready=tensorboard_trace_handler("./traces"),
    record_shapes=True,
    profile_memory=True,
    with_stack=True,
) as prof:
    for step, batch in enumerate(dataloader):
        train_step(batch)
        prof.step()
采集完成后有两种查看方式:一是把 ./traces 目录下生成的 trace 文件拖进 Perfetto UI 看时间线(Chrome 自带的 tracing 页面也能打开,但大模型的 trace 体积一大就会明显卡顿);二是在代码里调用 prof.key_averages().table(sort_by="cuda_time_total"),在终端打印耗时最长的算子排行榜,适合快速定位。
需要提醒一句:早年教程里常见的 TensorBoard Profiler 插件(torch-tb-profiler)自 2023 年之后就没有再更新,它的 Distributed 视图不建议再作为主力手段,分布式场景的分析能力已经由第四步要讲的 HTA 接手。但 tensorboard_trace_handler 本身仍是官方 API,它按 rank 落盘的这批 trace 文件,正好就是 HTA 的输入。
重点关注两类信号:
- Trace View 里的周期性空白——如果 GPU 时间线每隔固定步数就出现空档,往往是 DataLoader 供数跟不上,典型的 IO 瓶颈信号。
- 计算 kernel 与 NCCL kernel 的重叠情况——如果 NCCL kernel 和计算 kernel 在时间线上是先后顺序执行而不是重叠,说明通信没有被计算掩盖,是明显的通信瓶颈;如果某个 rank 的计算时间和重叠时间明显长于其他 rank,则说明存在负载不均衡或者掉队节点,这类跨 rank 的横向对比交给第四步的 HTA 做最省事。
第二步:用 Nsight Systems 做系统层深挖
PyTorch Profiler 定位到大致方向后,用 Nsight Systems 采集更完整的系统级时间线:
nsys profile --trace=cuda,nvtx,osrt,cudnn,cublas
    --output=train_profile.nsys-rep
    python train.py
在训练代码的关键区域插入 NVTX 标注,方便在 Nsight 的时间线上直接对应到代码位置:
import torch.cuda.nvtx as nvtx

for step, batch in enumerate(dataloader):
    with nvtx.range("data_loading"):
        inputs = prepare_batch(batch)
    with nvtx.range("forward"):
        loss = model(inputs)
    with nvtx.range("backward"):
        loss.backward()
    with nvtx.range("optimizer_step"):
        optimizer.step()
        optimizer.zero_grad()
采集完成生成的 .nsys-rep 文件建议传回本地,用 Nsight Systems 客户端打开分析。重点看时间线里 "CUDA HW" 这一行汇总的 GPU 利用率曲线:周期性出现的空白区间,就是 GPU 在等数据或等通信的直接证据,结合 NVTX 标注可以马上定位到是哪个代码区域造成的。
第三步:排查隐藏的同步点和 IO 瓶颈
在两轮 profile 之后,通常能收敛到几类具体问题:
- 隐藏的同步点:训练循环里出现
tensor.item()、print(tensor)、.cpu()之类的调用,会触发 GPU-CPU 同步,打断本该异步执行的流水线,是 profile 中经常能揪出来的"隐藏杀手"。 - DataLoader 配置不当:
num_workers默认是 0,也就是数据完全在主进程里串行加载;pin_memory默认关闭,拷贝到显存时会多走一次额外的中转。这两项不动,数据预取很容易跟不上训练消耗速度。经验起点是把num_workers设为物理核心数的一半(比如 4-8),同时打开pin_memory=True。至于prefetch_factor,num_workers > 0时它默认就是 2,不需要专门去写,只有在确认 worker 产出不稳定、需要更深预取缓冲时才往上调,代价是内存占用相应增加。 - 通信未被掩盖:如果确认是通信瓶颈,需要检查梯度同步的触发时机是否过早、通信算子是否和计算算子调度到了同一个 CUDA stream 上,导致无法并行。
第四步:用 Holistic Trace Analysis 做多卡汇总分析
单机分析定位到问题后,多卡/多机场景建议用 Holistic Trace Analysis 做进一步汇总:在 Jupyter Notebook 中从 hta.trace_analysis 导入 TraceAnalysis,把 trace_dir 指向存放各 rank trace 文件的目录(也就是第一步落盘的那个目录),就能得到按 rank 拆解的计算/通信/内存/空闲时间占比,以及跨 rank 的 kernel 耗时分布,一眼看出是不是有节点掉队。它还支持 Trace Diff,能直接对比优化前后两次 trace 的差异,把优化效果量化下来。
应用领域
这套 Nsight Systems + PyTorch Profiler + HTA 的组合分析方法,广泛应用在大模型预训练集群的日常性能巡检、新硬件/新集群上线前的基准测试、分布式训练框架(如 FSDP、DeepSpeed、Megatron 系列并行策略)的调优验证等场景。对于任何需要把"训练慢"这种模糊问题转化为可量化、可复现优化过程的团队来说,建立起这套 profile-分析-优化-再验证的闭环,是大模型训练工程化绕不开的基本功。