LangChain 模型调用指南:如何选择 invoke、stream 与 batch
在 LangChain 应用中,调用模型并不只是发送请求并等待答案。结果是一次性返回、边生成边输出,还是并发处理一批输入,会直接影响交互体验、执行效率和后续代码结构。理解 invoke、stream 与 batch 的差异,是设计模型调用流程时首先要解决的问题。
调模型这件事,看起来就一句话:
把请求发过去,把结果拿回来。
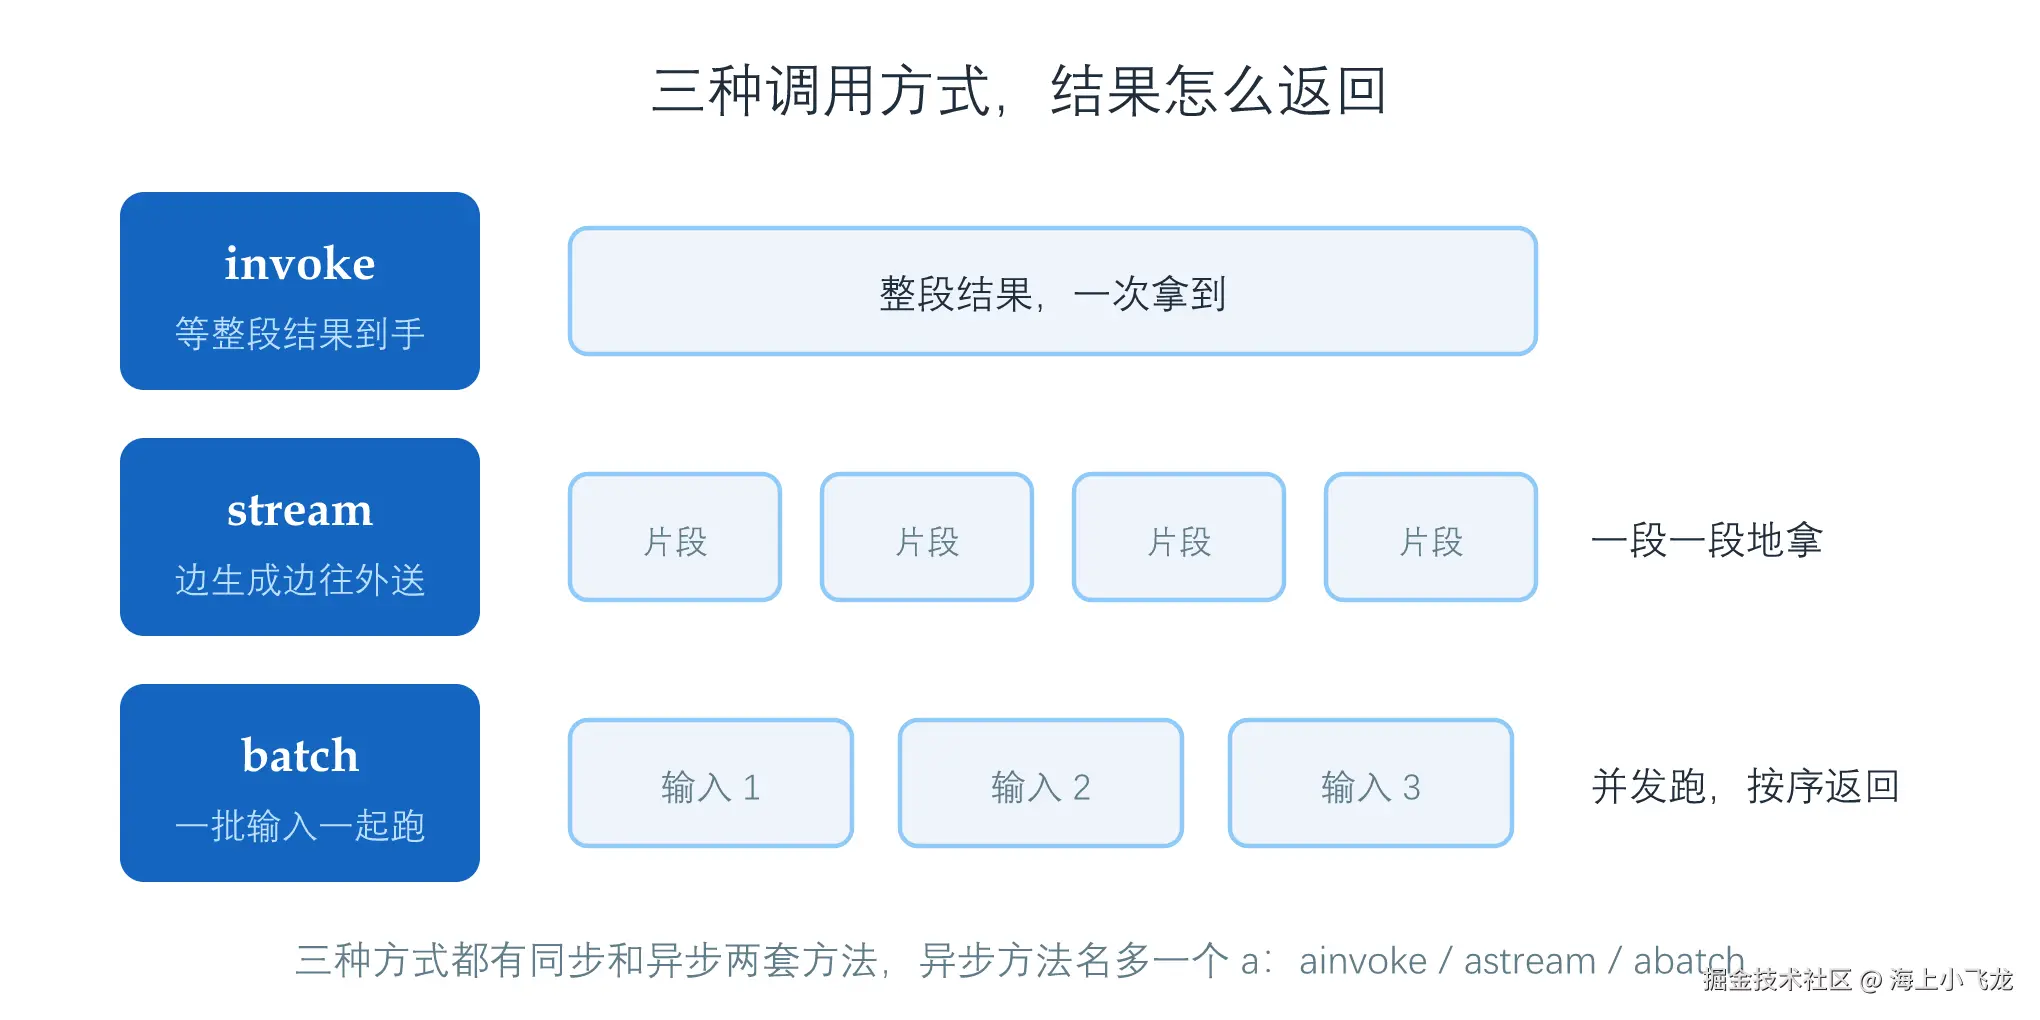
但结果怎么返回,有三种常见的调用方式。
一种是等它整个生成完再给你,一种是边生成边往外送,还有一种是一次发一批。
LangChain 把它们做成了三个方法:invoke、stream、batch。
| 调用方式 | 结果怎么返回 | 典型场景 |
|---|---|---|
invoke | 等模型整个生成完,一次拿到完整结果 | 拿到结果才能往下走的任务 |
stream | 边生成边返回,一段一段地拿 | 对话、长文生成这类要有实时感的场景 |
batch | 整批跑完后,按输入顺序返回 | 离线的批量任务 |
这三种调用方式,各自还有一个异步版本。
异步版的方法名只多一个 a:
ainvoke、astream、abatch。
用法上跟同步版有差别:
结果得靠 await 拿,astream 那边还要配合 async for 来循环。
下面一个一个说。
等结果全出来再拿走
invoke 是最基础的一个,也最容易理解。
发一次请求,模型把整段结果生成完,再一次性返回。
这是同步调用,整段结果没回来之前,调用方一直等着,中途拿不到任何片段。
打个比方,像在面馆点单:
只能干等着,厨房把整碗做好了才给你端上来。
invoke 适合这几类任务:
- 短文本分类、意图识别,只要一个结论
- 对延迟不敏感的后台任务
- 下一步必须拿到完整结果才能继续的逻辑,比如先拿到模型给出的参数,再拿这个参数去查数据库
最后这条是硬要求,要的是完整结果,跟用哪个方法没关系。
stream 也能接这种活,只是你得自己把片段拼成完整的一条,才能交给下一步。
result = model.invoke("把这句话归类:是投诉、咨询,还是表扬?") # 整段结果拿到手,再决定下一步
边生成边往外送
stream 不等结果全出来。
模型生成一点,往外送一点,返回的是一串片段,拼起来才是完整的一条消息。
同步调用时,stream 给的是个迭代器,每循环一次拿到一个片段,可以立刻显示给用户。
像对面一边说,你一边听。
好处有两个:
生成到哪儿,用户就能看到哪儿,不用盯着空屏幕干等。
模型要是跑偏了,不用等整段生成完才发现。
典型场景有这么几类:
- 对话类应用,做出打字机效果
- 长文本或代码生成,用户可以边看边判断要不要继续
- 任何需要实时反馈的交互界面
代价是拿到的只是片段,拼接、累积这些活都得你自己来。
要是下一步非要等到完整结果不可,那就直接用 invoke 更省事。
for chunk in model.stream("讲讲 LangChain 的模型调用方式"):  # 一段一段地显示,不用等整段
    print(chunk.content, end="", flush=True)
一次发一批
batch 处理的是很多条彼此独立的输入。
一次把一批输入交出去,并发跑完,最后统一收结果。
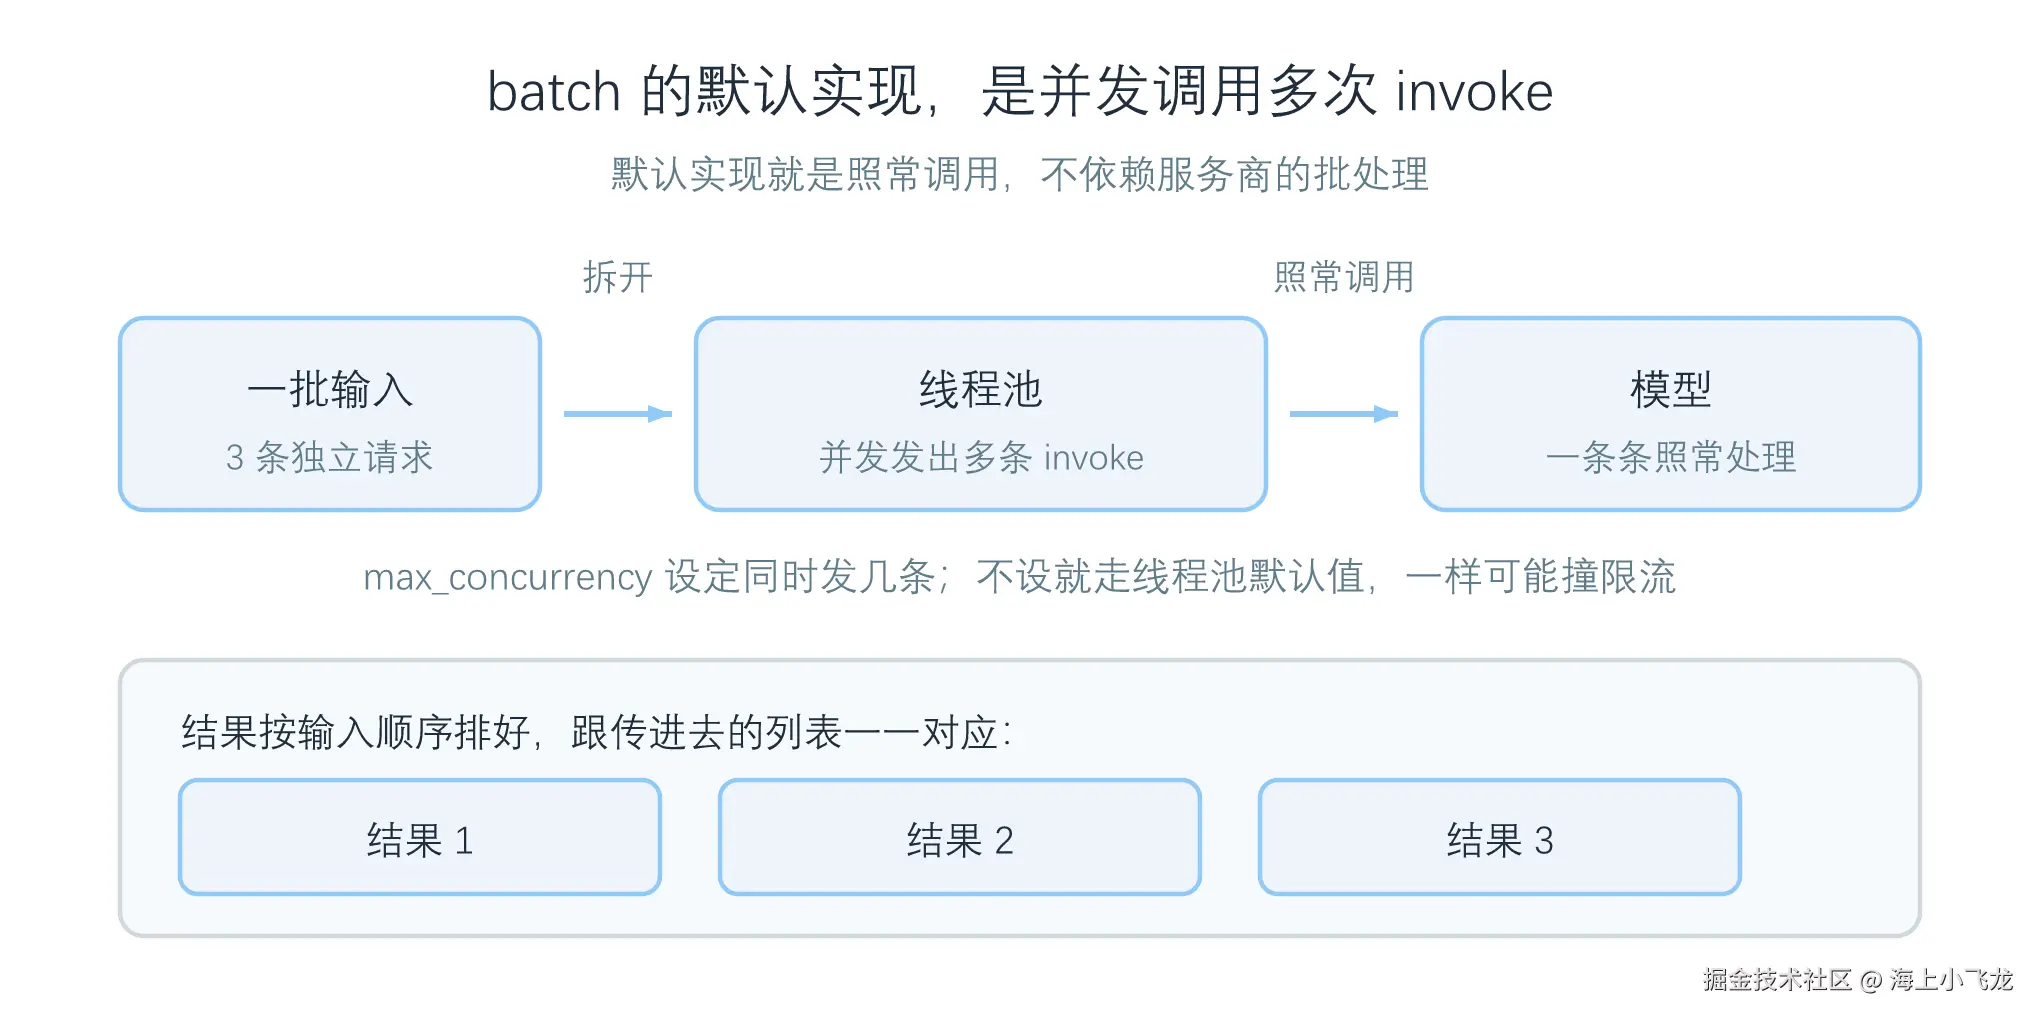
batch 的默认实现,是并发调用多次 invoke。
它没向模型要什么新能力,只是用线程池把一条条 invoke 一起跑起来。
个别组件要自己实现批处理,那就不走这条默认路子。
原来你写个循环一条一条调,现在交给 batch 并发跑,整体耗时能压下来。
像把一沓单子一次递过去,同时开几个窗口办。
开几个窗口是可以设定的,用 max_concurrency 参数。
不设的话,并发度走线程池的默认值。
输入一多,短时间内同时发出的请求就多,一旦触发服务商的限流,或者超出配额,这些请求就可能失败。
batch 默认会把整批跑完再返回,结果按输入顺序排好,跟传进去的列表一一对应。
要想按完成顺序收结果:
可以用 batch_as_completed,哪条先跑完,哪条的结果就先返回,还带着对应的输入序号,代价是顺序不再保证。
batch 的适用场景主要是两类:
- 离线的批量任务,比如大批量文本分类、数据标注
- 一批彼此独立的请求,要尽快跑完
日常写业务代码,batch 通常用得比 invoke 和 stream 少。
inputs = ["这句话是投诉", "这句话是咨询", "这句话是表扬"]
results = model.batch(inputs, config={"max_concurrency": 5})  # 结果按输入顺序返回
怎么挑
用哪个方法,看结果怎么用就知道了。
页面上的对话、要有实时感的生成,走 stream。
离线的批量活,走 batch。
剩下的场景用 invoke 就够了,它也最省心。
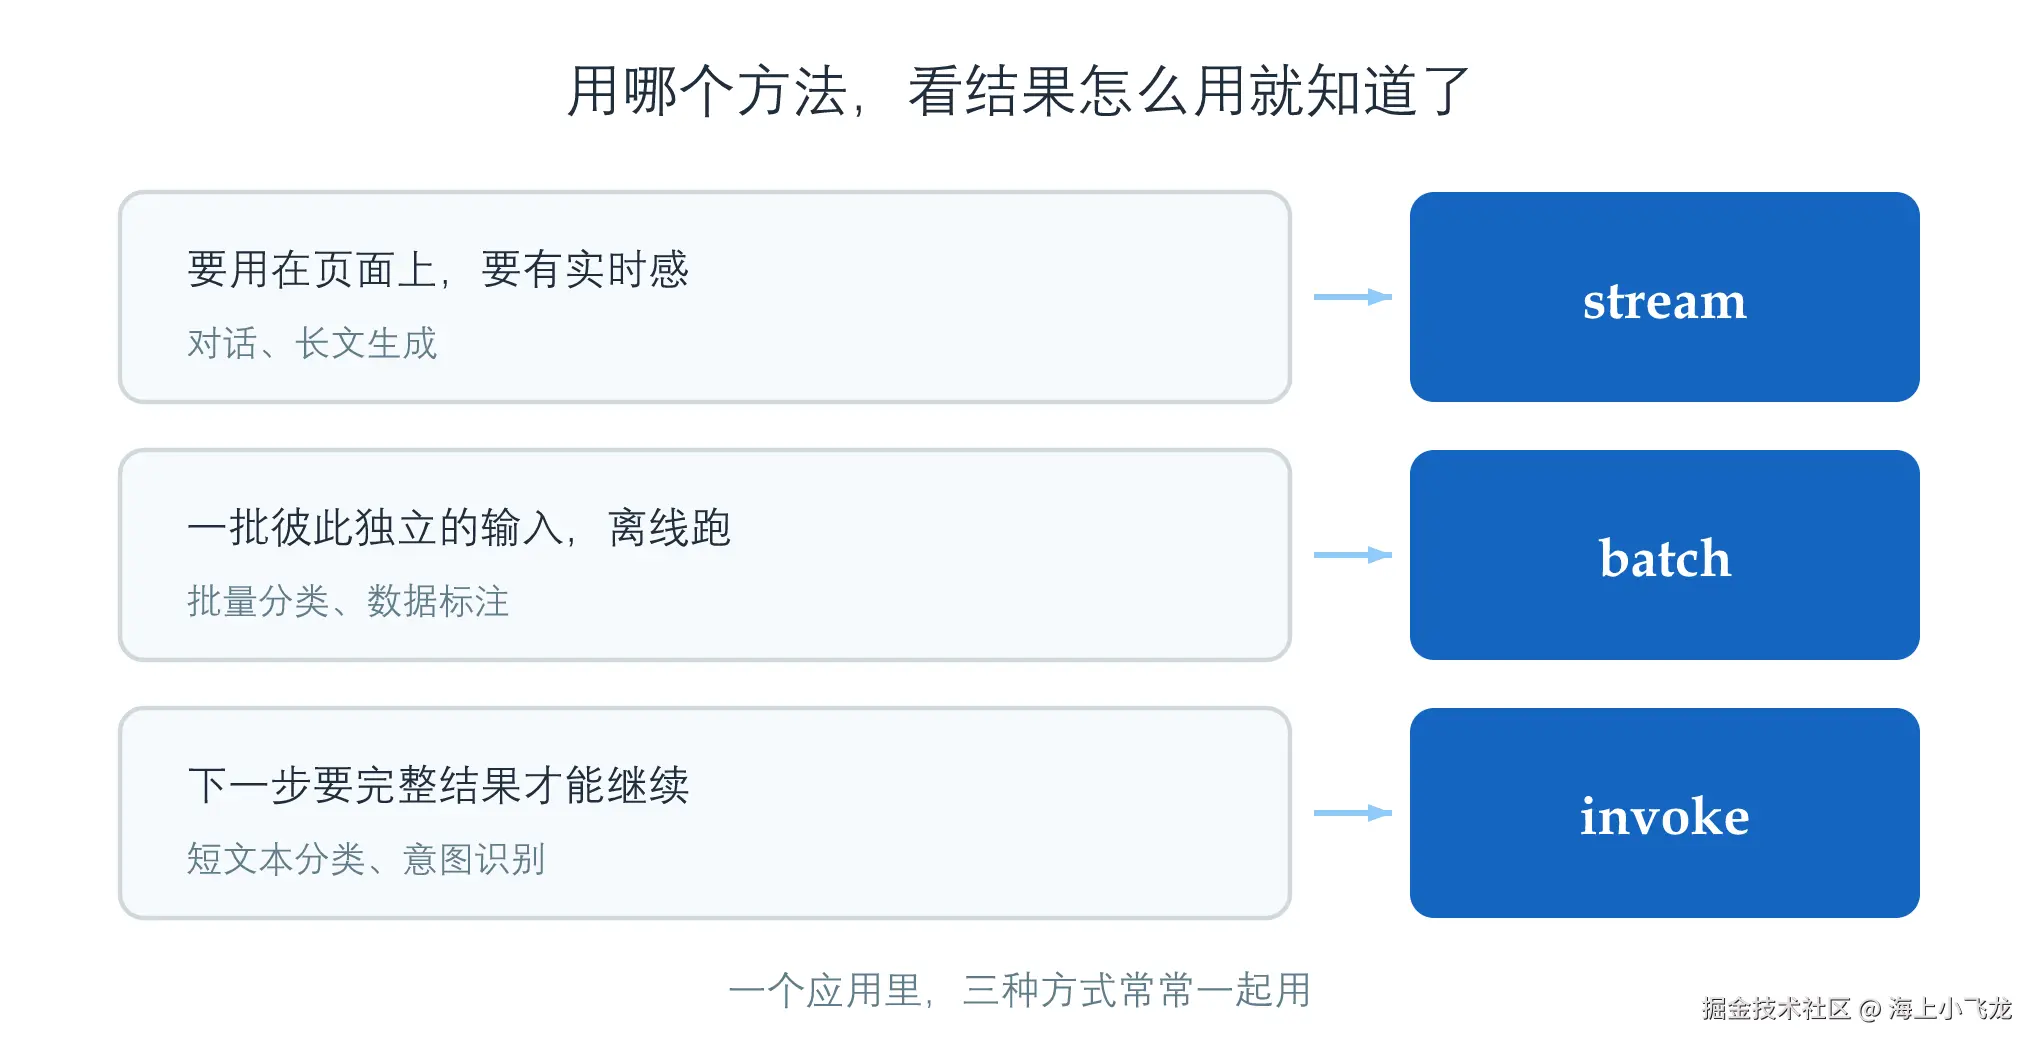
一个应用里,三种方式常常一起用:
页面上的对话在流式返回,后台的批量任务在并发跑,中间那些必须拿到完整结果才继续的步骤,老老实实等 invoke 返回。