企业级智能问答系统搭建实战:向量库架构与取舍
完成文档切分后,智能问答系统首先要解决的并不是如何保存数据,而是如何保证检索路径稳定且语义一致。面对 Milvus 与 Chroma 双后端方案,简单增加兜底并不一定更可靠。本章将从后端取舍入手,进一步拆解支持稠密与稀疏检索的 Schema 设计、Embedding 维度管理及部署配置约束。
Ch05 · 向量库:从双后端到单一后端
覆盖提交:
b2a5496(029) ·96af569(040) ·06c771a(042) 代码位置:GitHub 搜索lingluo1hao / enterprise-ai→advanced_rag_agent.py(VectorStoreManager建集合/建索引/维度自愈 ·_make_embedder向量化入口)·requirements.txt(pymilvus版本锁定)·.env.example(部署契约),上面每个提交号都能逐条对照改动 难度:★★★☆☆ 阶段:Day 7–12 关键词:Embedding / Milvus / 混合检索 Schema / 版本锁定 / 删掉兜底的勇气
本章导读
上一章结束时,你手上有了一批切好的分片——真实数据是 Jimi 设备手册 27 个章节 → 25 个父块 + 309 个子块 = 334 个分片。
分片准备好了,该存哪儿? 这就是本章要解决的问题。
但这一章真正想让你带走的,不是"Milvus 怎么用",而是一个反直觉的决策:
项目曾经是"Milvus 主 + ChromaDB 兜底",后来把兜底也删了。
大多数人觉得"保留兜底更安全"——主方案挂了还有备胎,服务不中断,多稳。本项目的结论相反:
保留兜底看似更安全,实则更危险——因为它制造了两条路径,而两条路径的行为不一致。
这不是向量库选型的孤立问题,它是所有"降级设计"的通用陷阱。你在 Ch06 会看到同一个判据用在 BM25 召回失败上,在 Ch13 会看到它用在模型主备切换上——判据只有一条:降级后的行为,和正常路径大致等价吗?
还有一条伏笔先埋在这:本章建的 Schema 里有一个 BM25 稀疏字段,它此刻躺在那里还没被真正用起来。Ch06 才会把它和 dense 向量融合起来——到那时你会明白,为什么本章要在建集合这个阶段就把字段留好。
还记得工程篇一路强调的那条原则「静默降级比崩溃危险一百倍」吗?(它是全书五条原则的第 2 条,见 README 与 Ch25 总结;ch03 在配置层给过它的一个切面——缺配置宁可当场报错,不要静默跑偏。)
本章是这条原则的第一次正面应用:我们不是给降级补日志,而是判断它不配存在,然后删掉它。这个"删"的勇气,比"加"的技巧更难,也更值钱。
本集学习目标
学完这一章,回到这张表逐一自查——四条,一条都不能少:
| # | 目标 | 达标标准 |
|---|---|---|
| 1 | 搞懂向量库的本质与选型判据 | 能说清"库只是仓库、embedding 才是语义来源";能判断什么阶段该用什么库 |
| 2 | 会用「降级是否等价」判断兜底的去留 | 拿到一个兜底方案,能当场判断该留、该补、还是该删 |
| 3 | 会设计支持混合检索的 Schema | 懂 BM25 Function 怎么生成 sparse、中文分词器为什么必配、维度漂移怎么自愈 |
| 4 | 会锁依赖版本、把配置当契约 | 知道 pymilvus 为什么锁 2.5.x;.env.example 为什么必须和功能同提交 |
目标 1 是认知地基——不懂"库只是索引、语义来自 embedding",后面调什么都像在调玄学;目标 2 是本章最值钱的部分,它是一个能带走一辈子的判断工具,跟向量库没关系;目标 3 是你回去能直接抄走的实现,Ch06 的混合检索就架在这套 Schema 上;目标 4 是最容易被忽略、却最常在凌晨三点炸掉的一类问题。带着这四个目标往下读,读完回来打钩。
? 理论基石:向量库 = 最近邻索引,Embedding 是语义坐标(P0-03)
动手前先建立一件事:向量库(Milvus/Chroma)本质是一个高维向量的最近邻索引——它唯一的工作,是把「query 向量」和「库里所有 doc 向量」比距离,返回最近的 K 个(P0-03 §7)。而「向量」本身,是 embedding 模型把文本压成的语义坐标(P0-03 §1),同一段中文经 _embed 输出定长向量(advanced_rag_agent.py:404)。
这条区分是本章的总开关:
- 语义从哪来 → embedding 模型(本项目是 bge-m3,1024 维)
- 怎么找最近邻 → 向量库(Milvus)
- 换库换掉的是什么 → 只换"存向量 + 算距离的引擎",换不掉"语义从哪来"
# advanced_rag_agent.py:548
def _make_embedder():
    """统一的 Embedding 创建入口。"""
一句话:向量库是 embedding 的仓库,不是 embedding 的来源——换仓库不会让货物变好,只会让搬运方式变。
这条认知直接解释了本章为什么敢删兜底:两条路径若用同一套 embedding + 同一套距离语义(P0-03 §3/4),行为才一致;否则"兜底"返回的是语义口径不同的结果,比没有更糟。统一度量语义,是删兜底的底气。
先记住这条主线,现在开始动手——第一件事,看清楚原来那个 ChromaDB 到底哪里不够用。
第一部分 · 全景与选型:先把「为什么换掉 ChromaDB」钉死
这一部分拿下目标 1。 很多人选型直接问"哪个库快",方向又错了——和分块一样,第一位的问题是"你的能力需求是什么",第二位才是性能。这一部分先把 ChromaDB 的三个硬伤摆出来,再给一条真实的迁移时间线。
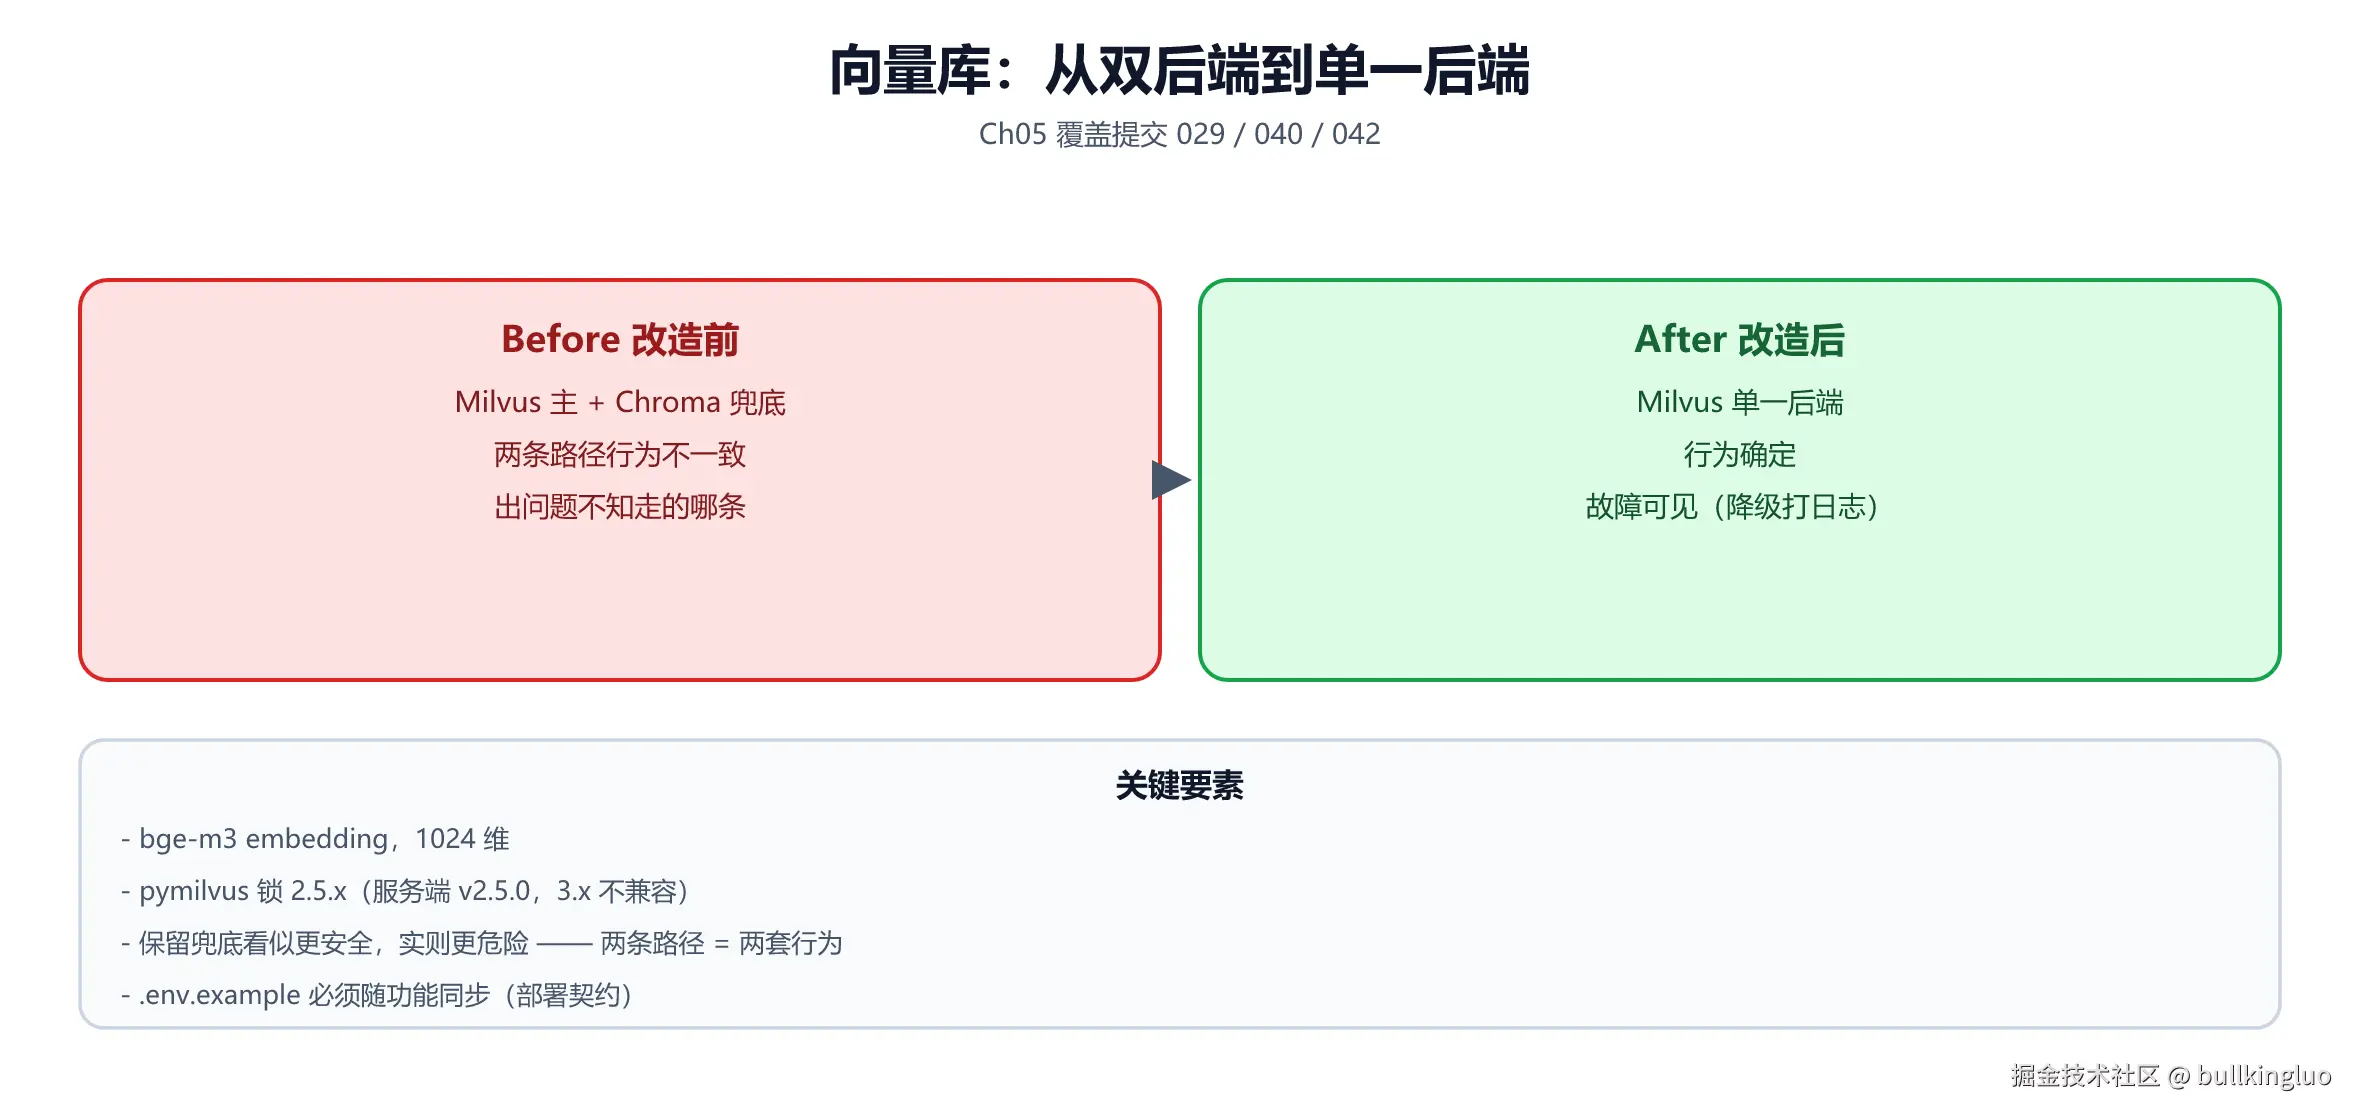
图 1 从"双后端"到"单一后端"。删除兜底后代码净减少 38 行——少即是多。
1.1 ChromaDB 的三个问题
| 问题 | 具体表现 |
|---|---|
| 无法水平扩展 | 数据量一大就卡,只能单机 |
| 混合检索支持弱 | BM25 稀疏向量没有原生支持(见 Ch06) |
| 多租户只能靠多 collection | 运维灾难(见 Ch08) |
注意这三个问题不是"ChromaDB 做得烂",而是它的定位就不是这些场景:
ChromaDB 本身是好东西——嵌入式、零部署、五分钟跑起来,非常适合原型验证。它的定位就是"原型",不是"生产"。
选型的正确问法不是"哪个更好",而是"我的需求落在哪个库的射程内"。
1.2 迁移时间线
| 提交 | 时点 | 动作 |
|---|---|---|
b2a5496(029) | Day 7 | 默认后端改为 Milvus,Chroma 作为回退 |
96af569(040) | Day 12 | 移除 Chroma 兜底,单一后端 |
中间隔了 5 天——这 5 天里"双后端"一直在运行,也一直在制造困惑。
这 5 天值得单独说一句:它不是决策犹豫,是真实运行后的验证期。先让它跑着、观察两条路径是否真的能共存,然后基于证据删掉——这比"第一天就拍脑袋删"要硬得多。结论可以激进,过程必须实证。
第一部分小结 · 对照自查
- ✓ 一条认知——库只是最近邻索引,语义来自 embedding 模型,换库换不掉语义口径
- ✓ 三个硬伤——ChromaDB 在水平扩展、混合检索、多租户三处触顶,这是它的定位决定的,不是缺陷
- ✓ 一条时间线——Day 7 双后端并行 → 观察 5 天 → Day 12 删兜底,净减 38 行
到这里,目标 1 完成——你现在知道选型该问什么、ChromaDB 为什么不够。接下来是本章最值钱的部分:为什么"留个备胎"反而是错的。
第二部分 · ★ 核心决策:为什么"保留兜底"更危险
这一部分拿下目标 2。 路线四步:兜底的诱惑 → 实际问题 → 本项目的结论 → 这个洞察怎么通用化。其中第 4 步是重点——同样的判据,你明天就能用在自己的任何一个降级设计上。
2.1 兜底的诱惑
try:
    store = MilvusStore(...)
except Exception:
    print("Milvus 不可用,回退 ChromaDB")
    store = ChromaStore(...)
看起来很稳妥:主方案挂了还有备胎,服务不中断。
这句话本身没错——错的是它没问"备胎和主胎是不是同一辆车"。
2.2 实际问题
问题 1:两条路径的行为不一致
| 行为 | Milvus | ChromaDB |
|---|---|---|
| 混合检索 | ✅ dense + BM25 | ❌ 仅 dense |
| 多租户 | ✅ partition_key + filter | ❌ 多 collection |
| 权限下推 | ✅ expr 过滤 | ⚠️ 能力有限 |
| 召回数量/排序 | 一套逻辑 | 另一套逻辑 |
后果:同一个问题,两条路径召回的集合根本不是同一批文档——Milvus 能靠 BM25 捞到精确关键词命中的那几条,Chroma 只有 dense,关键词那几条直接不见。
⚠️ 注意口径:这里不给你一个"Milvus 召回 5 条 / Chroma 召回 2 条"的具体数字。真实数字随 query 变化,而且本项目删掉兜底之后已经无法复现 Chroma 侧的实验(没有那条路径了)。能负责任地讲的结论只有一条:两条路径的召回集合不同,且差异由"有没有 BM25"这一条决定。 凡是给不出复现步骤的数字,都不该写进技术文档。
问题 2:降级是静默的
except Exception:
    # 只 print 一行,没人看日志
    print("Milvus 不可用,回退 ChromaDB")
服务"正常运行",但质量悄悄下降。用户抱怨"最近答得不准",你查不出来——因为系统没报错。
问题 3:测试覆盖不到
测试环境 Milvus 一直可用,Chroma 分支从未被执行过。等生产环境真的降级时,你可能发现那条路径早就坏了(比如 API 变了)。
这三个问题叠起来是个死结:行为不一致让你无法预期结果,静默让你收不到信号,测试覆盖不到让你连那条路径是死是活都不知道。你以为买的是保鲜,其实买的是盲区。
2.3 本项目的结论
两条路径 = 两套行为 = 排查噩梦。
结论:兜底要么做好,要么删掉。
"做好兜底"意味着:
- 两条路径功能等价(要写两遍实现,成本翻倍)
- 降级时明确告警(不只是 print)
- 定期演练降级路径(否则等于没有)
本项目的选择:功能无法等价(混合检索是核心能力),所以删掉。
删掉之后的代价是什么?Milvus 挂了,服务就挂。 这个代价是主动接受的:
# AGENTS.md 记录的项目事实
# Milvus :19530(**强制** —— 不可达即启动失败)

# advanced_rag_agent.py:618 —— 「删掉」的代码形态就是「没有 except 回退分支」
try:
    self.client = MilvusClient(uri=uri)
    self._ensure_collection()
except Exception as e:
    raise RuntimeError(
        f"Milvus 初始化失败,系统无法启动(本项目仅支持 Milvus,无 Chroma 兜底): {e}"
    ) from e
注意 except 里没有 store = ChromaStore(...)——这是整章最关键的 6 行代码:它把"降级"从一个运行时分支,变成了一个启动期错误。
快速失败不是摆烂,是把故障从"隐性的质量退化"转成"显性的服务中断"——后者会被立刻发现、立刻修,前者可能烂三个月没人知道。可用性不等于"永远返回结果",而是"要么返回正确的结果,要么明确报错"。
2.4 这个洞察的通用化
| 场景 | 双路径 | 建议 |
|---|---|---|
| 向量库主备 | 行为不一致 | 删备(本项目) |
| 模型主备(DeepSeek / qwen) | 行为大致等价 | ✅ 保留(见 Ch13) |
| 缓存 Redis 挂了 | 行为等价(只是慢) | ✅ 保留降级 |
| BM25 召回失败 | 部分能力降级 | ⚠️ 保留但必须打日志(见 Ch06) |
判断标准:降级后的行为是否与正常路径"大致等价"?
- 等价 → 可以保留(但要可观测)
- 不等价 → 要么补齐,要么删掉
这张表请单独存下来。同一个判据,四个场景,四种结论——这才是"通用"的意思:不是背结论,是会问那个问题。
第二部分小结 · 对照自查
- ✓ 三个问题——行为不一致 / 降级静默 / 测试覆盖不到,叠起来是"你以为买保鲜,实际买盲区"
- ✓ 一个结论——兜底要么做好(功能等价 + 明确告警 + 定期演练),要么删掉
- ✓ 一条判据——降级后行为是否等价? 等价可留,不等价就删或补
- ✓ 一个认知——快速失败是把隐性退化转成显性中断,可用性 ≠ 永远返回结果
到这里,目标 2 完成——你现在手上有一个能带走一辈子的判断工具。接下来落地:Schema 怎么设计,才能让混合检索有地方放。
第三部分 · Schema 与 Embedding:混合检索的字段从哪来
这一部分拿下目标 3。 路线是:为什么 Schema 重要 → 本项目 Schema(含 BM25 函数)→ 索引 → 维度漂移自愈 → embedding 从哪来。其中「中文分词器」看着是个参数,配错了会让整个稀疏检索静默失效——这是本章最隐蔽的坑。
3.1 为什么 Schema 设计重要
Milvus 的 collection 类似数据库表,但多了向量字段和函数。设计决定了:
- 能不能做混合检索
- 能不能做多租户过滤
- 索引效率
关系型数据库的 Schema 错了,加个字段就能改;向量库的 Schema 错了,往往要 drop 重建 + 全量重新摄入(见 3.4)。所以这一步值得多花十分钟。
3.2 本项目的 Schema(含 BM25 函数)
# advanced_rag_agent.py:664(节选)
# 集合不存在则按 dense + sparse(BM25) 混合 schema 创建并建立索引。
# 若已存在旧版集合(缺 sparse 字段),自动 drop 重建以启用混合检索。

fields = [
    FieldSchema("pk", DataType.VARCHAR, is_primary=True, max_length=128),
    FieldSchema("tenant_id", DataType.VARCHAR, max_length=64),      # 多租户分区
    FieldSchema("access_level", DataType.VARCHAR, max_length=32),   # 权限过滤
    # content 必须开启 analyzer(且中文分词),BM25 函数才能基于它生成 sparse 向量
    FieldSchema("content", DataType.VARCHAR, max_length=8192,
                analyzer_params={"type": "chinese"}),
    FieldSchema("parent_content", DataType.VARCHAR, max_length=8192),
    FieldSchema("source", DataType.VARCHAR, max_length=512),
    FieldSchema("parent_id", DataType.VARCHAR, max_length=64),
    FieldSchema("chunk_index", DataType.INT64),
    FieldSchema("dense", DataType.FLOAT_VECTOR, dim=1024),          # bge-m3
    # sparse 为 BM25 函数输出,插入时由 Milvus 根据 content 自动计算
    FieldSchema("sparse", DataType.SPARSE_FLOAT_VECTOR, is_function_output=True),
]

# BM25 函数:content -> sparse(Milvus 原生稀疏检索,中文已配置 analyzer)
bm25 = Function(
    name="bm25",
    input_field_names=["content"],
    output_field_names=["sparse"],
    function_type=FunctionType.BM25,
)
schema = CollectionSchema(fields, enable_dynamic_field=True, functions=[bm25])
三个关键点:
| 点 | 说明 |
|---|---|
analyzer_params={"type": "chinese"} | BM25 需要分词,中文必须指定中文分词器 |
is_function_output=True | sparse 字段由 Milvus 服务端自动计算,不需要自己算 |
enable_dynamic_field=True | 允许额外字段(如 figure_paths)不预先声明 |
注意几个字段是为后续章节预留的,不是当前就用:
tenant_id/access_level→ Ch08 多租户与权限下推parent_id/chunk_index→ Ch04 父子切片的身份键,Ch12 文档去重依赖它sparse→ Ch06 混合检索,本章只建不用
Schema 设计的一个经验:把后面三章要用的字段在建集合时就留好。向量库加字段的代价远高于关系库,宁可先留着空着,别到时候 drop 重建。
3.3 索引
# advanced_rag_agent.py:732
index_params.add_index(field_name="sparse",
                       index_type="SPARSE_INVERTED_INDEX", metric_type="BM25")
| 字段 | 索引类型 | 度量 |
|---|---|---|
dense | AUTOINDEX | COSINE |
sparse | SPARSE_INVERTED_INDEX | BM25 |
两个字段两套度量,这不是笔误:dense 比的是方向余弦,sparse 算的是词频权重。Ch06 讲 RRF 融合时会解释——两条路的分数根本不在同一个量纲上,所以不能直接加权相加。
? 埋一个伏笔(Ch24 才收):注意
dense选的是AUTOINDEX+COSINE。 这个组合看起来是最省事的标准答案,但它有坑——本项目后来实测拿到过best_distance = -0.0325,而余弦距离的合法区间是[0, 2],负数在数学上不可能。现在你只要记住这个选择是在本章做的、并且它会被追查就够了,具体为什么失真、 怎么兜底,留给 Ch24 · 距离语义根治。 这种"今天做的决定,30 天后回来算账"的节奏,才是真实工程的常态。
3.4 维度漂移自修复
# advanced_rag_agent.py:672(节选)
# 兼容旧集合:缺少 sparse 字段则重建(BM25 混合检索需要 content 开启 analyzer)
# 检测到集合需重建 → drop + recreate(实为 1024-dim bge-m3)
if "sparse" in existing and existing_dim == dim and "tenant_id" in existing:
    ...  # 兼容,直接用
else:
    print(f"[VectorStore] 检测到集合需重建({reason})...")
这是"schema 演进"的实用模式:启动时检查现有集合是否符合当前 schema,不符就重建。代价是数据要重新摄入,但比运行时报错好得多。
代价要说清楚:全量重新摄入。本项目当时只有 334 个分片,秒级完成,所以这个选择是合理的。如果是百万级文档的生产库,这段代码就是灾难——那种场景要换成"新集合 + 双写切换",详见进阶题 5。
3.5 Embedding:向量从哪来
| 项 | 值 |
|---|---|
| 模型 | bge-m3(BAAI 开源) |
| 维度 | 1024 |
| 部署 | Ollama(本地) |
| 特点 | 支持多语言、支持 dense + sparse 双输出 |
为什么选 bge-m3?
- 中文效果好(BAAI 是中文向量模型的标杆)
- 1024 维在精度和性能间平衡
- Ollama 支持,无需额外部署
3.6 统一入口的价值
# advanced_rag_agent.py:548
def _make_embedder():
这个统一入口在 Ch11(语义路由)体现出关键价值:意图分类器复用了同一个 embedder,保证线上线下向量空间一致。
如果意图分类用 A 模型、文档检索用 B 模型,两者的向量空间不兼容,就无法用同一套相似度阈值。同一个
_make_embedder()入口,是"向量空间一致性"最便宜的保障方式——比写文档强调、比 code review 都可靠。
常用 Embedding 模型对比:
| 模型 | 维度 | 中文 | 备注 |
|---|---|---|---|
| bge-m3 | 1024 | ✅ 优秀 | 本项目 |
| bge-large-zh | 1024 | ✅ 好 | 仅 dense |
| text-embedding-3-small | 1536 | ⚠️ 一般 | OpenAI |
| m3e-base | 768 | ✅ 好 | 轻量 |
| GTE | 1024 | ✅ 好 | 阿里 |
第三部分小结 · 对照自查
- ✓ 一套 Schema——content 开中文 analyzer + BM25 Function 自动生成 sparse,
is_function_output=True不用自己算 - ✓ 两套度量——dense 用 COSINE、sparse 用 BM25,量纲不同,Ch06 才能讲融合
- ✓ 一个自愈——启动时检测 schema,不符就 drop + recreate;代价是全量重新摄入
- ✓ 一条分工——embedding 出语义、Milvus 出索引;
_make_embedder()统一入口保证向量空间一致
到这里,目标 3 完成——混合检索的字段已经备好。最后一部分,是那种"看起来很小、炸起来很响"的事:依赖版本。
第四部分 · ★ 依赖锁定与配置契约
这一部分拿下目标 4。 路线四步:一次事故 → 修法 → 为什么必须匹配 → 配置也是契约。前两步是 Milvus 专属,后两步是通用的——尤其是最后一条,它跟 ch03 的「密钥三重保障」是同一类事:功能代码定义了"系统要什么",配置模板定义了"部署方要给什么",两者必须同步。
4.1 事故
pymilvus 升到 3.x 后,Function 相关 API 全变,混合检索直接报错。
# pymilvus 2.5.x
from pymilvus import Function, FunctionType
Function(name="bm25", function_type=FunctionType.BM25, ...)

# 3.x:API 变更 → AttributeError / TypeError
注意这个坑的形状:它不是装不上,是装上之后运行时才炸。一个 pip install -U 就能触发,而且报错信息里没有"版本不兼容"四个字。
4.2 修法:锁死版本
# requirements.txt
pymilvus>=2.5,<3.0    # 服务端 v2.5.0,3.x 的 Function API 不兼容
这条写进了项目铁律文档。
锁版本必须写明原因。只写
pymilvus>=2.5,<3.0不写注释,半年后一定有人"顺手升级"——他不坏,他只是不知道为什么。注释里的那句"3.x 的 Function API 不兼容",才是真正防住事故的东西。
4.3 为什么客户端与服务端必须匹配
| 组件 | 版本 | 说明 |
|---|---|---|
| Milvus 服务端 | v2.5.0 | 独立的分布式服务 |
| pymilvus 客户端 | 2.5.x | Python SDK |
Milvus 的客户端/服务端耦合度较高:
- 3.x 客户端改了 Function 相关 API(本项目踩的坑)
- 某些新特性需要服务端同步升级
- 老客户端连新服务端可能不支持新特性
判据:凡是"客户端 SDK + 独立服务端"的架构,都要严格匹配版本。 数据库驱动、向量库 SDK、消息队列客户端都是如此。
判断方法很简单:问一句"这个客户端连的服务端,是不是一个独立进程/独立集群"。是 → 锁版本;不是(纯库,如 requests)→ 可以宽松。
4.4 .env.example 是部署契约(042)
第 042 次提交专门补了 Milvus 的环境变量配置:
# .env.example
MILVUS_HOST=192.168.200.128
MILVUS_PORT=19530
MILVUS_COLLECTION=enterprise_kb
这次是"补提交" —— 说明功能先上线、配置模板后补。这是常见但应该避免的顺序。
正确顺序:功能代码 +
.env.example同一个提交。否则队友部署时缺配置,报错信息还难懂——他看到的是KeyError: 'MILVUS_HOST',而不是"请配置 MILVUS_HOST"。推荐再加一道启动即校验:一次性列出所有缺失项 + 给出
cp .env.example .env的修复建议 +sys.exit(1)让编排系统知道启动失败。详见思考题 6。
第四部分小结 · 对照自查
- ✓ 一次事故——pymilvus 升 3.x,Function API breaking change,混合检索运行时炸
- ✓ 一条铁律——锁
2.5.x并写明原因,否则半年后必被"顺手升级" - ✓ 一条判据——客户端 SDK + 独立服务端架构,必须严格匹配版本
- ✓ 一个契约——
.env.example与功能代码同提交;启动即校验缺失项
到这里,目标 4 完成——四个目标全部拿下。
踩坑总表
把这一章的坑摆到一张表上——五个,全部在本项目的真实提交里踩过:
| # | 坑 | 现象 | 根因 | 严重度 |
|---|---|---|---|---|
| 1 | 以为"有兜底更稳" | 双后端跑 5 天,同样代码在不同环境表现不同 | Milvus 走混合检索、Chroma 走纯 dense,召回质量差一截,且降级静默 | 中等(隐蔽性极强) |
| 2 | pymilvus 自动升级 | pip install -U 后混合检索报错 | 3.x 改了 Function API,与服务端 v2.5.0 不兼容 | 中等 |
| 3 | Milvus 服务不可达 | 启动报连接失败 | 环境未配置 / 服务未起 | 轻微(设计上就该快速失败) |
| 4 | 集合 schema 变更 | 加了 BM25 后旧集合没有 sparse 字段 | 旧集合按旧 schema 建的 | 轻微(有自愈,代价是重新摄入) |
| 5 | 中文分词器未配置 | BM25 检索中文效果极差,但不报错 | 未设 analyzer_params,Milvus 按空格分词,中文整句当一个词 | 高危(静默失效) |
第 1 个和第 5 个是一对"双胞胎"——都不报错,都只是悄悄变差。第 1 个靠"删掉兜底"根治,第 5 个靠显式配置中文分词器根治。凡是"不报错但效果差"的坑,都要靠可观测性兜底——这正是全书那条原则(静默降级比崩溃更危险)的又一次兑现,也是 Ch17 专门讲可观测性与 Token 计量的由来。
对应解法速查:
# 坑 1:删掉兜底 —— 注意「删」的代码形态是「没有代码」:
# 不存在 try: milvus except: chroma 这条分支,同时把残留配置强制纠正回来
# advanced_rag_agent.py:588
requested = (backend or os.getenv("VECTOR_BACKEND", "milvus")).lower()
if requested != "milvus":
    print(f"[VectorStore] 警告:VECTOR_BACKEND={requested!r} 已废弃,"
          f"本项目仅支持 milvus,已强制使用 milvus")
self.backend = "milvus"
# 坑 2:锁版本 + 写明原因
# requirements.txt
pymilvus>=2.5,<3.0    # 服务端 v2.5.0,3.x 的 Function API 不兼容
# 坑 3:不可达就抛错终止启动 —— 不做降级,只给一条明确的死法
# advanced_rag_agent.py:618
try:
    self.client = MilvusClient(uri=uri)
    self._ensure_collection()
except Exception as e:
    raise RuntimeError(
        f"Milvus 初始化失败,系统无法启动(本项目仅支持 Milvus,无 Chroma 兜底): {e}"
    ) from e
坑 3 的排查顺序(部署当天最常见):① 确认 Milvus 容器在跑
docker compose ps; ② 确认MILVUS_URI指向的是服务端可达地址而不是localhost(跨机部署时最容易错); ③ 确认:19530没被防火墙挡。三者都对还报错,才去看 Milvus 自身日志。
# 坑 4:启动时检测,不符则 drop + recreate
# advanced_rag_agent.py:672
if "sparse" in existing and existing_dim == dim and "tenant_id" in existing:
    ...  # 兼容,直接用
else:
    print(f"[VectorStore] 检测到集合需重建({reason})...")
# 坑 5:content 字段必须开中文分词器,否则 BM25 静默失效
# advanced_rag_agent.py:664
FieldSchema("content", DataType.VARCHAR, max_length=8192,
            analyzer_params={"type": "chinese"})
验证坑 5 的方法:直接查一下 sparse 召回的 top-k,如果全是 0 分或者结果不相关,就是分词问题。别靠"感觉效果不好"来判断,要拿出分数。
学习目标回顾
对着开头的四个目标,逐个 check:
- ✓ 目标 1 · 向量库的本质与选型——库是最近邻索引、embedding 是语义来源;ChromaDB 在扩展/混合检索/多租户三处触顶,你拿下了
- ✓ 目标 2 · 兜底的去留——两条路径 = 两套行为;判据是"降级后行为是否等价";快速失败优于静默降质,你拿下了
- ✓ 目标 3 · 混合检索 Schema——BM25 Function 自动生成 sparse、中文 analyzer 必配、两套度量、维度漂移自愈,你拿下了
- ✓ 目标 4 · 依赖锁定与配置契约——pymilvus 锁 2.5.x 并写明原因、
.env.example与功能同提交,你拿下了
四个全过。如果只能带走一句,带这句:
兜底要么做好,要么删掉。判断标准只有一条——降级后的行为,和正常路径大致等价吗?
知识点卡片
【知识点】向量数据库的本质
向量库就干一件事:在高维空间里快速找"最近"的 k 个向量。
三个核心概念:
概念 说明 本项目 Embedding 文本 → 固定维度浮点数组 bge-m3,1024 维 索引(Index) 近似最近邻算法,牺牲精度换速度 AUTOINDEX 度量(Metric) 相似度/距离的定义 COSINE(dense)/ BM25(sparse) 常见索引算法:
算法 原理 特点 FLAT 暴力比对 100% 准确,慢 IVF_FLAT 聚类分桶,只搜相关桶 快,精度略降 HNSW 多层跳表图 快,内存占用高 AUTOINDEX Milvus 自动选择 省心(本项目) 选型建议:原型阶段 ChromaDB/Qdrant 都够用;一旦要上混合检索、多租户、千万级数据,直接 Milvus。迁移成本远高于一开始选对。
【知识点】"降级设计"的两个陷阱
陷阱 1:静默降级
except Exception:
    fallback()      # 只 print,没人看
服务"正常"但质量下降,用户抱怨时你查不出来。
解法:降级必须可观测(醒目日志 + 指标 + 告警)。
陷阱 2:不等价降级
# 主方案:混合检索(5 条相关)
# 备方案:纯 dense(2 条相关)   ← 质量差一大截
两条路径行为不同,出问题不知道跑的哪条。
解法:要么补齐功能等价,要么删掉兜底。
判断标准:
降级后行为 建议 与正常路径等价(只是慢) ✅ 保留降级 部分能力缺失 ⚠️ 保留但必须打日志 质量显著下降 ❌ 删掉兜底,快速失败
练习题
基础题
1. 本项目为什么把"看似更安全"的 ChromaDB 兜底删掉了?
答案三个原因:
原因 1:两条路径行为不一致
| 行为 | Milvus | ChromaDB |
|---|---|---|
| 混合检索 | ✅ dense + BM25 | ❌ 仅 dense |
| 多租户 | ✅ partition_key | ❌ 多 collection |
| 召回质量 | 5 条相关 | 2 条相关 |
同一个问题,两条路径召回质量差一大截。
原因 2:降级是静默的
except Exception:
    print("Milvus 不可用,回退 ChromaDB")    # 只 print 一行,没人看
服务"正常运行",但质量悄悄下降。用户抱怨"最近答得不准",你查不出来——因为系统没报错。
原因 3:测试覆盖不到
测试环境 Milvus 一直可用,Chroma 分支从未被执行过。等生产真的降级时,可能发现那条路径早就坏了。
本项目的结论:
两条路径 = 两套行为 = 排查噩梦。 兜底要么做好,要么删掉。
"做好兜底"的成本:功能等价(写两遍实现)+ 明确告警 + 定期演练。本项目功能无法等价(混合检索是核心能力),所以选择删掉。
通用判断标准: 降级后的行为是否与正常路径大致等价?
- 等价(如缓存失效只是变慢)→ 保留
- 不等价(如检索质量腰斩)→ 删掉,快速失败
2. 为什么 pymilvus 必须锁 2.5.x 而不能升级到 3.x?
因为 3.x 客户端改了 Function 相关 API,导致混合检索(BM25)直接报错。
# pymilvus 2.5.x —— 本项目在用
from pymilvus import Function, FunctionType
bm25 = Function(
    name="bm25",
    input_field_names=["content"],
    output_field_names=["sparse"],
    function_type=FunctionType.BM25,
)

# pymilvus 3.x —— API 变更,上面的写法报 AttributeError / TypeError
根本原因:Milvus 是"客户端 SDK + 独立服务端"架构,两者耦合度较高。
| 组件 | 版本 |
|---|---|
| Milvus 服务端 | v2.5.0 |
| pymilvus 客户端 | 必须 2.5.x |
为什么耦合高?
- Function(服务端计算字段)是较新的特性,API 在 3.x 有 breaking change
- 新特性需要服务端同步支持
- 老客户端连新服务端可能用不了新能力
修法:
# requirements.txt
pymilvus>=2.5,<3.0    # 服务端 v2.5.0,3.x 的 Function API 不兼容
并且要写明原因——否则半年后有人"顺手升级",又踩一遍。
通用原则:凡是"客户端 SDK + 独立服务端"的架构,都要严格匹配版本。 数据库驱动、向量库 SDK、消息队列客户端、RPC 框架都是如此。
3. Milvus 的 BM25 函数为什么需要 analyzer_params={"type": "chinese"}?
因为 BM25 是"词频"算法,需要先分词。中文没有空格,默认按空格分词会把整句当成一个词。
BM25 的原理:
BM25 分数 = Σ (每个查询词的 IDF × 词频饱和度)

核心:统计"查询词在文档中出现多少次"
→ 前提是文档已经被切成一个个"词"
中英文的差异:
英文:"heartbeat interval is 60 seconds"
     按空格分词 → ["heartbeat", "interval", "is", "60", "seconds"]  ✅ 天然可分词

中文:"心跳间隔默认为60秒"
     按空格分词 → ["心跳间隔默认为60秒"]   ❌ 整句一个"词"
后果:
- 用户查询"心跳间隔"→ 这个"词"在任何文档里都找不到(因为整句才是一个词)
- BM25 对所有文档都返回 0 分 → 稀疏检索完全失效
- 你以为在做混合检索,实际上只有 dense 在起作用
正确配置:
FieldSchema("content", DataType.VARCHAR, max_length=8192,
            analyzer_params={"type": "chinese"})
这个坑的隐蔽之处:不配也不报错,只是效果差。你会以为是"BM25 对中文效果不好",实际是配置问题。
验证方法:直接查一下 sparse 召回的 top-k,如果全是 0 分或者结果不相关,就是分词问题。
进阶题
4. 你的系统用 Milvus,某天服务不可达。团队讨论要不要加一个"降级到本地 FAISS"的兜底。请你评估这个方案。
参考答案先问三个问题,再决定。
问题 1:降级后行为等价吗?
| 能力 | Milvus | FAISS(本地) |
|---|---|---|
| dense 向量检索 | ✅ | ✅ 等价 |
| BM25 混合检索 | ✅ | ❌ 需自己实现 |
| 多租户过滤 | ✅ partition_key + expr | ❌ 需自己实现 |
| 权限下推 | ✅ | ❌ |
| 分布式/水平扩展 | ✅ | ❌ 单机 |
| 数据持久化 | ✅ | ⚠️ 需自己管 |
结论:不等价。 FAISS 只是个库,缺了 Milvus 的服务化能力(混合检索、过滤、多租户)。
问题 2:降级后质量下降多少?
如果核心能力是混合检索(本项目的场景),降级到纯 dense 后:
| 查询类型 | Milvus(混合) | FAISS(纯 dense) |
|---|---|---|
| "心跳间隔" | ✅ 精准命中 | ✅ 能命中 |
| "JM-S509 波特率" | ✅ BM25 精准匹配型号 | ⚠️ 可能召回同系列其他型号 |
| 同义词改写 | ✅ dense 泛化 | ✅ 同样好 |
型号/专有名词类查询质量显著下降。 这类查询在设备手册场景占比很高。
问题 3:"服务不可达"的概率和代价?
| 概率 | 代价 | |
|---|---|---|
| Milvus 挂了 | 低(有运维保障) | 服务不可用 |
| 降级到 FAISS | — | 答案质量下降,但用户不知道 |
关键权衡:
- 不降级:Milvus 挂 = 服务挂,但立刻被发现、立刻修复
- 降级:Milvus 挂 = 服务"正常",但答案悄悄变差,可能长期无人发现
我的建议
不加 FAISS 兜底,改为"快速失败 + 可观测 + 高可用建设"。
理由:
- 行为不等价,降级会掩盖问题
- 静默降质比服务中断更危险(用户会基于错误答案做决策)
- 投入产出比低(维护两套检索逻辑)
正确的投入方向:
1. 快速失败:Milvus 不可达 → 启动/请求直接报错,不要静默降级
2. 可观测:Milvus 健康检查 + 告警(P99 延迟、错误率)
3. 高可用:Milvus 集群化(多副本)、连接池重试
4. 应急预案:明确"Milvus 挂了怎么办"的运维手册
什么时候可以加兜底?
如果满足全部以下条件:
□ 降级后行为大致等价(只是慢一点,不是差一截)
□ 降级时会明确告警(不只 print)
□ 降级路径有定期演练(每季度至少一次)
□ 有明确的"恢复"流程
□ 能接受两套逻辑的维护成本
举例:缓存(Redis)挂了降级到直连数据库——行为等价(只是慢),这个兜底是合理的。
一句话: "可用性"不等于"服务永远返回结果",而是"要么返回正确的结果,要么明确报错"。 静默返回质量下降的结果,是最糟糕的"高可用"。
5. 启动时检测到 Milvus 集合 schema 不匹配(缺 sparse 字段),本项目选择 drop + recreate。请分析这个方案的代价和替代方案。
参考答案当前方案:drop + recreate
# 若已存在旧版集合(缺 sparse 字段),自动 drop 重建以启用混合检索
if not has_sparse_field(existing):
    drop_collection()
    create_collection_with_new_schema()
优点:
- 简单,一条路径
- 保证 schema 一定正确
代价:
| 代价 | 说明 |
|---|---|
| 数据全丢 | 必须重新摄入全部文档 |
| 服务中断 | 重建期间集合不可用 |
| 大库耗时长 | 百万级文档重建可能要几小时 |
| 风险 | 如果重建到一半失败,数据没了也没建成 |
替代方案
方案 A:创建新集合 + 双写切换(推荐生产环境)
1. 创建新集合 kb_v2(新 schema)
2. 后台摄入数据到 kb_v2(不影响线上)
3. 双写:新摄入同时写 kb_v1 和 kb_v2
4. 校验:对比两个集合的检索结果
5. 切换:配置指向 kb_v2
6. 观察一段时间后删除 kb_v1
- 优点:零中断、可回滚
- 缺点:实现复杂,需要双写逻辑
方案 B:新增字段(如果 Milvus 支持)
Milvus 2.5 支持部分 schema 变更,但加 Function 输出字段通常不行(需要重建)。
需要查具体版本的能力。
方案 C:接受重建,但优化过程
# 重建前先备份(导出数据)
backup_collection()
# 重建
drop_and_create()
# 分批摄入(避免单次任务过大)
for batch in batches:
    ingest(batch)
- 优点:保留了当前方案的简单性
- 缺点:仍有中断窗口
方案 D:版本号集合名
kb_v1(旧 schema)
kb_v2(新 schema)
配置里指定用哪个
比 drop 安全——旧数据还在,可回滚。
本项目的选择合理吗?
合理,因为是项目早期(Day 7-12)。
| 因素 | 当时的情况 |
|---|---|
| 数据量 | 小(2 份 PDF,334 分片) |
| 用户量 | 无(还在开发) |
| 重建耗时 | 秒级 |
| 中断代价 | 零 |
在数据量小、无用户时,drop + recreate 是最优解——简单直接。
但如果这是生产环境(百万级文档、有真实用户),应该升级为方案 A(双写切换)。
判据:
重建耗时 < 可接受中断时间 且 无用户影响? ├─ 是 → drop + recreate 最简单 └─ 否 → 上双写切换实践建议:在项目早期就用版本号集合名(
kb_v1、kb_v2),这样 schema 变更时成本最低,也保留了回滚能力。
思考题
6. 本项目第 042 次提交是"补提交环境变量的 milvus 配置"——功能先上线,配置模板后补。请分析这个顺序的问题,并设计正确的流程。
参考答案这个顺序的问题
问题 1:队友部署时缺配置
队友 clone 代码 → 按 README 部署 → 启动报错
"Milvus connection failed" 或 KeyError: 'MILVUS_HOST'
→ 队友不知道要配哪些环境变量
→ 只能翻代码或问你
问题 2:报错信息不友好
没有 .env.example 时,缺配置的表现是运行时异常(连接失败、KeyError),而不是启动时明确提示。
# 没有校验时
KeyError: 'MILVUS_HOST'          ← 堆栈里才知道缺什么

# 有校验时
缺少必需环境变量: ['MILVUS_HOST'],请参考 .env.example   ← 一眼知道
问题 3:配置漂移
如果配置只在口头/文档里流传,不同环境的配置会不一致,排查时非常痛苦。
正确的流程:配置与代码同提交
┌─────────────────────────────────────┐
│ 同一次提交包含:                     │
│  1. 功能代码(用 Milvus)            │
│  2. .env.example(新增配置项)       │
│  3. README(说明如何配置)           │
│  4. 启动校验(缺配置明确报错)        │
└─────────────────────────────────────┘
具体实现
第 1 步:.env.example 与功能同提交
# .env.example
# 向量库(Day 7 新增)
MILVUS_HOST=192.168.200.128
MILVUS_PORT=19530
MILVUS_COLLECTION=enterprise_kb
第 2 步:启动时校验(快速失败)
REQUIRED = {
    "MILVUS_HOST": "向量库地址,如 192.168.200.128",
    "MILVUS_PORT": "向量库端口,默认 19530",
    "OLLAMA_BASE_URL": "Ollama 地址",
}

def check_env():
    missing = [f"  {k:16s} {v}" for k, v in REQUIRED.items() if not os.getenv(k)]
    if missing:
        print("缺少必需的环境变量:")
        print("n".join(missing))
        print("n请复制 .env.example 为 .env 并填写:cp .env.example .env")
        sys.exit(1)     # 非 0 退出,让容器/编排系统知道启动失败
要点:
- 一次性列出所有缺失项(不要发现第一个就退出,否则要反复重启)
- 给出修复建议(
cp .env.example .env) - 用
sys.exit(1)(让 Docker/K8s 知道启动失败)
第 3 步:把校验加入 CI(可选)
# .github/workflows/config-check.yml
- name: 检查 .env.example 与代码里的 os.getenv 是否一致
  run: python scripts/check_env_consistency.py
自动检测:代码里 os.getenv("X") 用到的变量,.env.example 里是否都有。
这个流程的收益
| 收益 | 说明 |
|---|---|
| 新人 5 分钟跑起来 | 不用问"要配什么" |
| 缺配置立刻知道 | 启动时报错,不是运行时 |
| 配置不漂移 | .env.example 是唯一契约 |
| CI 兜底 | 漏补配置会被流水线拦住 |
一句话:
.env.example是部署契约,和功能代码同等重要。 功能代码定义了"系统要什么",.env.example定义了"部署方要给什么"——两者必须同步。本项目这次"补提交"虽是小问题,但暴露了流程缺口:配置变更没有和功能变更绑定。用 CI 检查可以根治。
本章小结
| 收获 | 内容 |
|---|---|
| 一个认知 | 库只是最近邻索引,语义来自 embedding——换库换不掉语义口径 |
| 一个反直觉决策 | 删掉"看似更安全"的兜底 —— 两条路径 = 两套行为 = 排查噩梦 |
| 一个判断标准 | 降级后行为是否等价?等价可保留,不等价就删掉或补齐 |
| 一个 Schema | content 开中文 analyzer + BM25 Function 自动生成 sparse(为 Ch06 预留) |
| 一个铁律 | pymilvus 锁 2.5.x(客户端/服务端版本必须匹配),锁版本要写明原因 |
| 一个流程 | .env.example 与功能代码同提交(配置是部署契约) |
下一章:Ch06 · 混合检索与 RRF 融合 —— ★5 核心篇。本章建好的 sparse 字段终于要派上用场:dense 与 BM25 互补的原理,以及为什么两条路的分数不能直接加权相加。
导航: 上一篇:文档摄入与父子切片 · 下一篇:混合检索与 RRF →