YOLO26项目落地指南:数据标注、训练评估到部署
运行官方示例并不难,真正把目标检测模型送到生产环境,却要连续处理数据质量、训练配置、指标解释和推理一致性等问题。以工业缺陷检测为例,下面按照项目实际推进顺序拆解 YOLO26 的完整链路,并说明每个阶段应保存哪些产物、如何定位偏差以及部署前需要完成哪些验证。
YOLO26 实战:一个检测项目从头做到上线,每步会卡在哪
官方 demo 三行就能跑,但真做一个项目完全是另一回事。
这篇文章不按"知识点"组织,而是按做事的顺序走一遍:拿到一批图 → 标注 → 训练 → 看指标 → 导出上线。每一步我会写清楚这里通常会出什么问题、为什么、怎么改,而不是只给一个"推荐配置"。
文中的场景设定为一个工业零件表面缺陷检测项目(这类型最容易暴露全流程的各种坑),你可以直接替换成自己的场景。
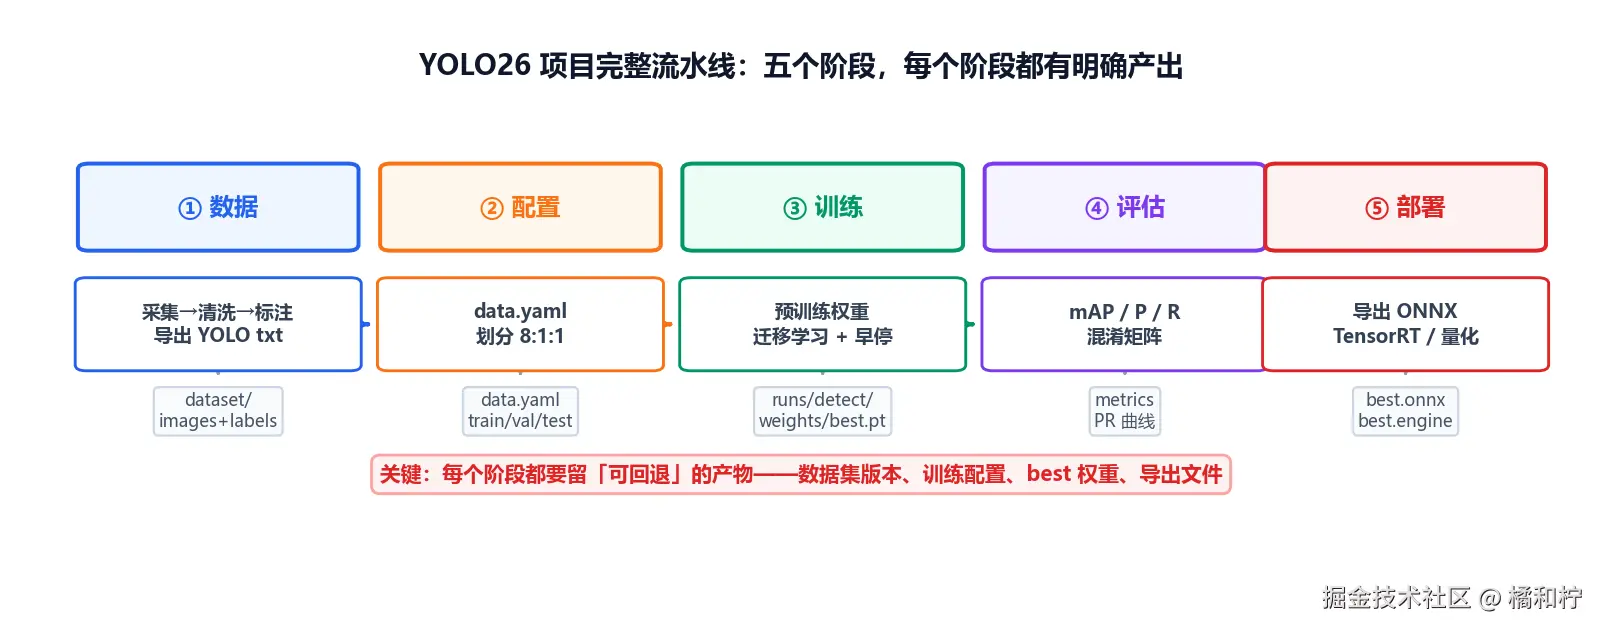
一、五个阶段,每段都要留一个能回退的东西
做项目最怕的不是某一步做错,而是做错了没法回头。所以每段都要留下产物:
| 阶段 | 留下什么 | 为什么要留 |
|---|---|---|
| 数据 | dataset/(图 + txt) | 后面指标不对,第一个要怀疑的就是数据 |
| 配置 | data.yaml | 换机器、换人接手时能原样复现 |
| 训练 | best.pt | 权重文件里其实自带完整训练配置 |
| 评估 | 指标 + 混淆矩阵 | 证明"好"在哪里、"差"在哪里 |
| 部署 | .onnx / .engine | 出问题能和 .pt 对比 |
最典型的翻车顺序是:数据没复核就开训 → 训完只看一个 mAP 数字就部署 → 客户现场发现漏检 → 回头改数据,此时已经白跑好几轮。
二、标注:格式很简单,坑都在细节里
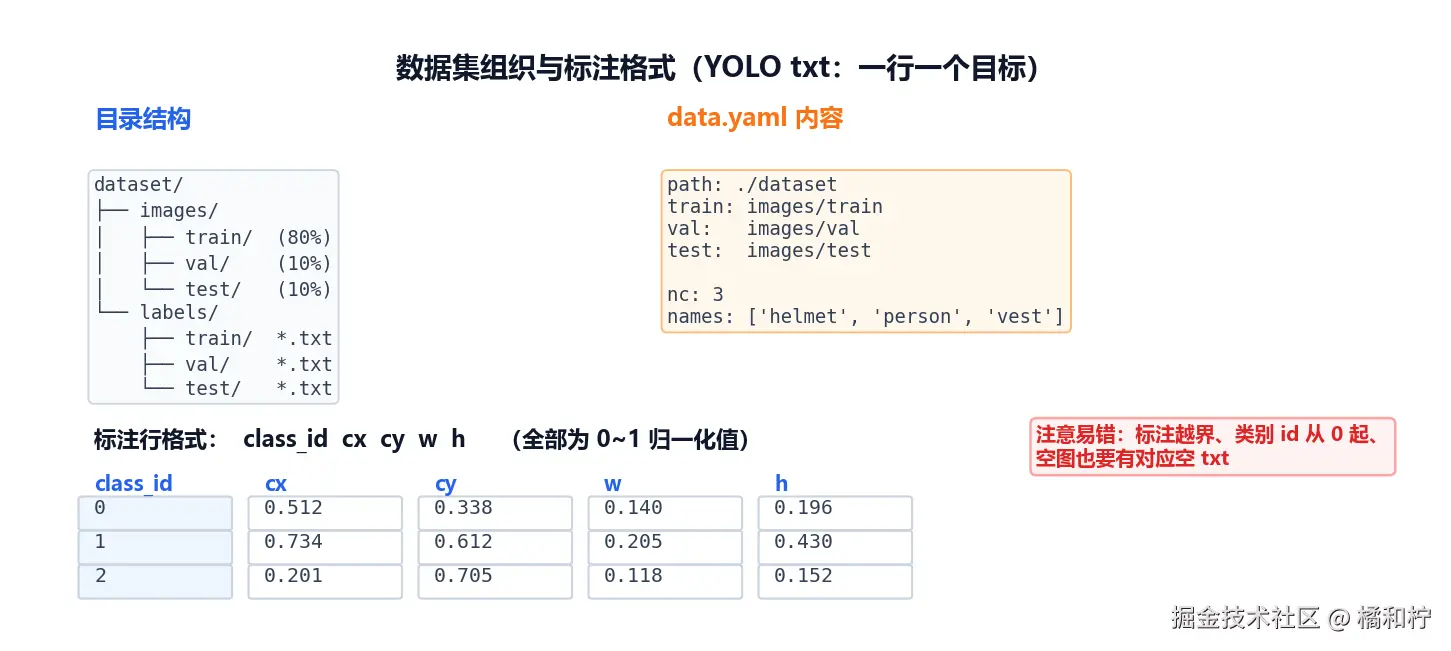
YOLO 的标注就是每张图一个 txt,一行一个目标:
class_id cx cy w h
规则只有两条:class_id 从 0 开始;cx/cy/w/h 都是 0~1 的相对值(相对整图宽高)。
真正会卡住你的是这几件事:
1)类别 id 到底从 0 还是 1 开始
从 0 开始。很多标注工具导出时是从 1 开始的,直接拿来训会出现"第一类永远检不出"或者报类别越界。转换脚本里记得 -1。
2)改了图但没同步改标注
这是最隐蔽的一类。你对原图做了旋转、裁剪、缩放,但标注坐标还是老的——模型学到的全是错位置,loss 也能降下来,mAP 却怎么都上不去,看起来像模型问题,实际是数据问题。
正确顺序:先标注,后做几何变换,且变换时用同一套变换矩阵同步更新框坐标。
3)空图要不要有 txt
要有,空的 txt。否则部分版本会跳过或报错,而且你没法区分"这张图没目标"和"这张图标注丢了"。
4)验证集不能按图随机分
如果数据是视频抽帧来的,相邻帧几乎一模一样。随机划分会让同一场景的帧同时出现在 train 和 val,指标虚高,上线就崩。这种情况要按时间段或按场景切分。
一个标注体检脚本
与其靠肉眼,不如先跑一遍统计。下面这个脚本会检查越界、类别错误、空标注,并统计每个类的目标数:
import glob, os

def check_labels(label_dir, nc):
    stat, bad = [0] * nc, []
    for f in glob.glob(os.path.join(label_dir, "*.txt")):
        lines = [l.strip() for l in open(f, encoding="utf-8") if l.strip()]
        if not lines:
            bad.append((f, "空标注")); continue
        for i, l in enumerate(lines):
            p = l.split()
            if len(p) != 5:
                bad.append((f, f"第{i+1}行字段数={len(p)}")); continue
            c = int(p[0])
            if not (0 <= c < nc):
                bad.append((f, f"类别越界 {c}")); continue
            cx, cy, w, h = map(float, p[1:])
            if not (0 <= cx <= 1 and 0 <= cy <= 1 and 0 < w <= 1 and 0 < h <= 1):
                bad.append((f, f"坐标异常 {p[1:]}")); continue
            stat[c] += 1
    return stat, bad

stat, bad = check_labels("dataset/labels/train", nc=3)
print("各类别目标数:", stat)
print(f"问题标注 {len(bad)} 处,前 10:")
for f, why in bad[:10]:
    print("  ", os.path.basename(f), why)
看什么:
- 某个类的目标数远少于其他类 → 这个类别大概率学不好,先补数据
- 有大量"空标注" → 确认是真的没目标,还是标注漏了
- 有"坐标异常" → 转换脚本有问题
三、训练:先用默认配置跑一遍,别上来就调参
很多人拿到数据第一件事是翻"最佳超参数",其实应该反过来——先用默认配置跑一个基线,否则你后面所有改动都无法判断是变好还是变坏。
# -*- coding: utf-8 -*-
from ultralytics import YOLO

model = YOLO("yolo26s.pt")        # n/s/m/l/x 按算力选

results = model.train(
    data="dataset/data.yaml",
    epochs=150,
    imgsz=640,
    batch=32,                     # 显存不够就调小,或 batch=-1 自动探测
    device=0,
    workers=8,
    patience=30,                  # 30 轮没提升就停
    cos_lr=True,
    close_mosaic=20,              # 最后 20 轮关掉 mosaic
    project="runs/detect",
    name="baseline",
)
跑完看两件事:
- 验证集 loss 有没有反弹 —— 反弹就是过拟合,说明数据不够或增强太弱
- 各类别 AP 的分化 —— 平均 mAP 好看但某一类很低,是这类数据的锅
按数据规模挑一个起点
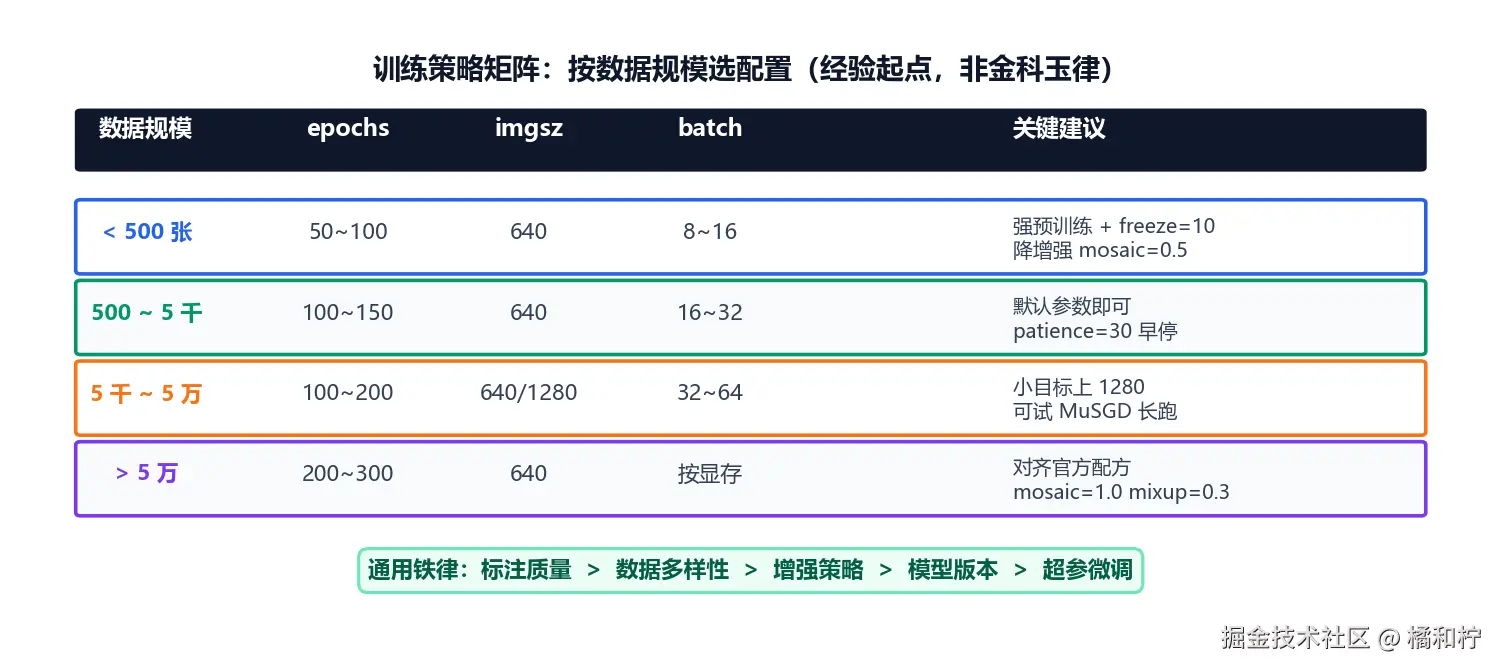
这张图给的是起点,不是标准答案。数据规模主要影响两件事:epoch 数(越少的数越怕过拟合)和增强强度(数据少时强增强更容易把目标搞得认不出)。跑完基线再根据你自己的曲线调整。
数据少的时候怎么调
数据不到一千张时,默认那套强增强(mosaic 接近 1.0、mixup、copy_paste)反而不合适——官方的增强强度是为大模型在 COCO 上训设计的,小数据集照抄容易过拟合或把目标搞得认不出。
官方针对小数据集给的方向是:降低增强强度、换用更温和的优化器与更小学习率、减少 epoch 并用早停、可考虑冻结部分骨干层。
model.train(data="data.yaml",
            epochs=50, patience=20,
            optimizer="AdamW", lr0=0.001,
            mosaic=0.5, mixup=0.0, copy_paste=0.0,
            freeze=10)            # 冻结骨干前 10 层
至于工业场景,还有一条经验值得单独说:缺陷的方向和颜色往往是判别特征。如果你的缺陷长相固定(比如焊点虚焊的灰度特征),把 HSV 色调扰动开太大反而会让模型学不到真正的判别依据。这种情况下可以先把颜色类增强关小:
model.train(data="data.yaml",
            hsv_h=0.0,      # 色调不动
            hsv_s=0.2,      # 饱和度轻微
            hsv_v=0.3,      # 亮度可以模拟光照变化
            degrees=5.0,    # 小角度
            flipud=0.0)     # 有方向性的目标别上下翻
用哪个预训练权重
除了默认的 COCO 权重(yolo26s.pt),官方还发布了 Objects365 预训练权重:
YOLO("yolo26s-objv1-150.pt") # Objects365 上训了 150 epoch
官方说明所有 COCO 检查点都是从同尺寸的 Objects365 权重微调来的,这些预训练权重本身也已发布。至于你的项目用哪个更好——这取决于你的数据规模和类别数量,没有统一答案,两种都跑一遍最直接。
四、评估:指标到底在说什么
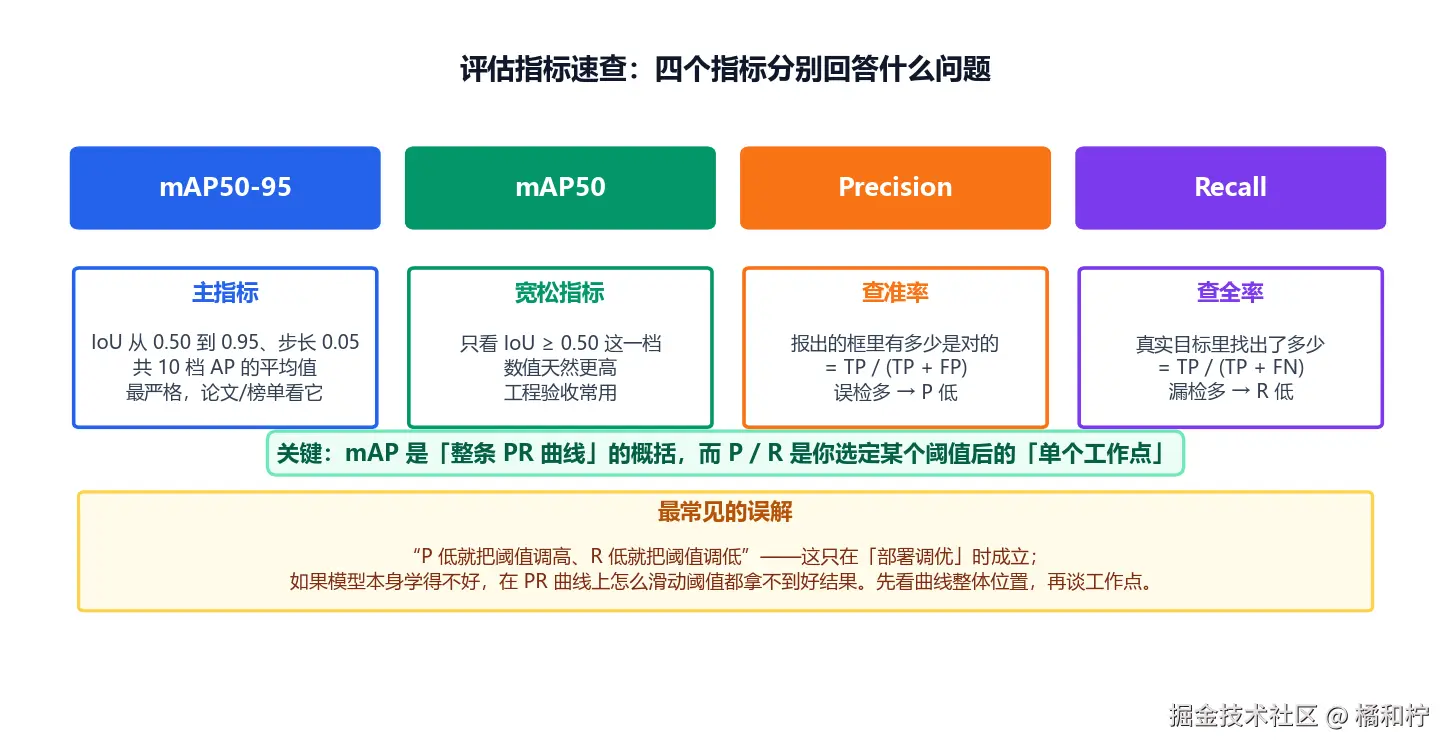
先用大白话把四个指标说清楚:
- mAP:把"模型在各种严格程度下的表现"平均成一个数,是最常看的总体分
- mAP50:只按最宽松的标准(框重叠一半就算对)算的分数,数值天然更高
- Precision(查准率):模型报出来的框里,有多少是真的
- Recall(查全率):真实存在的目标里,模型找出了多少
model = YOLO("runs/detect/baseline/weights/best.pt")
metrics = model.val(data="dataset/data.yaml", split="test")

print(f"mAP50-95 = {metrics.box.map:.4f}")
print(f"mAP50    = {metrics.box.map50:.4f}")

# 每个类别单独看 AP —— 均值高不代表每一类都好
for i, name in enumerate(model.names.values()):
    print(f"  {name:12s} AP50-95={metrics.box.ap[i]:.4f}")
别忘了看分类别 AP。mAP 是平均值,一个 0.9 的类可以掩盖一个 0.3 的类——而后者往往才是你线上出问题的那个。
最容易被搞混的一点:P/R 和阈值的关系
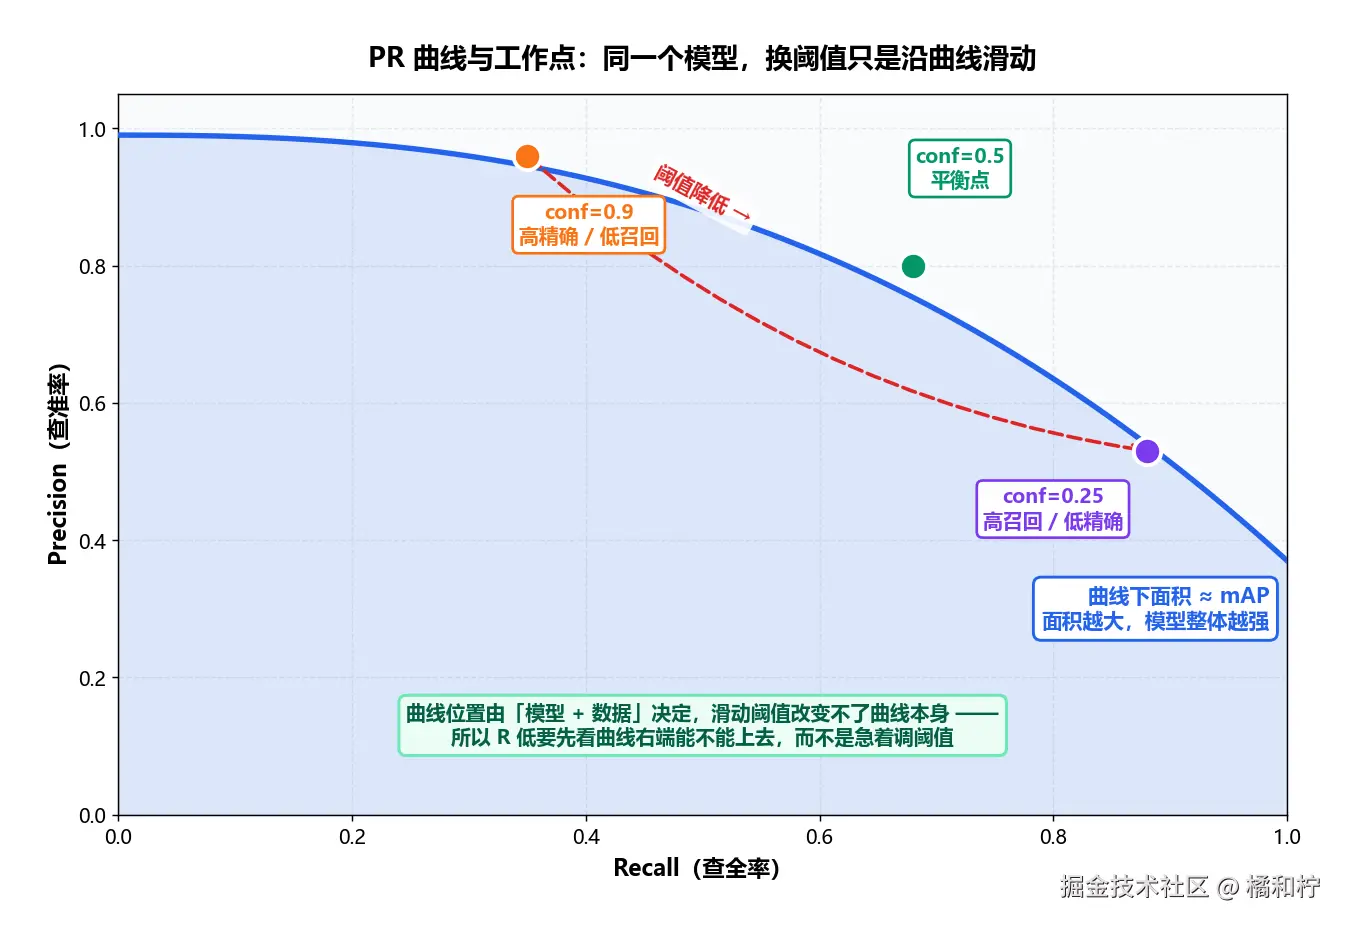
关键认知:mAP 描述的是「整条 PR 曲线」(模型能力),而你部署时设的置信度阈值,只是在这条曲线上选一个工作点。
- 阈值调高:更保守,报出来的基本都对(P 高),但会漏掉不少(R 低)
- 阈值调低:更激进,找得多(R 高),但混进更多误报(P 低)
所以"R 低就把阈值调低"只对了一半:如果模型本身没学好,PR 曲线整体就贴着左下角,你怎么滑阈值都拿不到好结果。那时候该改的是数据和模型,不是阈值。
一个很常见的骗局:mAP 很高,但线上全是漏检
在缺陷检测这类场景里特别容易遇到。原因是类别严重不平衡——缺陷图占比很小,模型只要"多猜有缺陷"就能在指标上占便宜,代价是正常图上一堆误报,以及真实缺陷照样漏掉。
可以往训练集里再补 30% 的正常无缺陷图像,强制模型学会"什么算正常"。
所以:
- 往训练集里补正常(无目标)图像,让模型学会"什么算正常"
- 分开统计两个指标:缺陷图的召回率、正常图的误检率。只看 mAP 会被骗。
- 工业检测里召回率通常比精度更重要(漏检代价远高于误报),别只盯着一个 mAP 调优。
model.val() 生成的 confusion_matrix.png 也值得看:哪两个类互相混淆(类别定义或标注标准不一致),以及多少目标被判成 background(漏检的主要来源)。
五、导出:必须和原模型对一遍再上线
model = YOLO("runs/detect/baseline/weights/best.pt")

# 先出 ONNX,这个环节是用来验证"导出有没有改变结果"的
model.export(format="onnx", opset=17, simplify=True)

m_onnx = YOLO("runs/detect/baseline/weights/best.onnx")
r1 = model.val(data="dataset/data.yaml", split="test")
r2 = m_onnx.val(data="dataset/data.yaml", split="test")
print(f"pt   mAP={r1.box.map:.4f}")
print(f"onnx mAP={r2.box.map:.4f}   差 {abs(r1.box.map - r2.box.map):.4f}")

# 确认没问题,再按硬件转专用格式
model.export(format="engine", device=0)     # NVIDIA GPU
model.export(format="openvino")             # Intel CPU
为什么必须对比:导出过程会做算子融合、精度转换、图简化,任何一步都可能悄悄改变结果。最常见的差异来源是预处理不一致(通道顺序、归一化、resize 方式)和精度(FP16 对某些图像动态范围大的场景损失明显)。
所以排查顺序是:先确认预处理是否一致(BGR/RGB、除以 255、HWC→CHW),再确认精度(必要时强制 FP32 对比一次)。
差多少算能接受?没有通用阈值——取决于你的任务对精度的敏感度。你要做的是:在同一份验证集上跑出两个数字,看你项目能接受多大的落差。
部署侧最常踩的两个坑
1)INT8 校准集不能用训练图随便抽
校准集的作用是让量化算法看到真实的数据分布。用错分布,量化后的掉点会远超预期。要用真实场景的图。
2)小模型上 INT8 不一定更快
量化省的是计算,但会引入 kernel 启动和数据转换开销。计算量本来就不大的小模型,INT8 有时反而比 FP16 慢。这个问题没有捷径,只能在你自己的硬件上实测。
import time
import numpy as np
from ultralytics import YOLO

m = YOLO("best.engine")
IMG = "real_scene.jpg"

for _ in range(10):
    m.predict(IMG, verbose=False)          # 预热,不预热首帧会误导你

ts = []
for _ in range(100):
    t0 = time.perf_counter()
    m.predict(IMG, verbose=False)
    ts.append((time.perf_counter() - t0) * 1000)

a = np.array(ts)
print(f"均值 {a.mean():.2f} ms | P99 {np.percentile(a,99):.2f} | "
      f"最差 {a.max():.2f} | ≈ {1000/a.mean():.1f} FPS")
看 P99 和最大值,别只看均值——实时系统里卡的是最差那几帧。
六、卡住时的排查顺序
| 症状 | 先怀疑什么 | 怎么确认 |
|---|---|---|
| mAP 一直很低 | 标注有问题 | 把标注框画到图上,人工看 50 张 |
| 训练集好、验证集差 | 过拟合 | 看 val loss 曲线有没有反弹 |
| 漏检多 | 小目标 / 阈值过高 / 漏标 | 提高 imgsz 试一次;查标注 |
| 误检多 | 缺负样本 | 补无目标的图;调高阈值 |
| loss 变 nan | lr 过大或标注越界 | 降 lr0;跑体检脚本 |
| 显存溢出 | batch / imgsz 过大 | 调小,或 batch=-1 自动 |
| 导出后结果变了 | 预处理或精度不一致 | 用 val 对比 pt 与导出模型 |
一句话:指标不对先查数据,速度不够再查模型和部署。反过来做的,基本都要返工。
参考来源
- Ultralytics 官方文档(YOLO26 模型页、训练配方、导出文档)
关键词:YOLO26 目标检测 数据标注 模型训练 mAP ONNX TensorRT Ultralytics
环境:ultralytics 8.4+ / PyTorch 2.x / CUDA 12.x