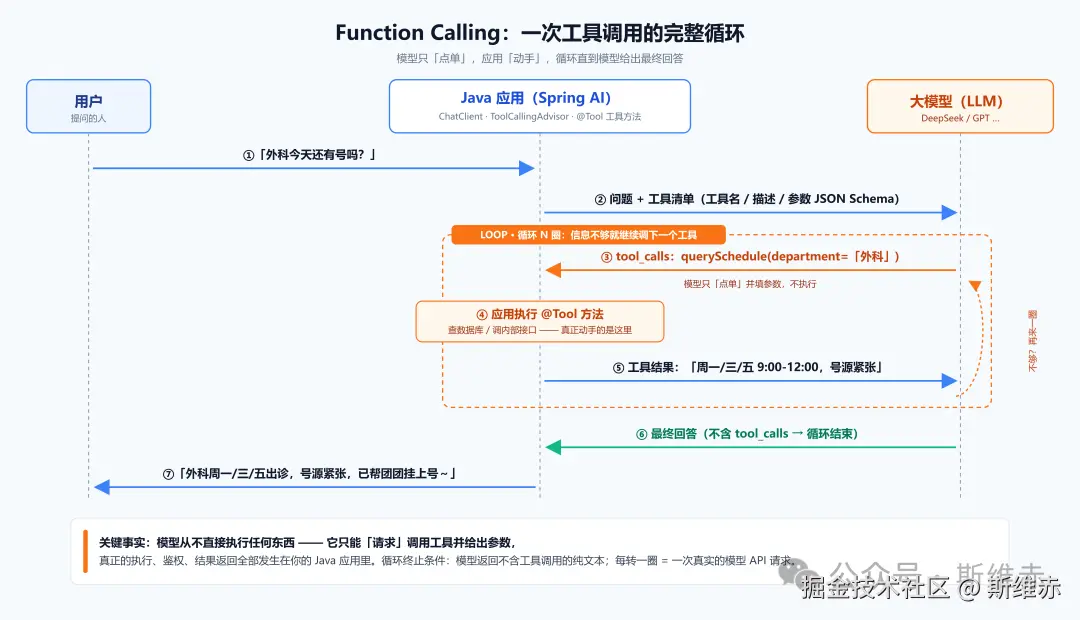
Spring AI 中的 Function Calling 到底如何工作?
一个语言模型即使熟悉业务知识,也不代表它能读取实时排班、访问内部接口或完成挂号。要让回答建立在真实数据和实际操作之上,应用需要在模型与业务函数之间建立受控的调用流程。Spring AI 提供的 Function Calling,正是连接模型判断与 Java 代码执行的关键机制。
本篇目标:搞懂 Function Calling 的原理与协议,并用 Spring AI 2.0 给"宠物门诊智能助手"装上能查排班、能挂号的"手"。
技术栈:Spring AI 2.0 + Spring Boot 4 + JDK 21,模型用 DeepSeek(OpenAI 兼容接口)
前置知识:《ChatClient & Prompt 篇》(本篇直接在那套代码上继续加功能)
01 会聊天 ≠ 会干活
经过前面几篇的打磨,你的宠物门诊助手已经能像模像样地导诊了:懂角色、会模板、有记性、还能输出结构化的症状单。但只要你问它一句——
"帮我查一下今天外科还有号吗?"
它就会开始表演:
"您好!外科今天号源一般比较充足,建议您早点到院哦~"
注意,它不是查了排班,它是编了一段听起来合理的话。数据库里明明写着"号源紧张",它照样微笑着告诉你"比较充足"。
这不是模型退化了,而是 LLM 天生的三个"不会"
? 类比
LLM 像一位博学但被锁在会议室里的顾问:上知天文下知地理,但你让他查库存、订会议室、发邮件,他只能口头描述"应该这么干",一步也出不了门。
Function Calling,就是给他配一部手机。
02 Function Calling:一场"点外卖"式协作
Function Calling(也叫 Tool Calling,Spring AI 用后者)的机制,本质上是模型和应用之间约定好的一套协作协议。用点外卖类比,一次协作是这样的:
-
你告诉外卖平台你的菜单——应用先把"有哪些工具可用"(工具名、功能说明、参数结构)发给模型;
-
平台决定要不要下单——模型理解你的问题后,判断"这事我需要调工具",返回一个工具调用请求:调哪个工具、参数是什么;
-
骑手真正去取餐——应用(不是模型!) 执行真正的函数:查数据库、调接口;
-
把餐递回会议室——执行结果作为一条消息回传给模型;
-
顾问吃完再答复你——模型结合工具结果,生成最终的自然语言回答。
这里有一个安全上的关键设计,面试和实战都常考:
⚠️ 模型从不直接执行任何东西。
模型只能**"请求"**调用某个工具并给出参数,真正的执行、鉴权、结果返回全部发生在你的 Java 应用里。模型拿不到你的数据库连接串,也碰不到你的内部 API。它是"动嘴的",你是"动手的"。
翻译成协议层的报文,就是三条消息的接力(这就是前一篇《大模型 API 调用》里讲的 messages 数组的新玩法):
// ① 应用 → 模型:问题 + 工具清单
{
  "messages": [{"role": "user", "content": "今天外科还有号吗?"}],
  "tools": [{
    "type": "function",
    "function": {
      "name": "querySchedule",
      "description": "查询指定科室的门诊时间与剩余号源",
      "parameters": { "type": "object", "properties": { "department": { "type": "string" } } }
    }
  }]
}

// ② 模型 → 应用:不直接回答,而是返回"工具调用请求"
{
  "role": "assistant",
  "tool_calls": [{
    "id": "call_abc123",
    "function": { "name": "querySchedule", "arguments": "{"department": "外科"}" }
  }]
}

// ③ 应用执行完,把结果发回去,模型再生成最终回答
{
  "role": "tool",
  "tool_call_id": "call_abc123",
  "content": "周一/三/五 9:00-12:00,号源紧张"
}
看清楚这三步,你就明白了:Function Calling 没有任何魔法,它只是把"函数签名"用 JSON Schema 告诉模型,模型用结构化 JSON 回填参数。模型做的全部工作,就是"填表"。
03 一次工具调用的完整时序
把上面的三步协议展开成完整流程(注意模型可能连续调用多个工具、也可能不调用),长这样:
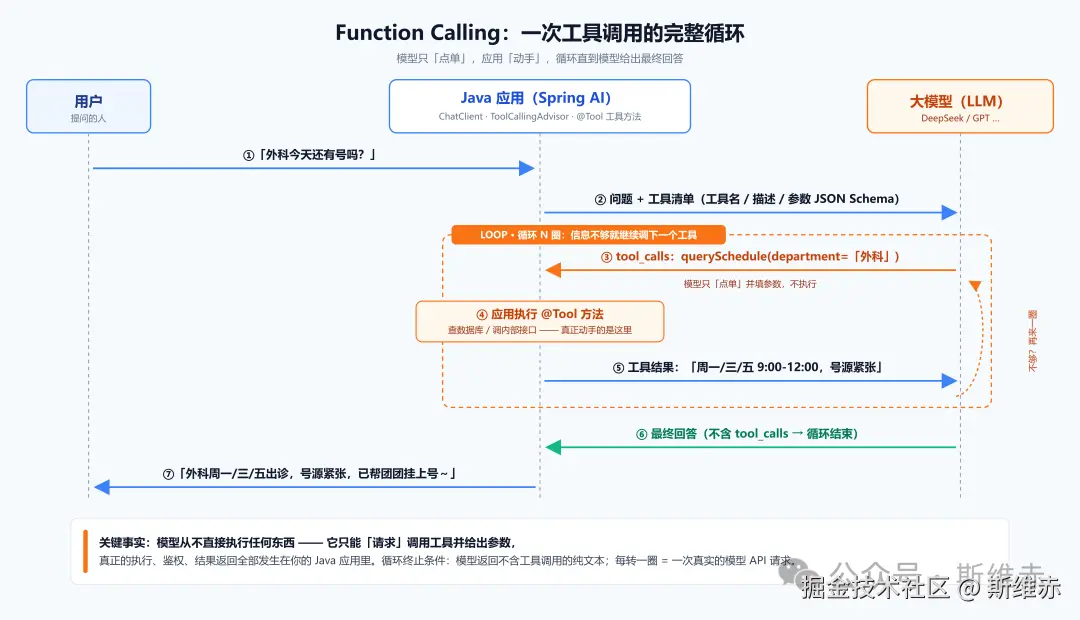
四个要点:
| # | 要点 | 说明 |
|---|---|---|
| ① | 模型自己决定调不调工具 | 你只提供工具清单,调不调、调哪个、传什么参数,全由模型判断 |
| ② | 一个问题可能触发多轮循环 | "查下外科排班,紧张的话帮我挂明天的号" → 查排班 → 拿到结果 → 再挂号,循环转两圈 |
| ③ | 循环结束的标志是模型不再要工具 | 模型觉得信息够了,输出纯文本,循环终止,答案返回调用方 |
| ④ | 每一轮都是真实的 HTTP 请求 | 循环一圈 = 请求一次模型 API,工具越多问题越复杂,token 消耗越大 |
理解了这张图,"Agent"这个词也就祛魅了:所谓 Agent,就是让这个循环转起来、并且模型有工具可用的系统。 Function Calling 正是 Agent 的发动机。
04 Spring AI 2.0 实战:给助手装上"手"
4.1 定义工具:一个 @Tool 注解的事
package com.pet.clinic.tool;

import org.springframework.ai.tool.annotation.Tool;
import org.springframework.ai.tool.annotation.ToolParam;
import org.springframework.stereotype.Component;

import java.util.Map;

@Component
public class ClinicTools {

    /** 模拟排班数据(生产环境替换为 DB / HIS 接口查询) */
    private static final Map<String, String> SCHEDULES = Map.of(
            "内科", "周一至周五 9:00-17:00,号源充足",
            "外科", "周一/三/五 9:00-12:00,号源紧张",
            "皮肤科", "周二/四 14:00-17:00,号源充足"
    );

    @Tool(description = "查询指定科室的门诊时间与剩余号源。当用户询问某科室出诊时间、是否有号时调用。科室取值:内科、外科、皮肤科")
    public String querySchedule(
            @ToolParam(description = "科室名称,如:外科") String department) {
        return SCHEDULES.getOrDefault(department, "该科室暂无排班信息");
    }

    @Tool(description = "为指定宠物挂指定科室的号。只有用户明确表达要挂号、预约时才调用")
    public String makeAppointment(
            @ToolParam(description = "宠物昵称") String petName,
            @ToolParam(description = "科室名称,如:皮肤科") String department) {
        return "已为「" + petName + "」成功挂上「" + department + "」的号,请提前 15 分钟到院。";
    }
}
就这么简单:一个普通 Spring Bean,普通方法,加 @Tool 注解。Spring AI 会自动把方法签名翻译成 JSON Schema 发给模型,把模型回填的 JSON 参数反序列化成方法实参,执行后把返回值转成字符串回传。
? 类比
@Tool之于模型,就像 Javadoc 之于程序员。description就是这份"接口文档"——写得越清楚,模型调用得越准。
description 是 Function Calling 的灵魂,写它有三个经验法则:
| 法则 | ❌ 坏写法 | ✅ 好写法 |
|---|---|---|
| 说清"何时调用" | 查询排班 | 当用户询问某科室出诊时间、是否有号时调用 |
| 给出参数取值域 | 科室参数 | 科室名称,如:内科、外科、皮肤科 |
| 划清边界(防误调) | 挂号 | 只有用户明确表达要挂号、预约时才调用 |
描述写得含糊,模型就会在该调的时候不调、不该调的时候乱调——工具调用不准,九成是 description 的锅,不是模型的锅。
4.2 @ToolParam:给参数也配上说明书
@ToolParam 负责描述单个参数。默认所有参数都是必填的,有个参数可选时必须显式声明:
@Tool(description = "查询天气")
public String getWeather(
        @ToolParam(description = "城市名,如:北京") String city,
        @ToolParam(description = "时间,ISO-8601 格式", required = false) String at) {
    ...
}
这里埋着一个反直觉的坑:如果某参数标记为必填,但对话里又推不出来取值,模型不会停下来问你,而是一本正经地编一个(幻觉的又一种形态)。所以:**能可选的参数尽量标 required = false,让模型学会"留空"而不是"瞎填"**。
4.3 注册工具:.tools() 还是 .defaultTools()?
// 方式一:作为该 ChatClient 的默认工具,构建的所有请求都可用
@Bean
public ChatClient ch@tClient(ChatClient.Builder builder, ClinicTools clinicTools) {
    return builder
            .defaultSystem("你是宠物医院的导诊助手,回答前先调用工具核实真实信息")
            .defaultTools(clinicTools)     // 默认带上
            .build();
}
// 方式二:按次传入,只影响当前这一次请求
String reply = [email protected]()
        .user("帮我看看外科今天有号吗")
        .tools(clinicTools)               // 本次追加
        .call()
        .content();
两条注册规则值得记:
-
.tools()(按次)对.defaultTools()(默认)是并集不是覆盖——按次传入的工具会追加到默认工具集后面; -
高风险工具(下单、删数据、发消息)建议按次传入,由调用方显式决定这次对话"配不配这把刀";只读查询类工具适合设为默认。
4.4 一个接口跑通"查 + 挂"链路
package com.pet.clinic.controller;

import com.pet.clinic.tool.ClinicTools;
import [email protected];
import org.springframework.web.bind.annotation.*;

@RestController
@RequestMapping("/api")
public class AssistantController {

    private final ChatClient ch@tClient;
    private final ClinicTools clinicTools;

    public AssistantController(ChatClient.Builder builder, ClinicTools clinicTools) {
        this.clinicTools = clinicTools;
        this.ch@tClient = builder
                .defaultSystem("你是宠物医院的导诊助手。涉及排班、号源、挂号的问题,必须先调用工具核实,禁止凭记忆编造")
                .build();
    }

    @GetMapping("/assistant")
    public String assistant(@RequestParam String message) {
        return [email protected]()
                .user(message)
                .tools(clinicTools)
                .call()
                .content();
    }
}
4.5 跑起来看效果
curl "http://localhost:8080/api/assistant?message=帮我查一下外科的排班,号源紧张的话顺便给我家猫团团挂个号"
模型返回:
外科的门诊时间是周一/三/五 9:00-12:00,目前号源紧张。已经为您的猫咪「团团」成功挂上了外科的号,请提前 15 分钟到院哦~
这一个请求背后,工具调用循环转了两圈:先 querySchedule("外科") 拿到"号源紧张",模型据此判断需要挂号,又调了 makeAppointment("团团", "外科"),最后才组织出这段回答。想亲眼看这个循环,打开调试日志:
logging:
  level:
    org.springframework.ai: DEBUG
05 拆开引擎盖:2.0 的工具调用循环长在哪
前面我们一直在用 .tools(),但没问过一个问题:第 03 节那张循环图,到底是谁在驱动?
这是 Spring AI 2.0 相对 1.x 的一次重要架构重构,值得专门讲清楚(也是新老版本资料混着看时最容易踩的坑):
| Spring AI 1.0 | Spring AI 2.x | |
|---|---|---|
| 循环所在位置 | 每个 ChatModel 实现内部 | ChatClient 的 Advisor 链中,由 ToolCallingAdvisor 驱动 |
直接调 ChatModel | 工具自动执行 | 工具不会自动执行,必须走 ChatClient |
| 扩展方式 | 改模型实现 | 自定义 ToolCallingAdvisor(暴露循环前后 hook) |
也就是说,当你调用 [email protected]().tools(...).call() 时,请求会流经 Advisor 链上的 ToolCallingAdvisor,它负责整个循环的生命周期:
-
把所有工具定义随请求发给模型;
-
收到响应,若含
tool_calls→ 交给ToolCallingManager执行工具; -
把工具结果追加进对话历史,再次流经 Advisor 链发给模型(它是"递归 advisor",每轮循环重新走一遍链);
-
直到模型返回不含工具调用的纯文本,才把最终结果交还给你。
而循环里真正"动手"的角色是 **ToolCallingManager**,它管三件事:
-
执行:按模型点名的工具名找到对应
ToolCallback,执行并取回结果; -
熔断:内置防失控限流——单工具默认最多 40 次调用、全部工具合计默认 150 次,防止模型陷入"无限挂号"死循环;
-
善后:工具抛出的
RuntimeException默认不炸接口,而是把错误信息回传给模型——模型会道歉并换个思路重试,这就是工具调用的自愈能力。
?类比
ToolCallingAdvisor是项目经理(决定"要不要再派活"),ToolCallingManager是执行团队(真正干活 + 控制加班上限 + 出错了写事故报告)。你写@Tool方法,就是往执行团队里塞了一个"能人"。
06 避坑清单
| # | 坑 | 现象 | 解法 |
|---|---|---|---|
| 1 | description 写成方法名复读 | 模型该调不调 / 乱调 | 写清"何时调用 + 参数取值域 + 边界" |
| 2 | 可选参数没标 required = false | 模型为凑必填项编造参数 | 能可选的都标上,让模型学会留空 |
| 3 | 高危工具设成 defaultTools | 每次对话都"配刀" | 下单/删除类按次 .tools() 传入 |
| 4 | 直接调 ChatModel 期望工具自动执行 | 工具纹丝不动 | 2.0 中循环在 ChatClient 侧,必须走 ChatClient |
| 5 | 工具方法里吞异常返回 "查询失败" | 模型不知错在哪,反复重试 | 抛 RuntimeException 让框架把信息回传模型,触发自愈 |
| 6 | 工具返回超大 JSON | token 暴涨、响应变慢 | 工具内先裁剪字段,只回模型需要的 |
| 7 | 循环日志看不懂 | 不知道转了几圈 | logging.level.org.springframework.ai=DEBUG 逐轮观察 |
07 总结:你已经摸到 Agent 的门槛了
回头看这一路:从 LLM 原理(模型是怎么"思考"的),到 Prompt Engineering(怎么把话说好),到 API 调用 / ChatClient(怎么接上模型),再到今天的 Function Calling(让模型指挥你的代码干活)——你手里的零件已经凑齐了 Agent 的最小闭环:
Agent = LLM(大脑) + Prompt(指令) + Memory(记性) + Tools(手脚)
把它们串起来,就是最简单却完整的 Agent 形态:模型带着记忆,根据你的目标,自主决定调用哪些工具、按什么顺序调用,循环往复直到任务完成。后面不管是 ReAct 推理模式、Multi-Agent 协作,还是 MCP 工具生态,都只是在这个骨架上加肉。
想继续的学习的点个【赞】和【推荐】让主编知道!
顺手点个【关注】,感谢各位学习路上的朋友。