AI智能体开发:结构化输出与流式响应实践
大模型默认擅长生成自然语言,但业务系统往往既需要可校验、可反序列化的 Java 对象,也希望在长回答场景中尽快把内容推送到前端。围绕这两个目标,需要分别处理结构化约束、转换校验,以及 Flux 到 SSE 的流式链路,并明确同步取对象与流式输出之间的边界。
版本:Spring AI 2.0.1
目标:用
entity(...)把模型输出变成 Java 对象;用stream()推出 token,接到 SSE,并旁路拼完整文本落库。
本章分两段:
上半:结构化输出 —— 提示 / 原生约束 → entity → Converter →(可选)校验自纠
下半:流式响应   —— Flux → SSE → 旁路聚合落库
两段只在一个地方相交:没有 stream().entity(...)。要对象,用同步 call().entity(...);要打字机效果,先流式推 UI,结束后再对完整文本做转换。
12.1 为什么要结构化输出
模型默认返回自然语言。业务代码通常要的是对象:
{ "city": "杭州", "tempC": 26, "condition": "晴" }
不是「今天杭州大约二十六度,天气晴朗」。用正则从散文里抠字段,一改提示就容易坏。
稳定拿到对象,实际就三步:
-
告诉模型格式(Schema、示例,或 JSON mode)
-
把返回字符串转成 Java 类型
-
校验失败时,把错误信息喂回去再试
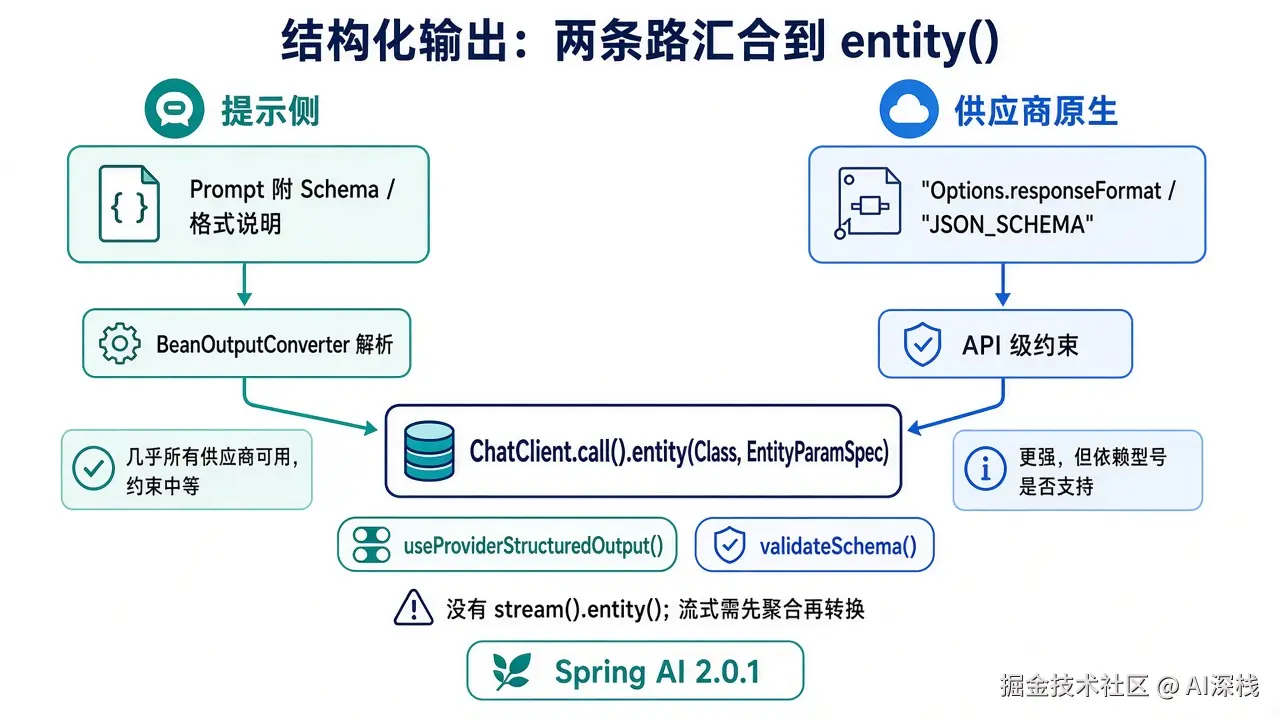
上图左路是「Prompt 里写格式 + Converter 解析」,右路是「供应商 API 级 ResponseFormat」。两条路最后都进 ChatClient.call().entity(...)。流式没有对等的 entity(),图底也写了这一点。
12.2 两条技术路线
| 提示侧 | 供应商原生 | |
|---|---|---|
| 做法 | Prompt 附 Schema / 格式说明,再用 Converter 解析 | Options 上挂 response_format / JSON_SCHEMA |
| 约束强度 | 中等 | 更强,但取决于型号是否真支持 |
| 适用 | 跨供应商、Ollama、兼容网关能力不明时 | OpenAI 等明确支持 structured 的路径 |
Spring AI 2.0 用 EntityParamSpec 组合这两条:默认走提示侧;需要时再开 useProviderStructuredOutput()。
选型可以直接按场景记:
跨供应商 / 本地模型     → 提示侧 + Converter,必要时 validateSchema()
OpenAI 且字段必须很严   → 开原生 structured,并叠加校验
只要合法 JSON、字段靠提示 → entity(Class) 或 JSON_OBJECT 通常够用
OpenAI 系常见两种格式:
-
JSON_OBJECT:保证是 JSON 对象,不保证字段符合你的 Schema
-
JSON_SCHEMA:按 Schema 约束;顶层 array 等边界见 12.8
2.0.1 起 OpenAI strict 默认偏 false。strict=true 时,可选字段、复杂 schema 更容易收到 HTTP 400;真要严格再显式打开。
12.3 entity(...):从响应取出对象
record WeatherReport(String city, int tempC, String condition) {}
WeatherReport report = [email protected]()
.user("用 JSON 描述杭州今天的天气:城市、摄氏温度、天气概况")
.call()
.entity(WeatherReport.class);
常用重载:
| 方法 | 用途 |
|---|---|
entity(Class, Consumer<EntityParamSpec>) | 推荐;可开原生 structured / 校验 |
entity(ParameterizedTypeReference) | 泛型集合等 |
entity(StructuredOutputConverter) | 自定义 Converter |
responseEntity(...) | 同时要 ChatResponse 元数据 |
stream() 路径没有 entity(...)。流式要对象,见 12.12。
12.4 EntityParamSpec:两个独立开关
record Answer(String summary, List<String> bullets) {}
Answer a = [email protected]()
.user("总结 Spring AI ChatClient")
.call()
.entity(Answer.class, spec -> spec
.useProviderStructuredOutput()
.validateSchema());
| 开关 | 作用 |
|---|---|
useProviderStructuredOutput() | 把 JSON Schema 下发到供应商 API;不支持时静默回退到提示侧 |
validateSchema() | 校验返回 JSON,失败则带错误重试(默认最多 3 次);由 StructuredOutputValidationAdvisor 驱动;不支持 streaming |
调用顺序可以记成:
entity(Class, spec)
  →(可选)原生 schema 约束
  →(可选)校验 Advisor 自纠
  → 调模型
  → Converter.convert(text) → T
三个常见坑:
-
reasoning / thinking 型号可能仍返回纯文本,反序列化直接失败
-
OpenAI Structured Outputs 通常不接受顶层 JSON 数组;
List<T>要包一层容器 record -
「原生 structured 没生效」经常是静默回退——生产建议叠
validateSchema()
不想每次写 Spec,也可以用 Advisor 参数全局打开原生 structured;与 per-call 开关二选一,不要两套都开还互相打架。
12.5 Converter:文本到 Java
entity(...) 背后是 StructuredOutputConverter。
| Converter | 做什么 |
|---|---|
BeanOutputConverter | JSON → POJO / record;getFormat() 可生成提示侧格式说明 |
MapOutputConverter | 半固定结构;下游自己检查键是否存在 |
ListOutputConverter | 列表;供应商不支持顶层 array 时改用包装类型 |
record WeatherList(List<WeatherReport> items) {}
自定义 Converter 通常只做两件事:告诉模型怎么写、把文本变成 T。适合 XML、CSV 或领域 DSL。Markdown 代码围栏可以在转换前剥掉。
12.6 校验自纠与提示写法
打开 validateSchema() 时,框架会挂上 StructuredOutputValidationAdvisor。也可以显式注册自定义版本(改重试次数、JsonMapper、预置 schema);显式注册会替换自动那一份。
… → StructuredOutputValidationAdvisor → … → ChatModel
         ↑ 校验失败:追加纠错消息,再次 call
即使开了 JSON mode,提示里仍建议写清:
-
只输出 JSON,不要 Markdown 围栏
-
字段、类型、枚举取值
-
缺失字段怎么处理(null / 省略 / 默认值)
-
必要时给一个短示例
BeanOutputConverter.getFormat() 生成的说明可以直接拼进 Prompt,少手写 Schema。
三种写法对比:
// A. 最简
MyDto a = [email protected]()
.user(q)
.call()
.entity(MyDto.class);
// B. Options 挂 ResponseFormat
MyDto b = [email protected]()
.user(q)
.options(OpenAiChatOptions.builder()
.responseFormat(new ResponseFormat(ResponseFormat.Type.JSON_OBJECT))
.build())
.call()
.entity(MyDto.class);
// C. Spec 统一开关(推荐)
MyDto c = [email protected]()
.user(q)
.call()
.entity(MyDto.class, spec -> spec
.useProviderStructuredOutput()
.validateSchema());
日常优先 C;供应商特有微调再叠 B。
12.7 嵌套对象与 Tool
嵌套可以直接映射到 record:
record OrderLine(String sku, int qty) {}
record Order(String orderId, List<OrderLine> lines, BigDecimal total) {}
Order order = [email protected]()
.user(rawOrderText)
.call()
.entity(Order.class, spec -> spec.validateSchema());
BigDecimal、日期等要在提示里约定格式。嵌套过深可以拆成两阶段抽取。泛型列表用 ParameterizedTypeReference;顶层 array 不行就包一层。
和 Tool 一起用时:
| 场景 | 做法 |
|---|---|
| 工具返回值给模型 | 短 JSON 字符串即可 |
| 最终答案要 DTO | 工具循环结束后,对最终助手文本做 entity |
returnDirect=true | 在应用层自己解析工具结果,不要再指望外层 entity 自动包一层 |
12.8 供应商常见坑
| 场景 | 注意 |
|---|---|
| OpenAI / 兼容网关 | strict=true + 可选字段易 400;顶层 array 要包一层;网关未必真支持 json_schema,用校验兜底;代码围栏在提示里禁止,或 Converter 里 strip |
| Azure / Foundry | 跟部署模型能力走,不跟 Spring 模块名走 |
| Anthropic / Google / Mistral | 原生 structured 随型号变;不支持就退回提示侧 + 校验。Google 上 ToolChoice 与纯 JSON 目标冲突时,拆成两步调用 |
| Ollama | reasoning 型号易吐纯文本;format: json 只保证 JSON,不保证字段 |
通用再记三条:原生 structured「没生效」先怀疑静默回退;自纠会多耗 token,要限制次数并修 schema;finishReason=length 多半是 JSON 被截断。
12.9 为什么要流式
非流式等整段答完才返回,首字延迟高。流式按 token / chunk 边到边推,长回答体验更接近「打字机」。
Spring AI 用 Reactor Flux 表示流,可以接到 WebFlux、MVC 的 SSE,或自己的消息通道。
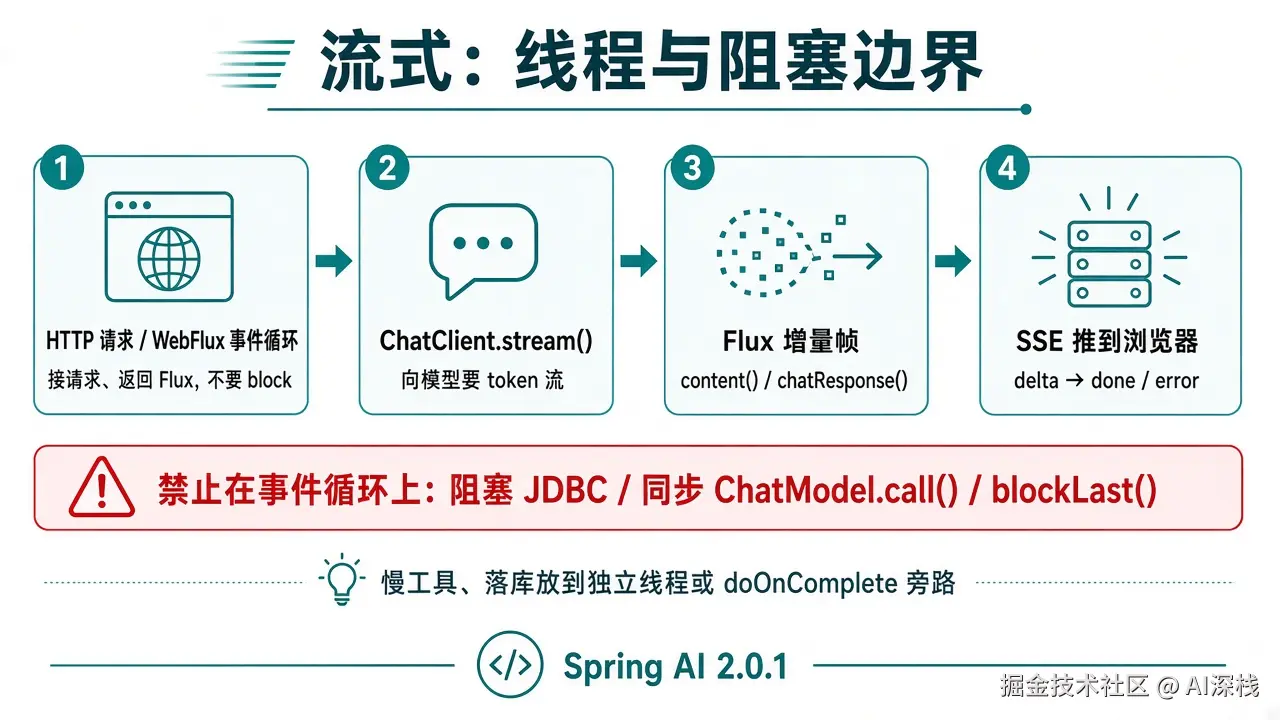
上图四步:接请求 → ChatClient.stream() → Flux 增量帧 → SSE 推浏览器。 红框是硬约束:事件循环上不要跑阻塞 JDBC、同步 ChatModel.call()、或对长流 blockLast()。慢工具和落库放到独立线程,或用 doOnComplete 旁路。
12.10 流式 API
ChatModel:
Flux<ChatResponse> stream = [email protected](
        new Prompt(List.of(new UserMessage("讲一个短故事"))));
ChatClient:
Flux<String> tokens = [email protected]()
        .user("讲一个短故事")
        .stream()
        .content();
三个出口:
| 方法 | 拿到什么 | 何时用 |
|---|---|---|
content() | 文本增量 | 多数聊天 UI |
ch@tResponse() | ChatResponse(finishReason、metadata、tool) | 要看结束原因 / 工具结构 |
ch@tClientResponse() | 还含 Advisor 上下文 | 调试 Advisor 链 |
实现可能推 delta(增量)或 snapshot(全文快照)。接入前先看前几帧:
[email protected]().user(q).stream().content()
        .take(5)
        .doOnNext(frame -> log.debug("frame={}", frame))
        .subscribe();
是 snapshot 时,前端应「替换」整段,而不是「追加」。
12.11 接到浏览器:SSE
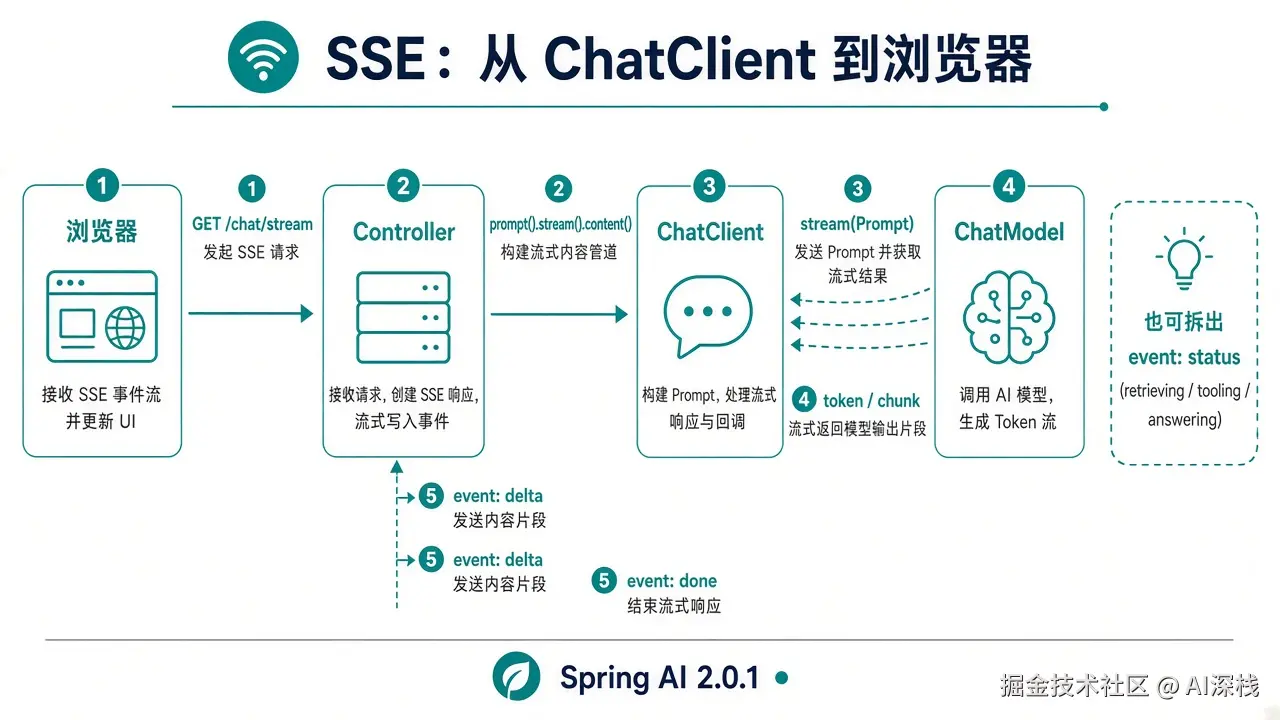
浏览器 GET /ch@t/stream → Controller 组 prompt().stream().content() → ChatModel 吐 token → 以 event: delta 推回,最后 done。需要时再加 status(retrieving / tooling / answering)。
WebFlux
@GetMapping(path = "/ch@t/stream", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public Flux<ServerSentEvent<String>> stream(
@RequestParam String q,
@RequestParam String conversationId) {
return [email protected]()
.user(q)
.advisors(a -> a.param(
ChatMemory.CONVERSATION_ID, conversationId))
.stream()
.content()
.map(token -> ServerSentEvent.<String>builder()
.event("delta")
.data(token)
.build())
.concatWithValues(ServerSentEvent.<String>builder()
.event("done")
.data("[DONE]")
.build())
.onErrorResume(ex -> Flux.just(ServerSentEvent.<String>builder()
.event("error")
.data(ex.getMessage())
.build()));
}
MVC(SseEmitter)
@GetMapping("/ch@t/stream-mvc")
public SseEmitter streamMvc(@RequestParam String q) {
    SseEmitter emitter = new SseEmitter(120_000L);
    Disposable disposable = [email protected]()
            .user(q)
            .stream()
            .content()
            .subscribe(
                    token -> {
                        try {
                            emitter.send(SseEmitter.event()
                                    .name("delta")
                                    .data(token));
                        } catch (IOException e) {
                            emitter.completeWithError(e);
                        }
                    },
                    emitter::completeWithError,
                    emitter::complete);
    emitter.onCompletion(disposable::dispose);
    emitter.onTimeout(disposable::dispose);
    return emitter;
}
长思考、长 tool 时加心跳(event: ping),避免网关把空闲连接掐掉。
事件建议分流:
event: meta
event: status   (retrieving / tooling / answering)
event: delta
event: done / error
12.12 旁路聚合落库(以及流式后再转对象)
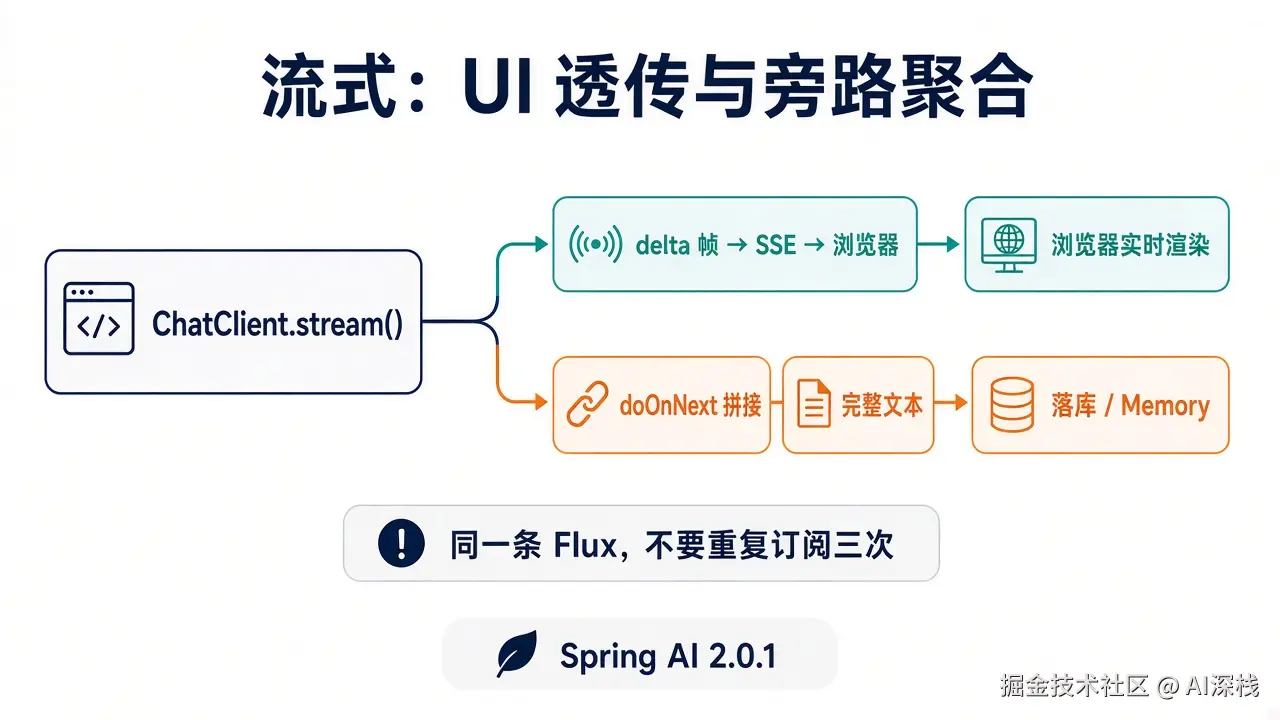
同一条流做两件事:上面透传给浏览器,下面用 doOnNext 拼完整文本再落库。同一条 Flux 不要重复订阅,否则会重复打模型。
StringBuilder full = new StringBuilder();
Flux<String> ui = [email protected]()
.user(q)
.stream()
.content()
.doOnNext(full::append)
.doOnComplete(() -> messageRepository.saveAssistant(
conversationId, full.toString()));
return ui; // 控制器再包成 SSE
原则:
-
UI 走透传帧,保首字延迟
-
落库走聚合结果
-
一条流、一次订阅;旁路用
doOnNext/doOnComplete,不要再subscribe第二次
也可用 MessageAggregator 旁路得到完整 ChatResponse,再取 Usage / finishReason。
流式结束后要 DTO,对聚合文本做 Converter,或另开一次同步 call().entity(...):
String json = [email protected]()
.user(q)
.stream()
.content()
.collect(Collectors.joining())
.block();
MyDto dto = new BeanOutputConverter<>(MyDto.class).convert(json);
block() 只适合测试、批处理,或明确不在 WebFlux 事件循环上的代码路径。控制器若已经返回 Flux,不要在里面再 block()。
带 Tool 时,工具参数 JSON 常拆在多个 chunk 里,拼齐前不能执行,前端会感觉「停顿」。应推 status=tooling;多数产品只展示最终轮文本。不要指望流式中途跑 validateSchema()。
12.13 取消、超时与网关
客户端断开要取消订阅:
return [email protected]().user(q).stream().content()
        .doOnCancel(() -> log.info(
                "client cancelled, conversationId={}", conversationId))
        .timeout(Duration.ofMinutes(2));
半截答案要不要写入记忆,由产品定:多数不写,或标 partial=true。
经 Nginx / API Gateway 时,对该 path 关闭响应缓冲、调大空闲超时,必要时关闭 gzip,否则前端会「等一整包」。
12.14 流式与 Advisor 顺序
常见顺序:
SafeGuard → Memory(读) → RAG(检索) → ToolCalling → ChatModelStream → Memory(写)
检索多半发生在首 token 之前;Memory 写回宜在流成功结束后。Usage 常在最终帧才完整;带 tool 时 Usage 多为累计值。
12.15 小结
| 主题 | 记住这些 |
|---|---|
| 结构化 | 提示侧 vs 供应商原生;entity + EntityParamSpec;Converter 做转换;validateSchema 不支持 streaming |
| 流式 | Flux → SSE;旁路聚合落库;事件循环上不阻塞 |
| 交界 | 没有 stream().entity(...);UI 流式,对象化走聚合后转换或同步 call() |