用蓝耘元生代搭建本地图库语义搜索:一句话定位目标图片
照片积累到一定规模后,按月份建目录或依赖文件名已经很难快速定位目标图片。要让“傍晚的海边,要有山”这样的自然语言真正对应到画面内容,需要在本地文件处理与模型语义理解之间划清边界。接下来将从链路分层、模型接入、标签生成、条件解析和降级检索几方面还原这套图库搜索方案。
本地图库的麻烦不在存,在找,文件名大多是 IMG_2043 这种,目录按月份分,真要找"那张傍晚拍的、有山有海的"就得一张张翻过去。我为一个封面图翻过十几分钟,挑出来的还是张凑合的。
这次要做的事情很具体,一个跑在本机的图片库,索引一遍之后,输入一句人话就能把目标图搜出来。要找的是画面内容而不是文件名,这一条决定了链路上必须有模型参与,因为画面里的语义本地写不出来。
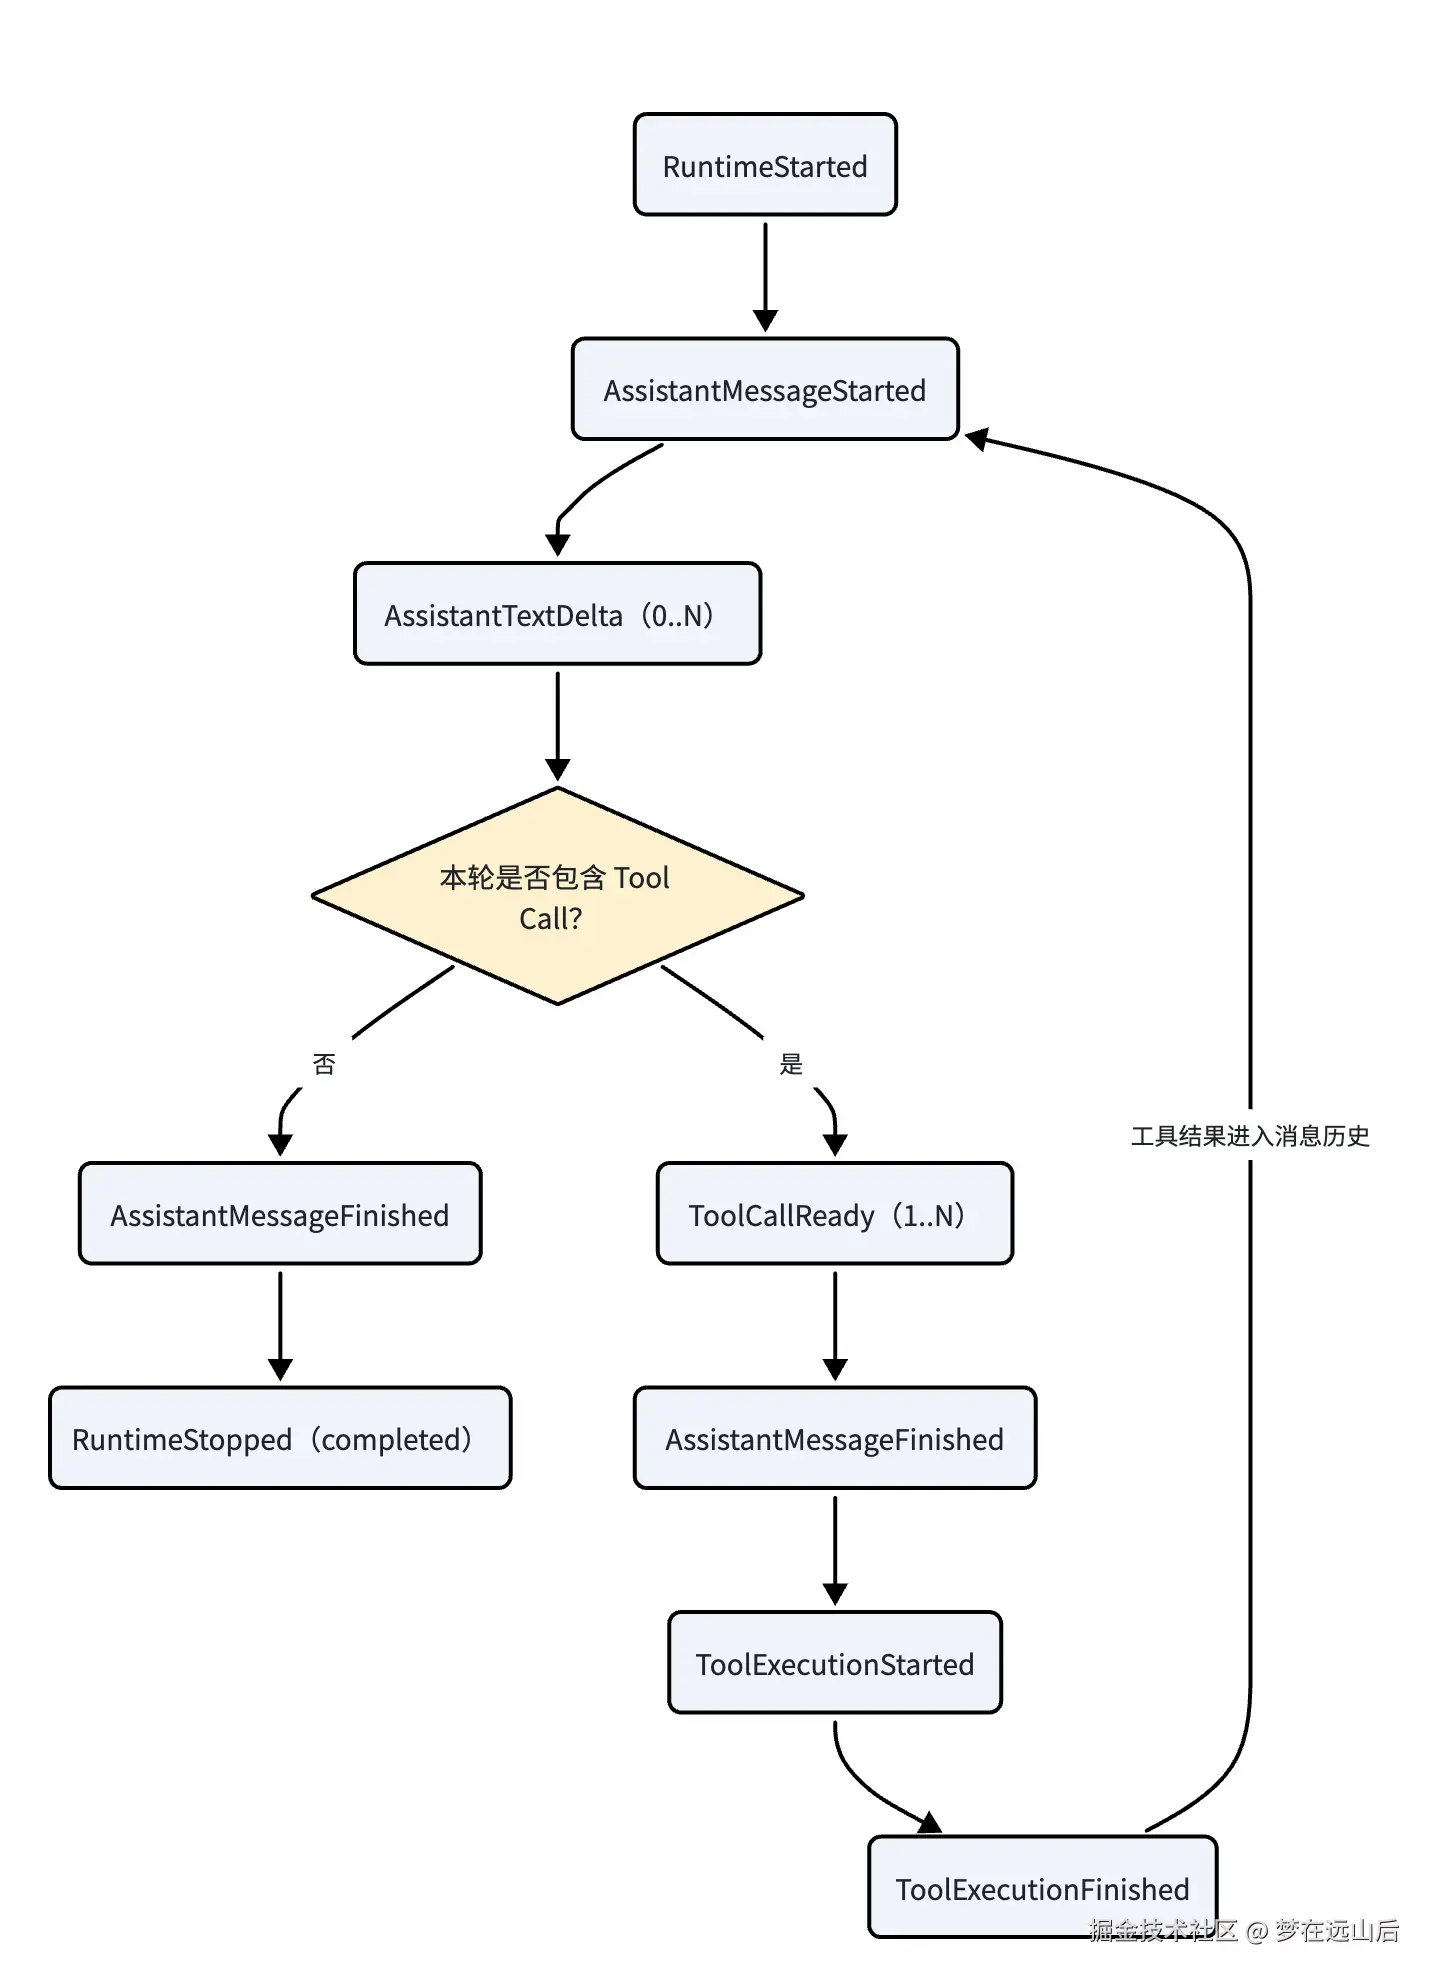
不过模型在这条链路里只占两层,其余全在本地,这个分层直接决定了每一段代码该写在哪里。下面按工程顺序讲四件事:链路怎么分层,模型怎么接进来,跑出来的数字是多少,以及哪些地方到现在还不好用。
一、先把链路分层,再谈接什么模型
| 环节 | 放在哪 | 为什么 |
|---|---|---|
| 目录遍历、内容哈希去重 | 本地 | 纯文件 IO,模型看不见文件系统 |
| 长边压缩、生成缩略图 | 本地 | 图片输入 token 与像素面积大致成正比,这一步决定发给模型的输入规模 |
| 看图产出描述与标签 | 视觉模型 | 画面里有什么,本地规则写不出来 |
| 标签落库、建索引 | 本地 | 结构化数据自己存,检索才精确 |
| 搜索词拆成检索条件 | 文本模型 | "傍晚""那种"这类说法,本地规则拆不出来 |
| 匹配、打分、排序 | 本地 | 已有结构化数据,精确匹配比让模型回忆可靠 |
这张表里没有一行是为了省事,每一行都对应一个判断:能精确算出来的就不交给模型,必须理解语义的才发出去。遍历和哈希交给模型没有任何意义,它看不见文件系统,反过来让本地规则去猜"傍晚"指的是什么色调,猜十次能错九次。
所以一件事该落在哪一层,看的是它能不能用规则写清楚,而不是哪个做法听起来更先进。
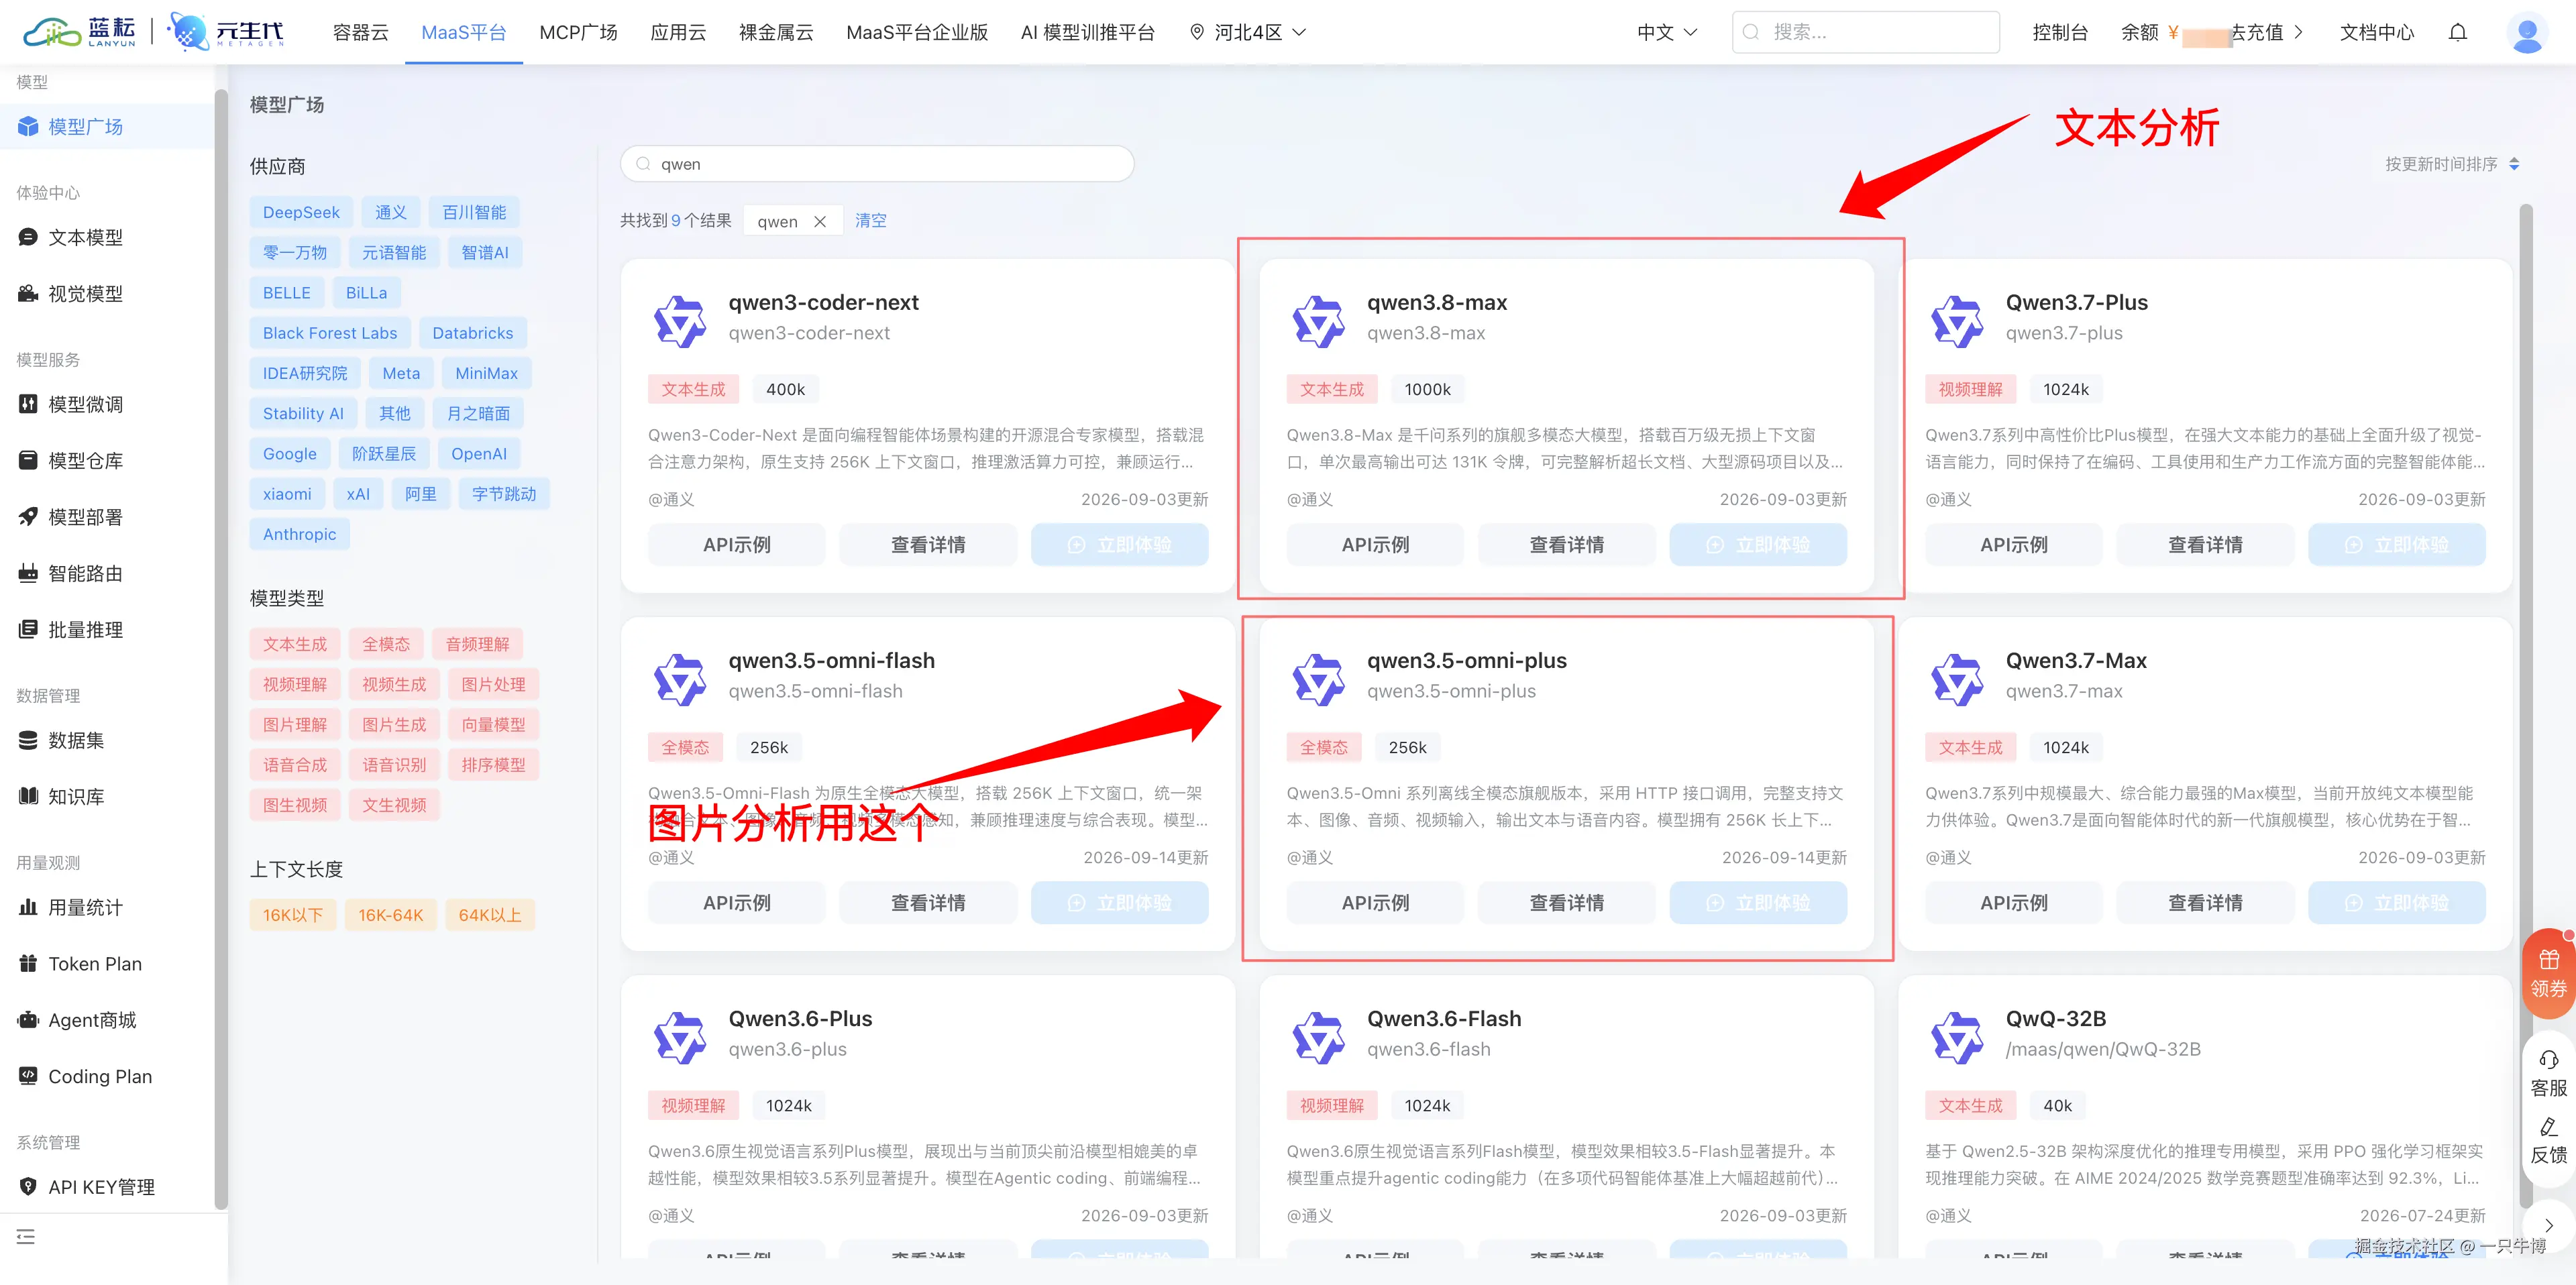
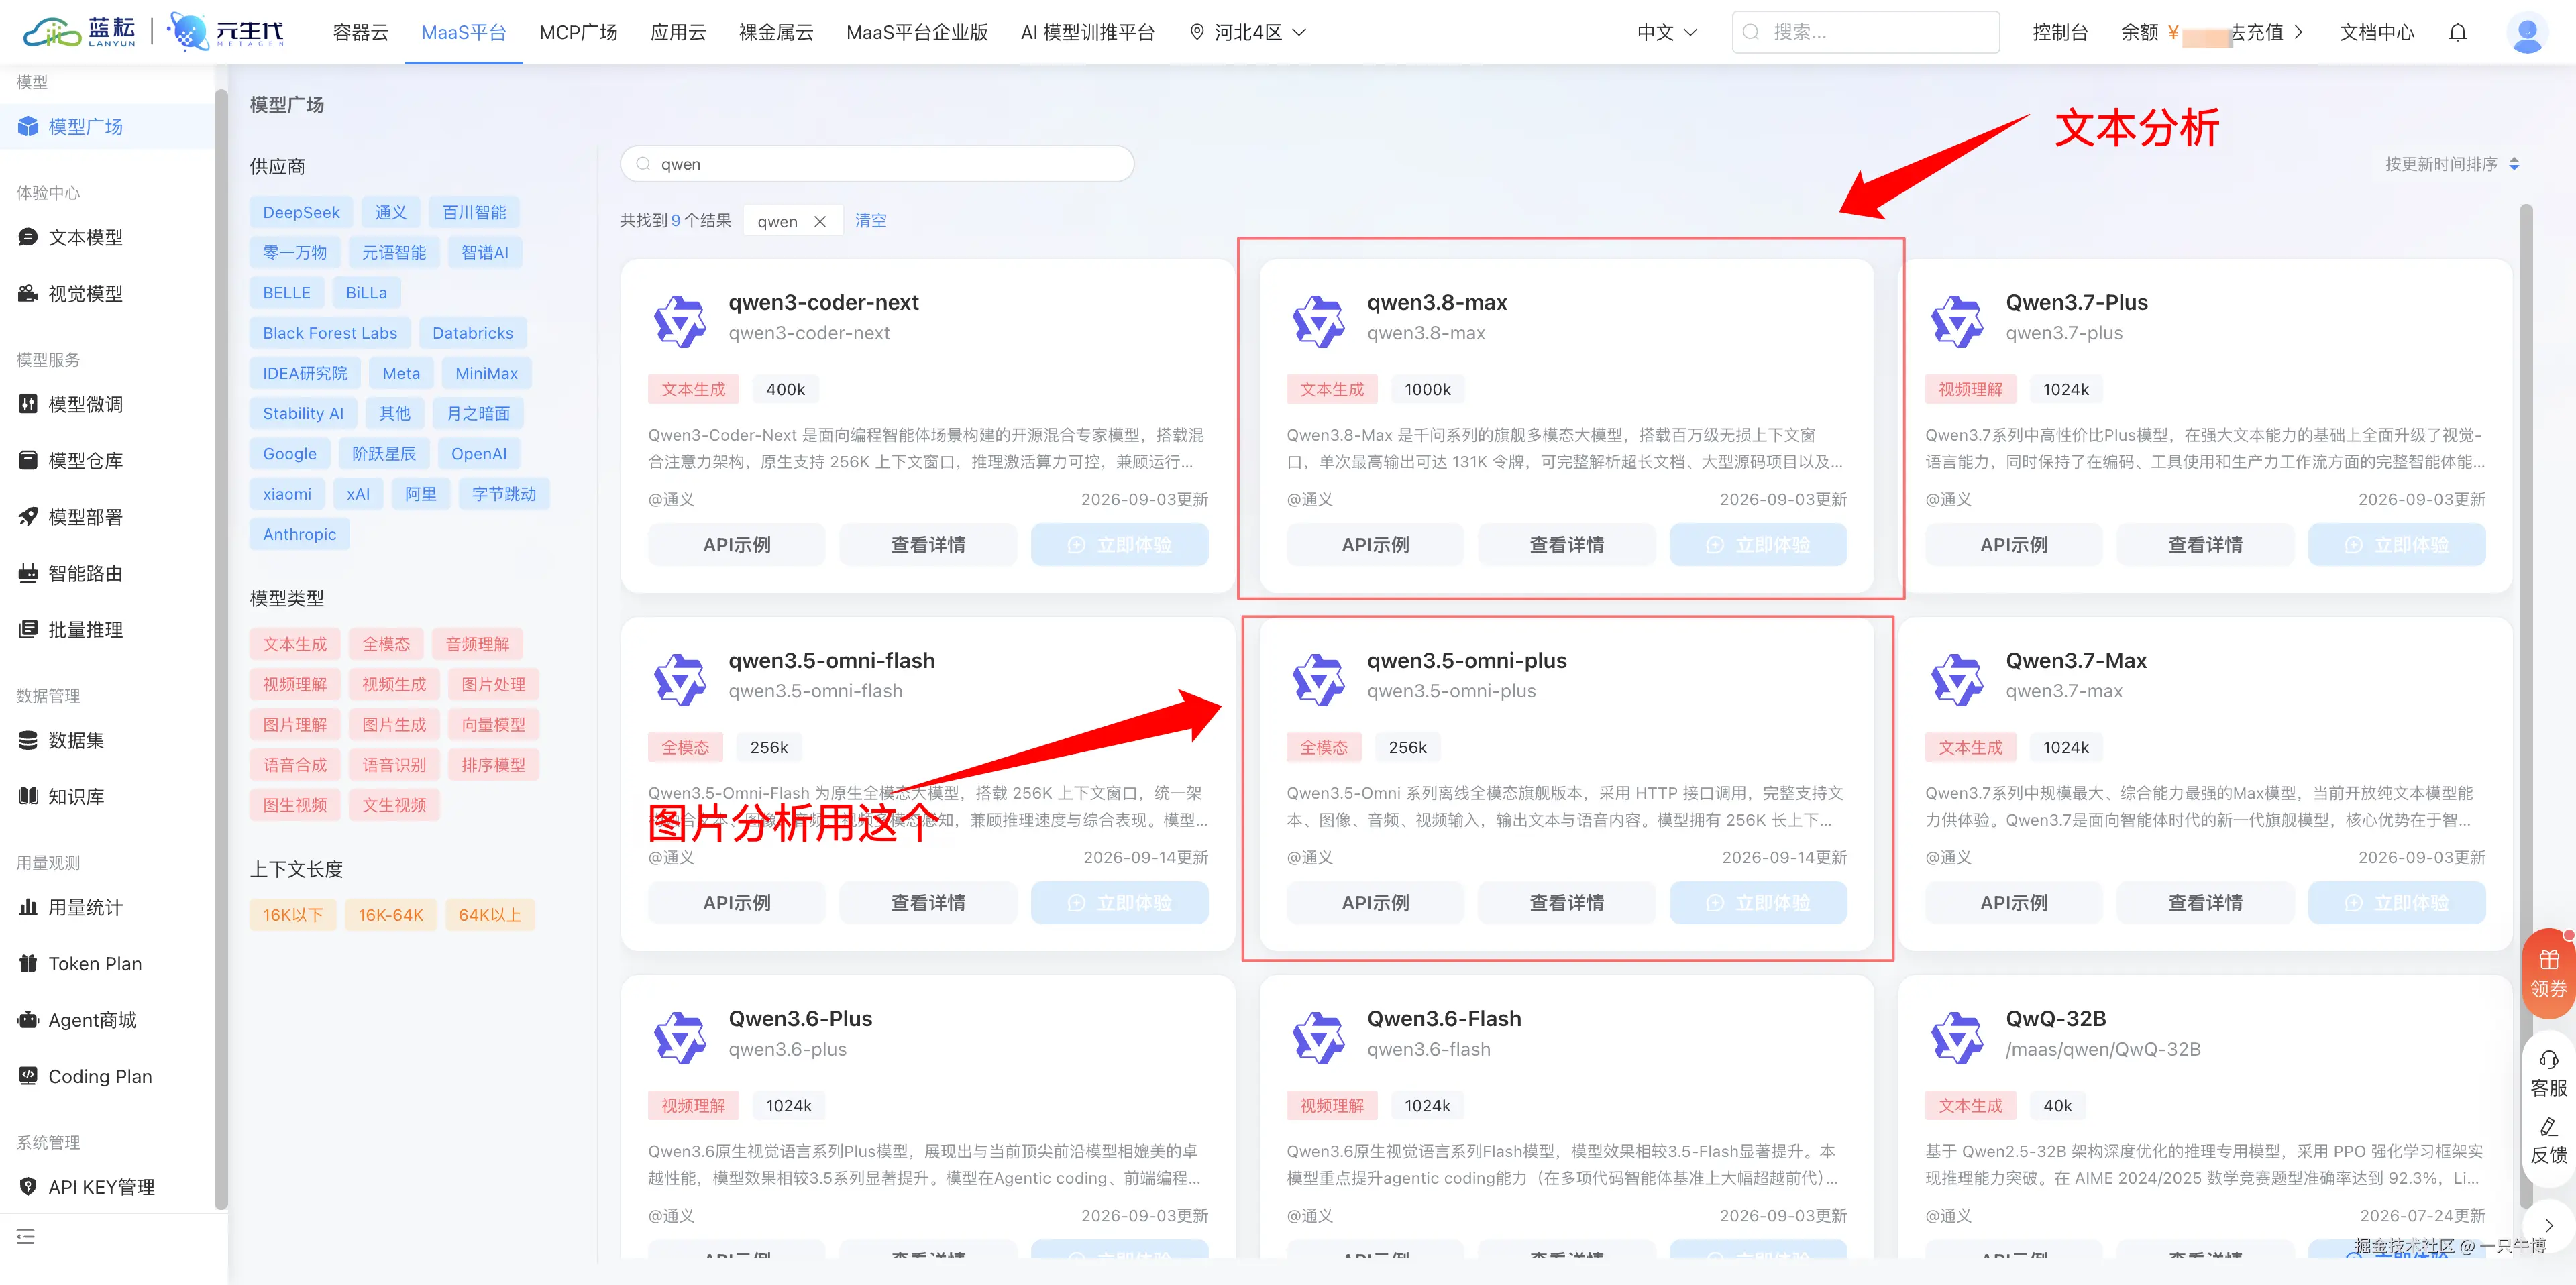
模型的这两层都落在蓝耘元生代上(maas.lanyun.net/),直接原因是它们需要的模型根本不是一类,看图要多模态,拆句子要文本模型。蓝耘元生代这边一份凭证、一个接口地址就能把两类模型都调起来,我不用为视觉和文本各维护一套鉴权、各记一本账、各轮换一次密钥。
二、接入这一步,动的只有三个值
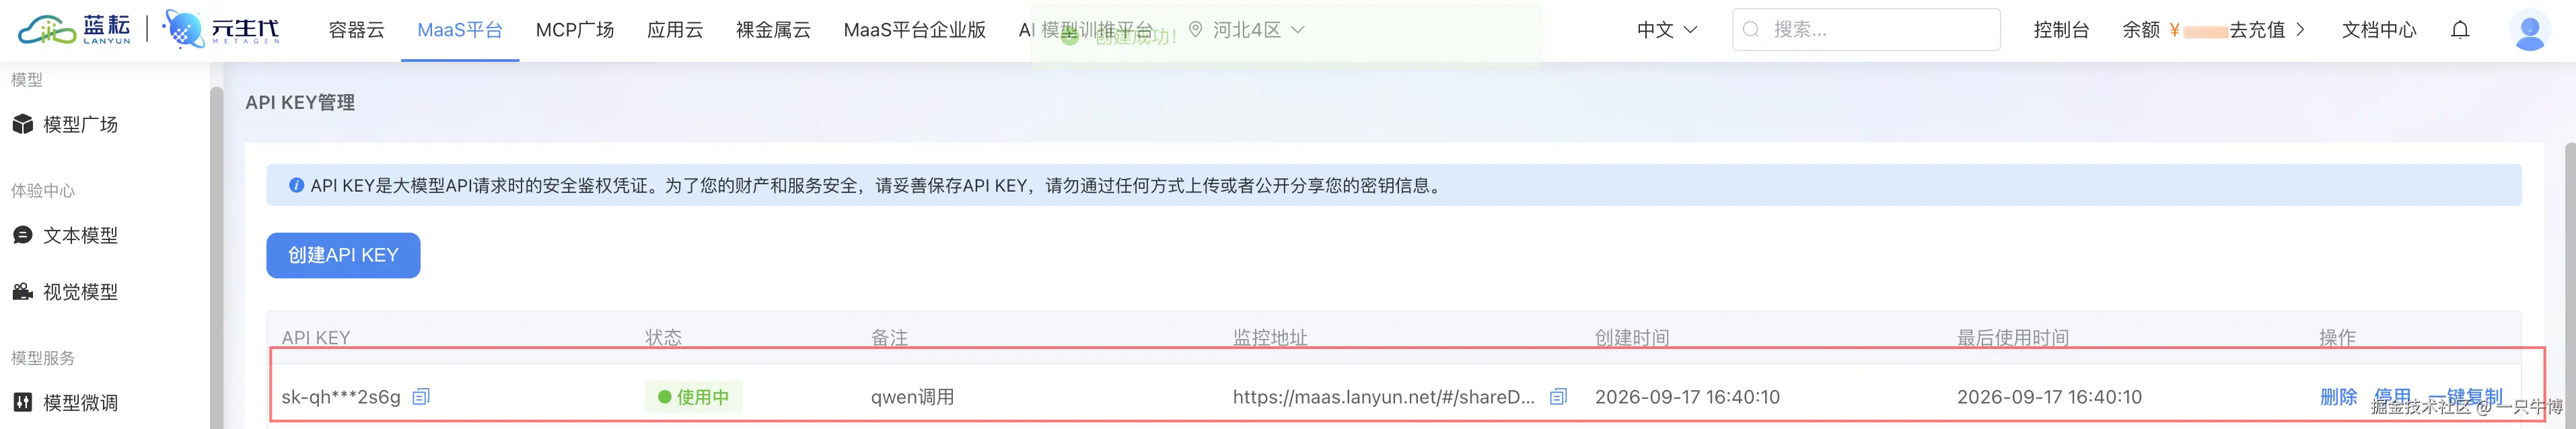
在蓝耘元生代控制台建一个 Key,把地址和 Key 写进配置,剩下要选的就是两个模型名。整个 config.py 里和接入相关的部分只有这几行,多一行都没有:
self.api_key = os.getenv("LANYUN_API_KEY", "").strip()
self.base_url = (
    os.getenv("LANYUN_BASE_URL", "").strip()
    or "https://maas-api.lanyun.net/v1"
)
# 视觉模型负责看图产出语义,文本模型负责理解搜索词
self.vision_model = os.getenv("VISION_MODEL", "").strip() or "qwen3.5-omni-plus"
self.text_model = os.getenv("TEXT_MODEL", "").strip() or "qwen3.8-max"
接口走的是 OpenAI 兼容协议,所以客户端那一层直接用现成的库就够,_client() 里只填三样东西,Key、地址、超时。调用时不区分类别,两个模型在代码里唯一的区别就是 model 传的是哪一个,将来想把文本那层换成别的模型,改的是配置里的一行字符串。
改配置不用动调用点的代码,也不用重新读一遍协议文档。凭证只从环境变量读,仓库里留一份 .env.example。加载那一段做了一件小事,已经存在的系统环境变量不覆盖,所以容器或者进程管理器注入的配置优先级更高。
三、第一层:让模型看懂画面
要发给模型的是压缩之后的图,不是原图,图片输入的 token 量和像素面积大致成正比。在本地先压一次,是整条链路上投入产出比最明显的一步,压完再传,传的东西小了,模型要看的像素也少了。
压缩和缩略图是同一个动作,顺手把界面要用的预览图也一起生成了。发出去的消息结构不复杂,一段提示词加一张图,图以 base64 塞进 image_url。这一层用到的是蓝耘元生代上的多模态模型,配置里对应 vision_model 这一项:
messages = [{    "role": "user",    "content": [        {"type": "text", "text": prompt},        {"type": "image_url",         "image_url": {"url": f"data:image/jpeg;base64,{b64}"}},    ],
}]
return _call(model or settings.vision_model, messages, temperature)
提示词那一段我改了三次才稳定下来,现在有三条硬约束,第一条是只描述画面里确实存在的东西,禁止推测人物身份、拍摄地点和图片用途。模型很擅长补全它"觉得应该有"的信息,一旦补了,检索的时候就会把不存在的图捞出来。
第二条是标签数量给在 8 到 15 个这个区间,太少检索命中率低,太多会互相稀释。第三条是输出严格 JSON,summary 写一句话,tags 里每个标签带一个类别,类别只允许取物体、场景、颜色、文字、风格这几个值。
约束归约束,模型仍然可能在这段 JSON 前后补一句解释,所以代码侧还要兜一层,从返回文本里截第一个 { 到最后一个 } 再解析:
def _parse(raw: str) -> Optional[Dict]:
    """从返回文本里截出 JSON。模型偶尔会在前后补一句话。"""
    if not raw:
        return None
    start, end = raw.find("{"), raw.rfind("}")
    if start == -1 or end == -1 or end <= start:
        return None
    try:
        data = json.loads(raw[start:end + 1])
    except json.JSONDecodeError:
        return None
    return data if isinstance(data, dict) else None
解析不出来就按调用失败处理并记下原因,不硬编一个结果出来,因为编出来的标签会把错误固定进索引里,后面每一次检索都在用错的词。这一层跑下来一次都没触发过,但它是那种一旦需要就必须存在的东西。
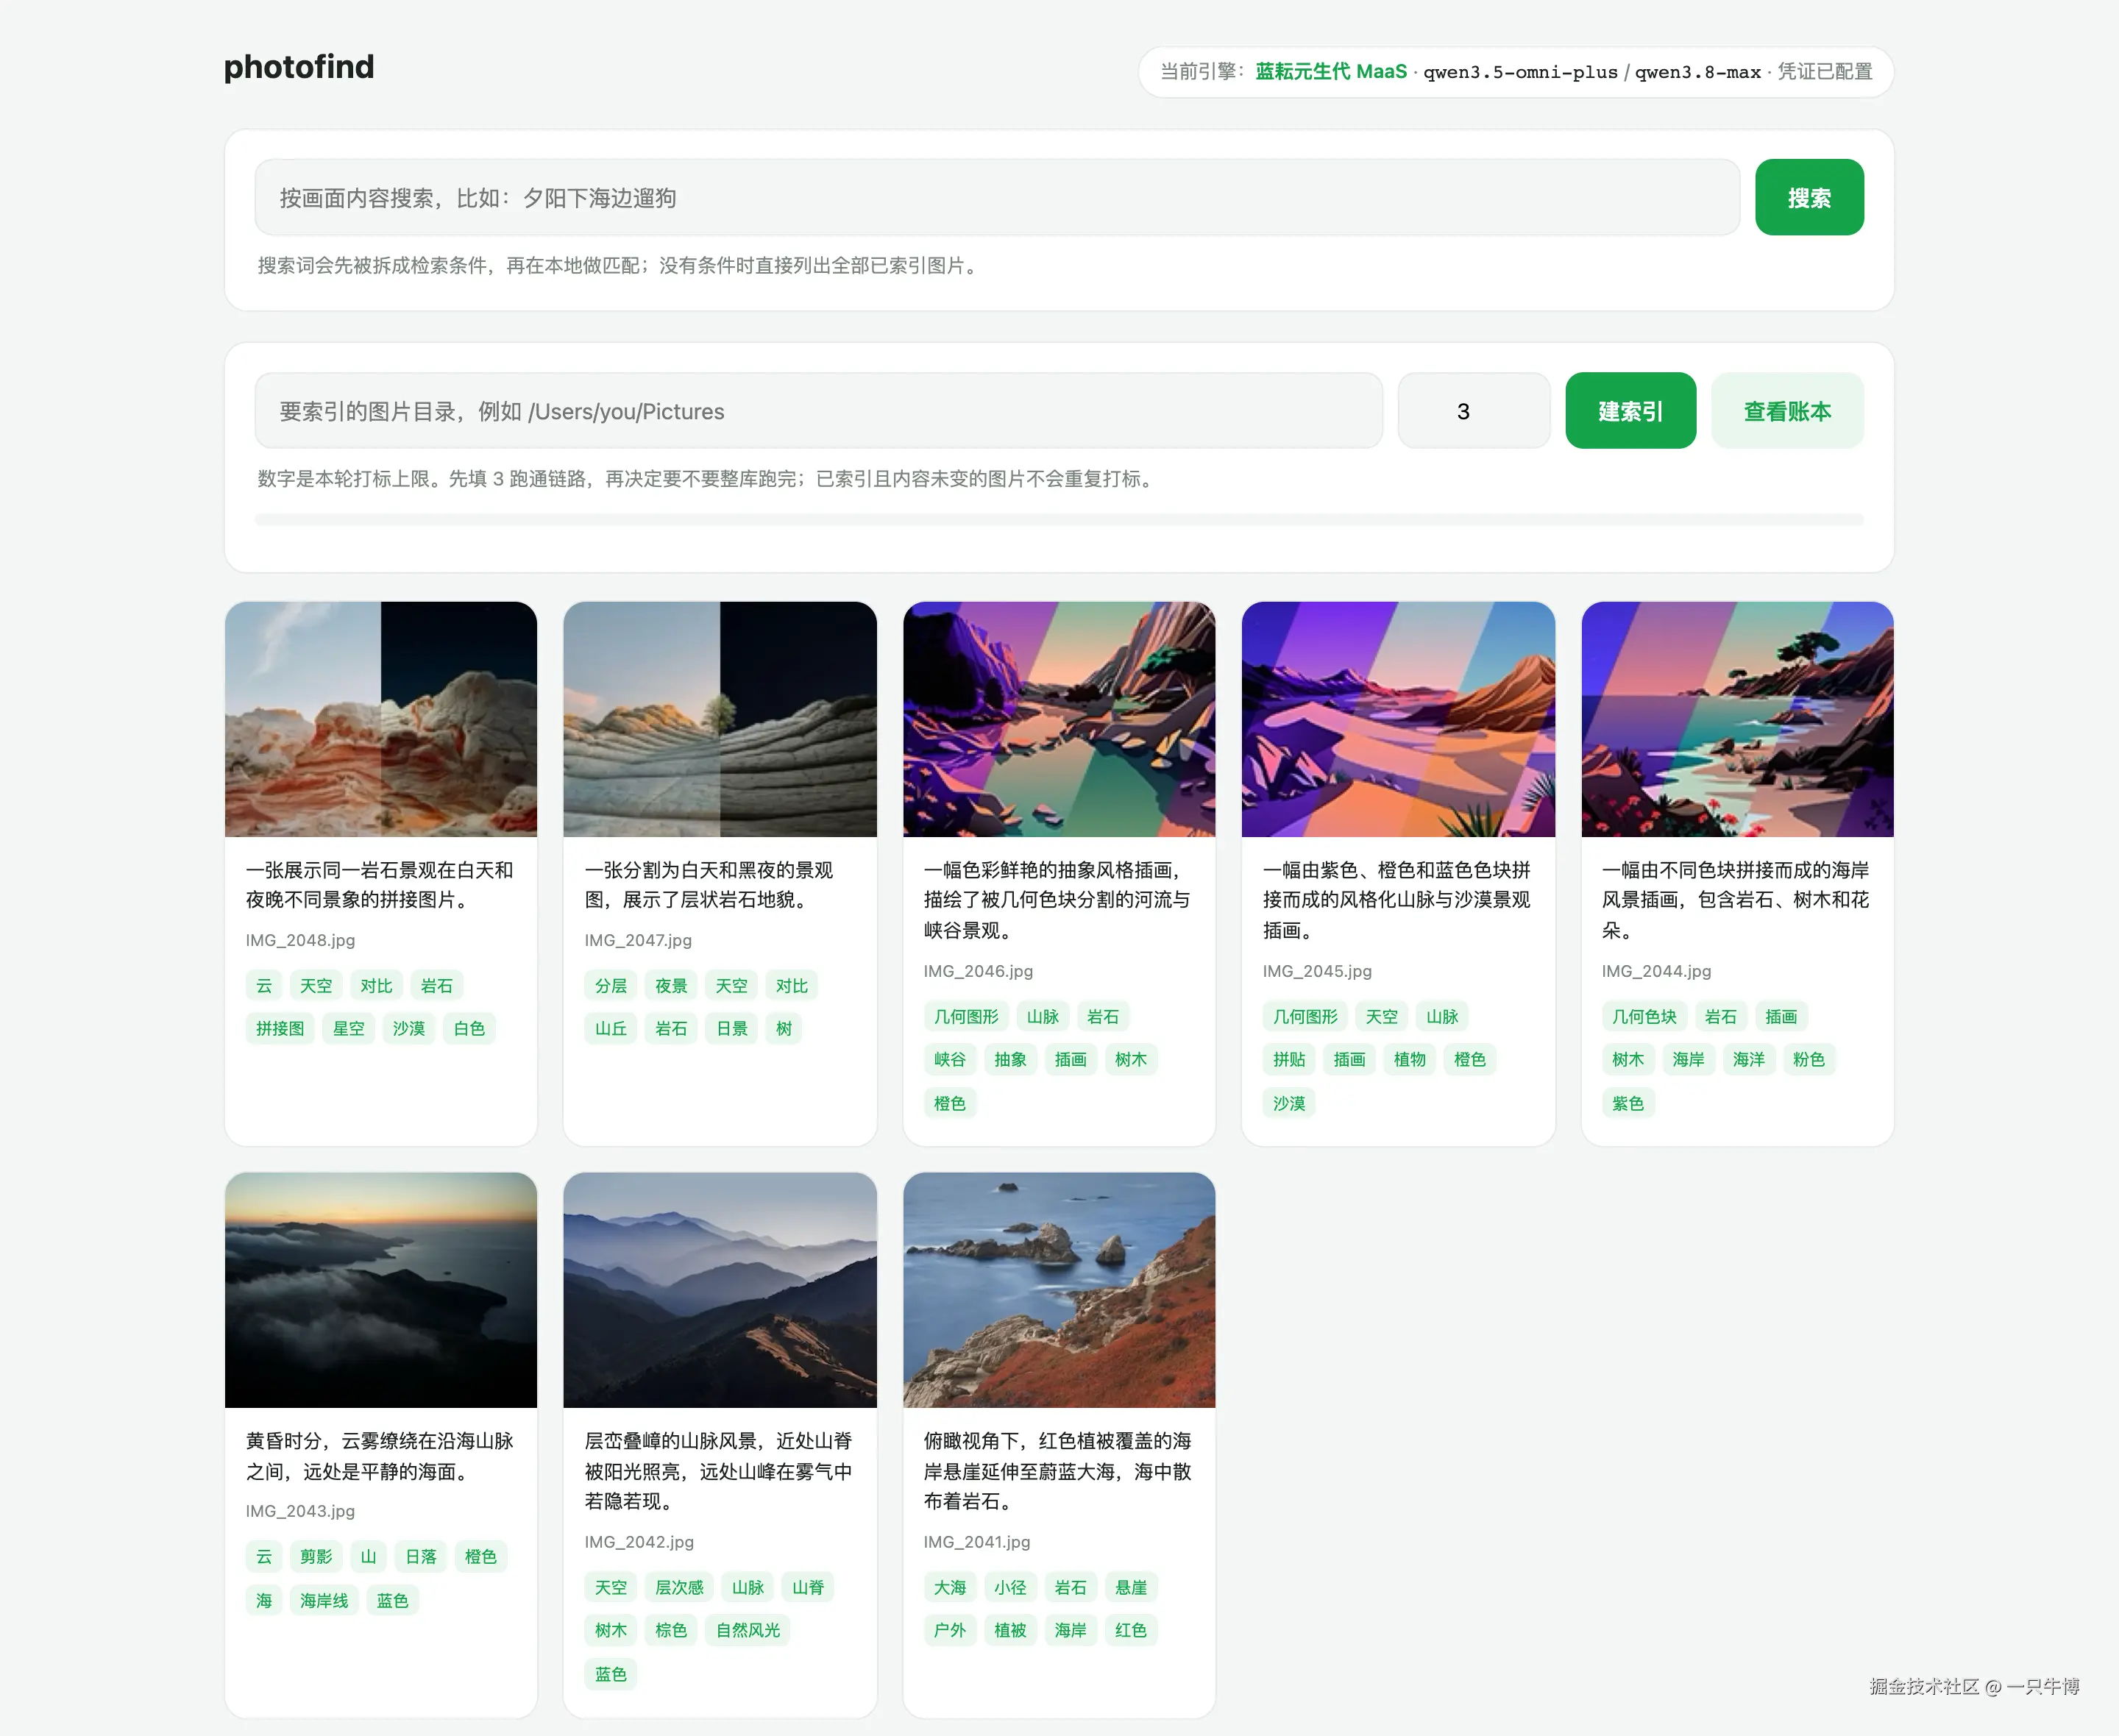
八张图一轮跑完的数字是这样的,单张输入 token 在 618 到 834 之间,取决于长宽比,输出在 189 到 317 之间,单张耗时 3.0 到 4.1 秒。一轮合计 5592 输入、2071 输出、28.9 秒,失败 0 张。
这一层的耗时基本由输出量决定,写长描述的那几张明显更慢,输入那边因为压过图,方差反而不大。识别质量比预期好。有一张海岸悬崖的图,模型的描述是"俯瞰视角下,红色植被覆盖的海岸悬崖延伸至蔚蓝大海,海中散布着岩石",标签给了大海、小径、岩石、悬崖、植被、户外、海岸、红色。
另一张是同一处景观在白天和夜晚各半的拼接图,描述写的是"一张展示同一岩石景观在白天和夜晚不同景象的拼接图片"。标签里出现了拼接图、星空、沙漠、对比,这几个词后来在检索里真的用上了。
四、第二层:让模型听懂人话
搜索框收到的是人话,而库里存的是标签和描述,中间需要一步翻译。这一步不能省,也不能让模型直接给答案,因为图库的标签是我自己索引出来的,本地做精确匹配比让模型回忆哪张图合适要靠谱得多。
模型在这里只负责把一句话变成条件。这一层换成蓝耘元生代上的文本模型,在配置里是 text_model,和刚才那个视觉模型共用同一份凭证、同一个接口地址。
条件的数据结构是固定的六个字段,keywords 是必须出现的核心词,objects 是画面里应有的物体,scene 是单个场景词。另外三个是 colors、has_text 和 exclude,分别表达颜色、要不要有文字、以及必须排除的东西。
提示词里写得很直白,宁可少写也不要推测,因为多加一个用户没提的概念,就等于多加一条错误的过滤条件。拿到返回之后仍然是一套容错,模型给回来的东西可能在三个方面不合规矩,外面包了一层文字、字段类型不对、或者一个有效词都没给出来。
处理办法是先把 JSON 截出来,再把每个字段做一次类型归一,字符串当成单元素列表,缺字段按空列表走,值不合法的类别直接归到其他。这三层里任何一层没过,都退到下一节要讲的那条本地路径,而不是把一个半成品条件拿去做检索。
五、模型那一层不可靠,所以留了一条本地路径
搜索不能因为模型这一层出问题就用不了,而模型这一层出问题才是常态,没配凭证、超时、限流、返回的不是 JSON,任何一种都会让"理解搜索词"这一步空转。所以我给它准备了一条不依赖模型的本地路径。
做法是把库里已经打出来的标签直接当词典用,八个测试图跑下来攒了 52 个标签。它们本来就是给这套图库打的词表,比另建一份同义词库准,也会随着索引内容自己长大。
在词典之外再叠一份人话到标签的映射,比如"傍晚"指向黄昏和日落,"海边"指向海岸和海,"水"指向河流、海、海洋、海岸这一串。这条路径完全不需要经过蓝耘元生代,图库有多少标签,它就能认多少词。
扫描的时候按词长从长到短匹配,并且已经吃掉的字符不重复计,这样"海边"命中之后,"海"就不会再单独成立一次。否则一个词会同时捞出两个标签,把匹配的分数抬虚:
terms = sorted(set(lex) | set(_SYNONYMS), key=lambda t: (-len(t), t))
for term in terms:
    start = 0
    while True:
        i = text.find(term, start)
        if i < 0:
            break
        if not any(taken[i:i + len(term)]):
            for j in range(i, i + len(term)):
                taken[j] = True
            hits.append(term)
        start = i + 1
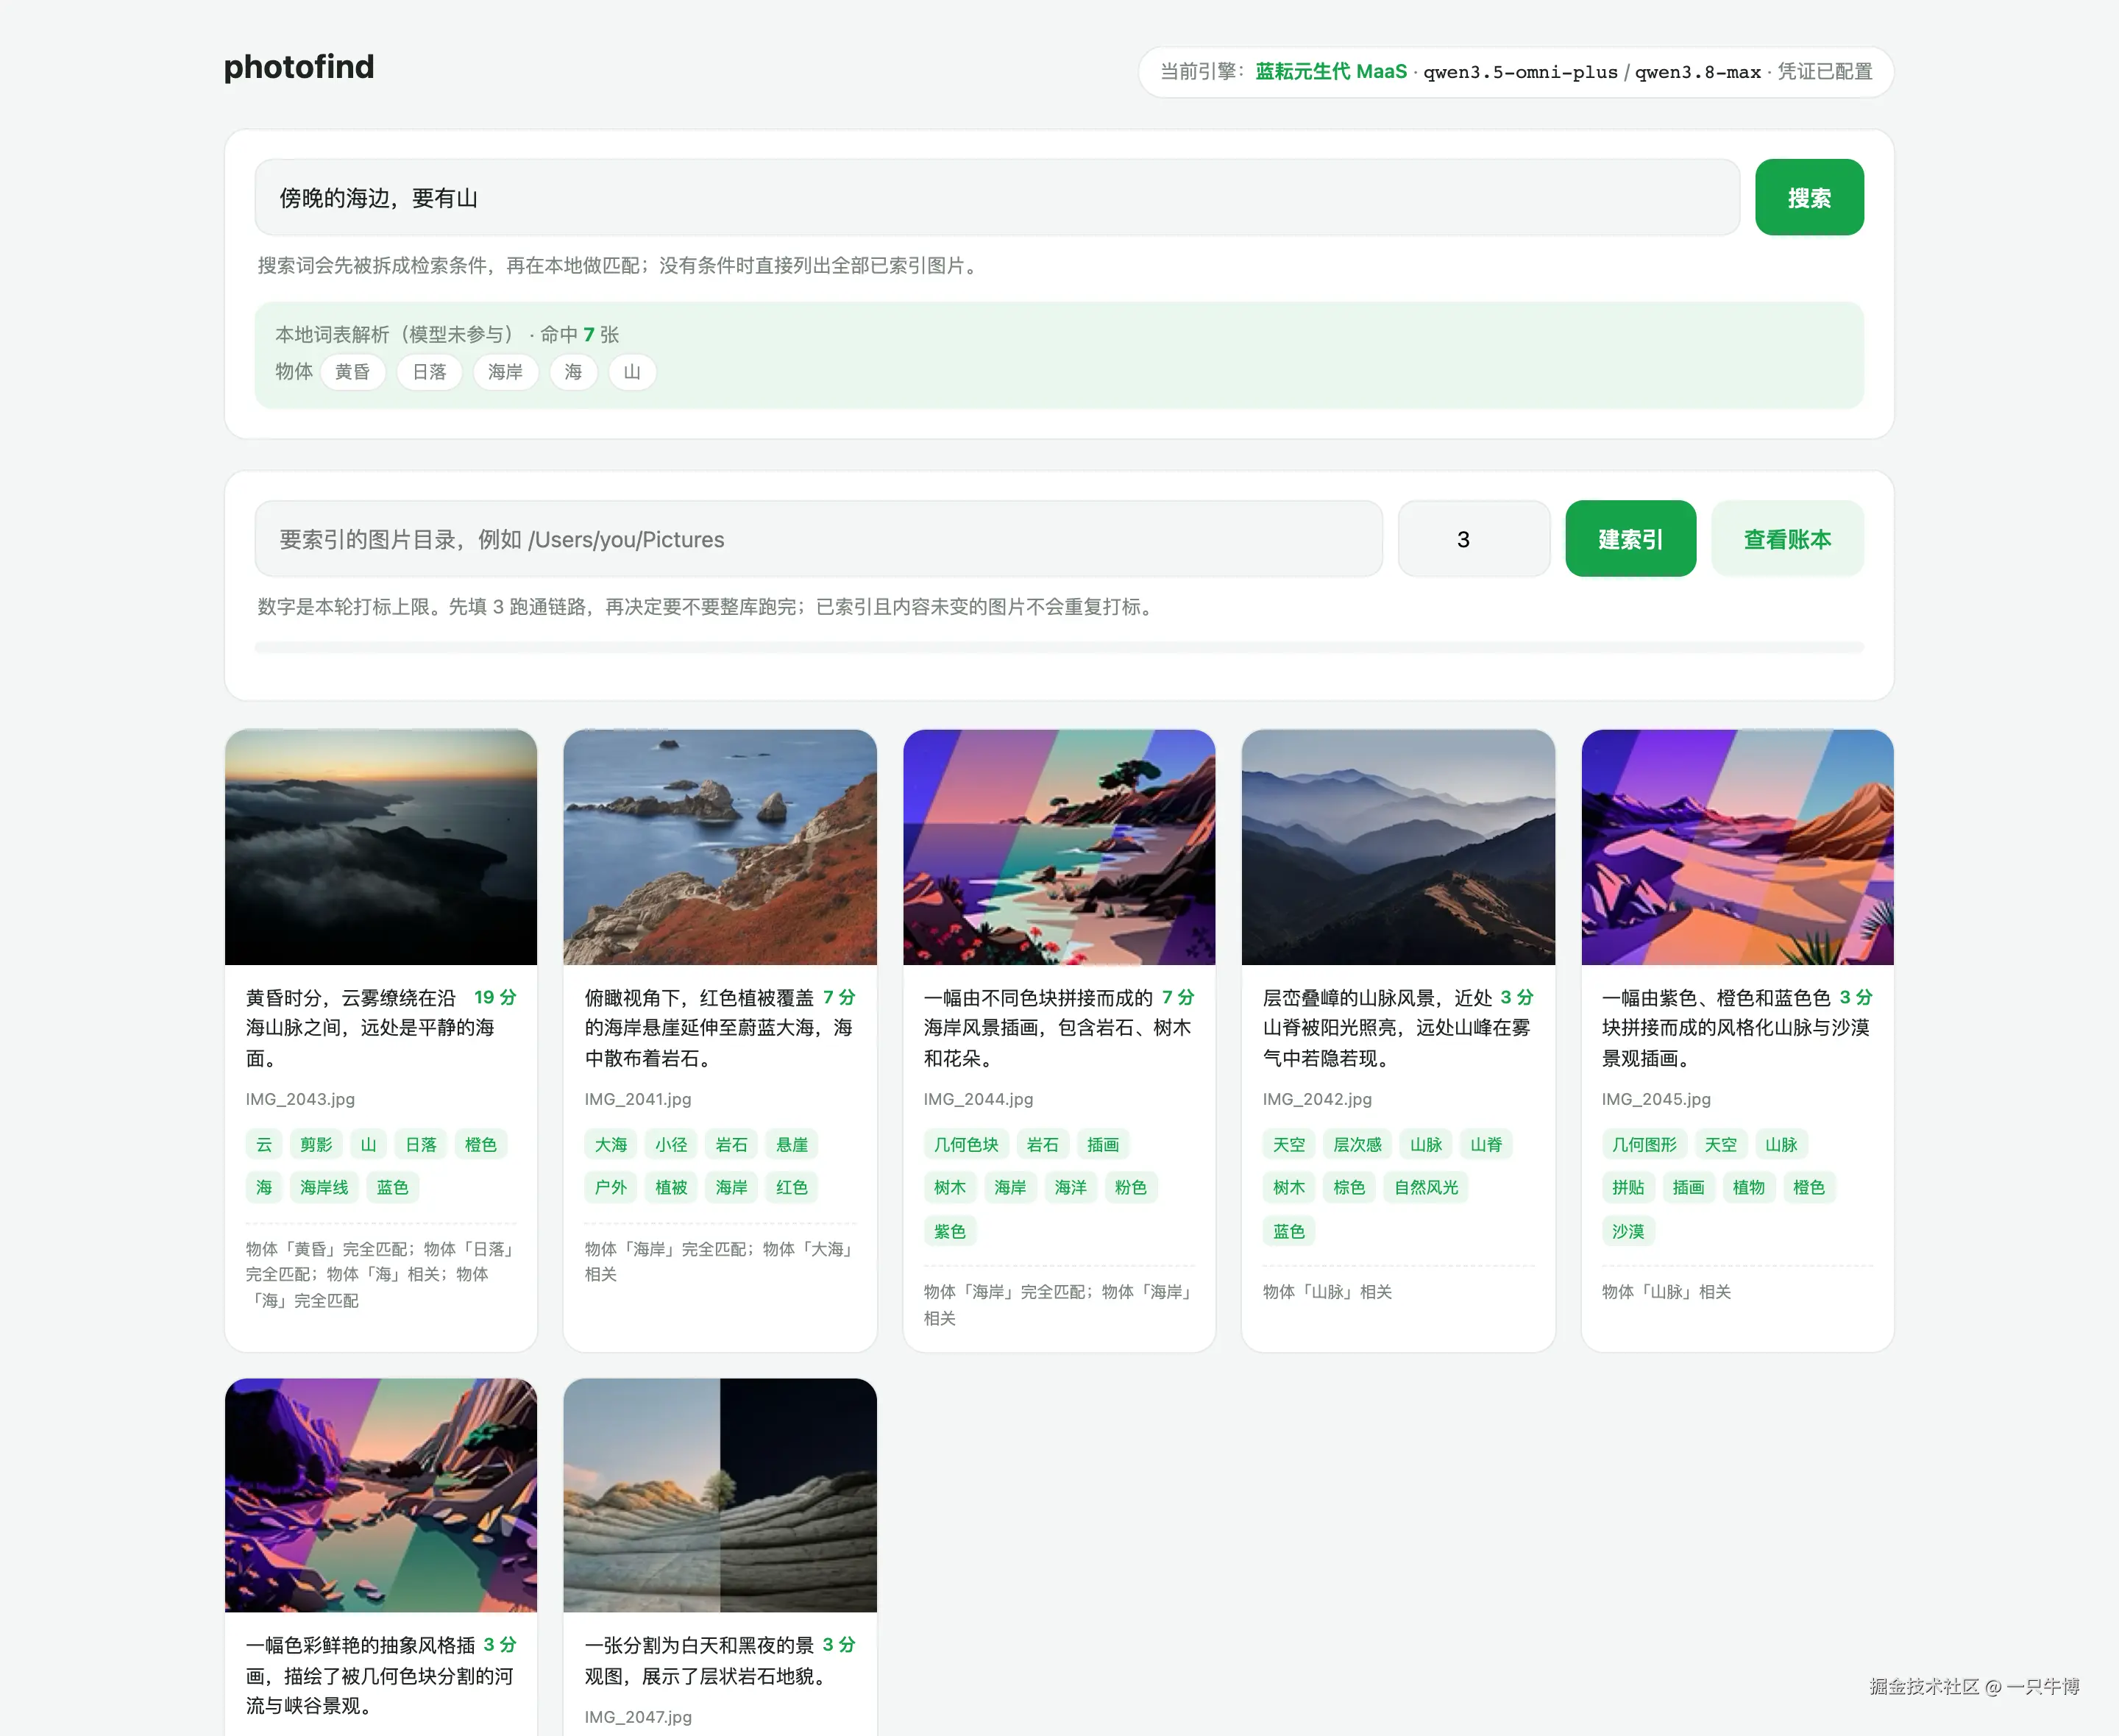
否定条件单独处理,从"不要""排除"这类词处把句子切开,后半段只扫进排除项,不参与正向匹配。下面这张是搜"傍晚的海边,要有山",条件是黄昏、日落、海岸、海、山五个词,命中七张,那张黄昏时分云雾绕着沿海山脉、远处有平静海面的图排在第一位。
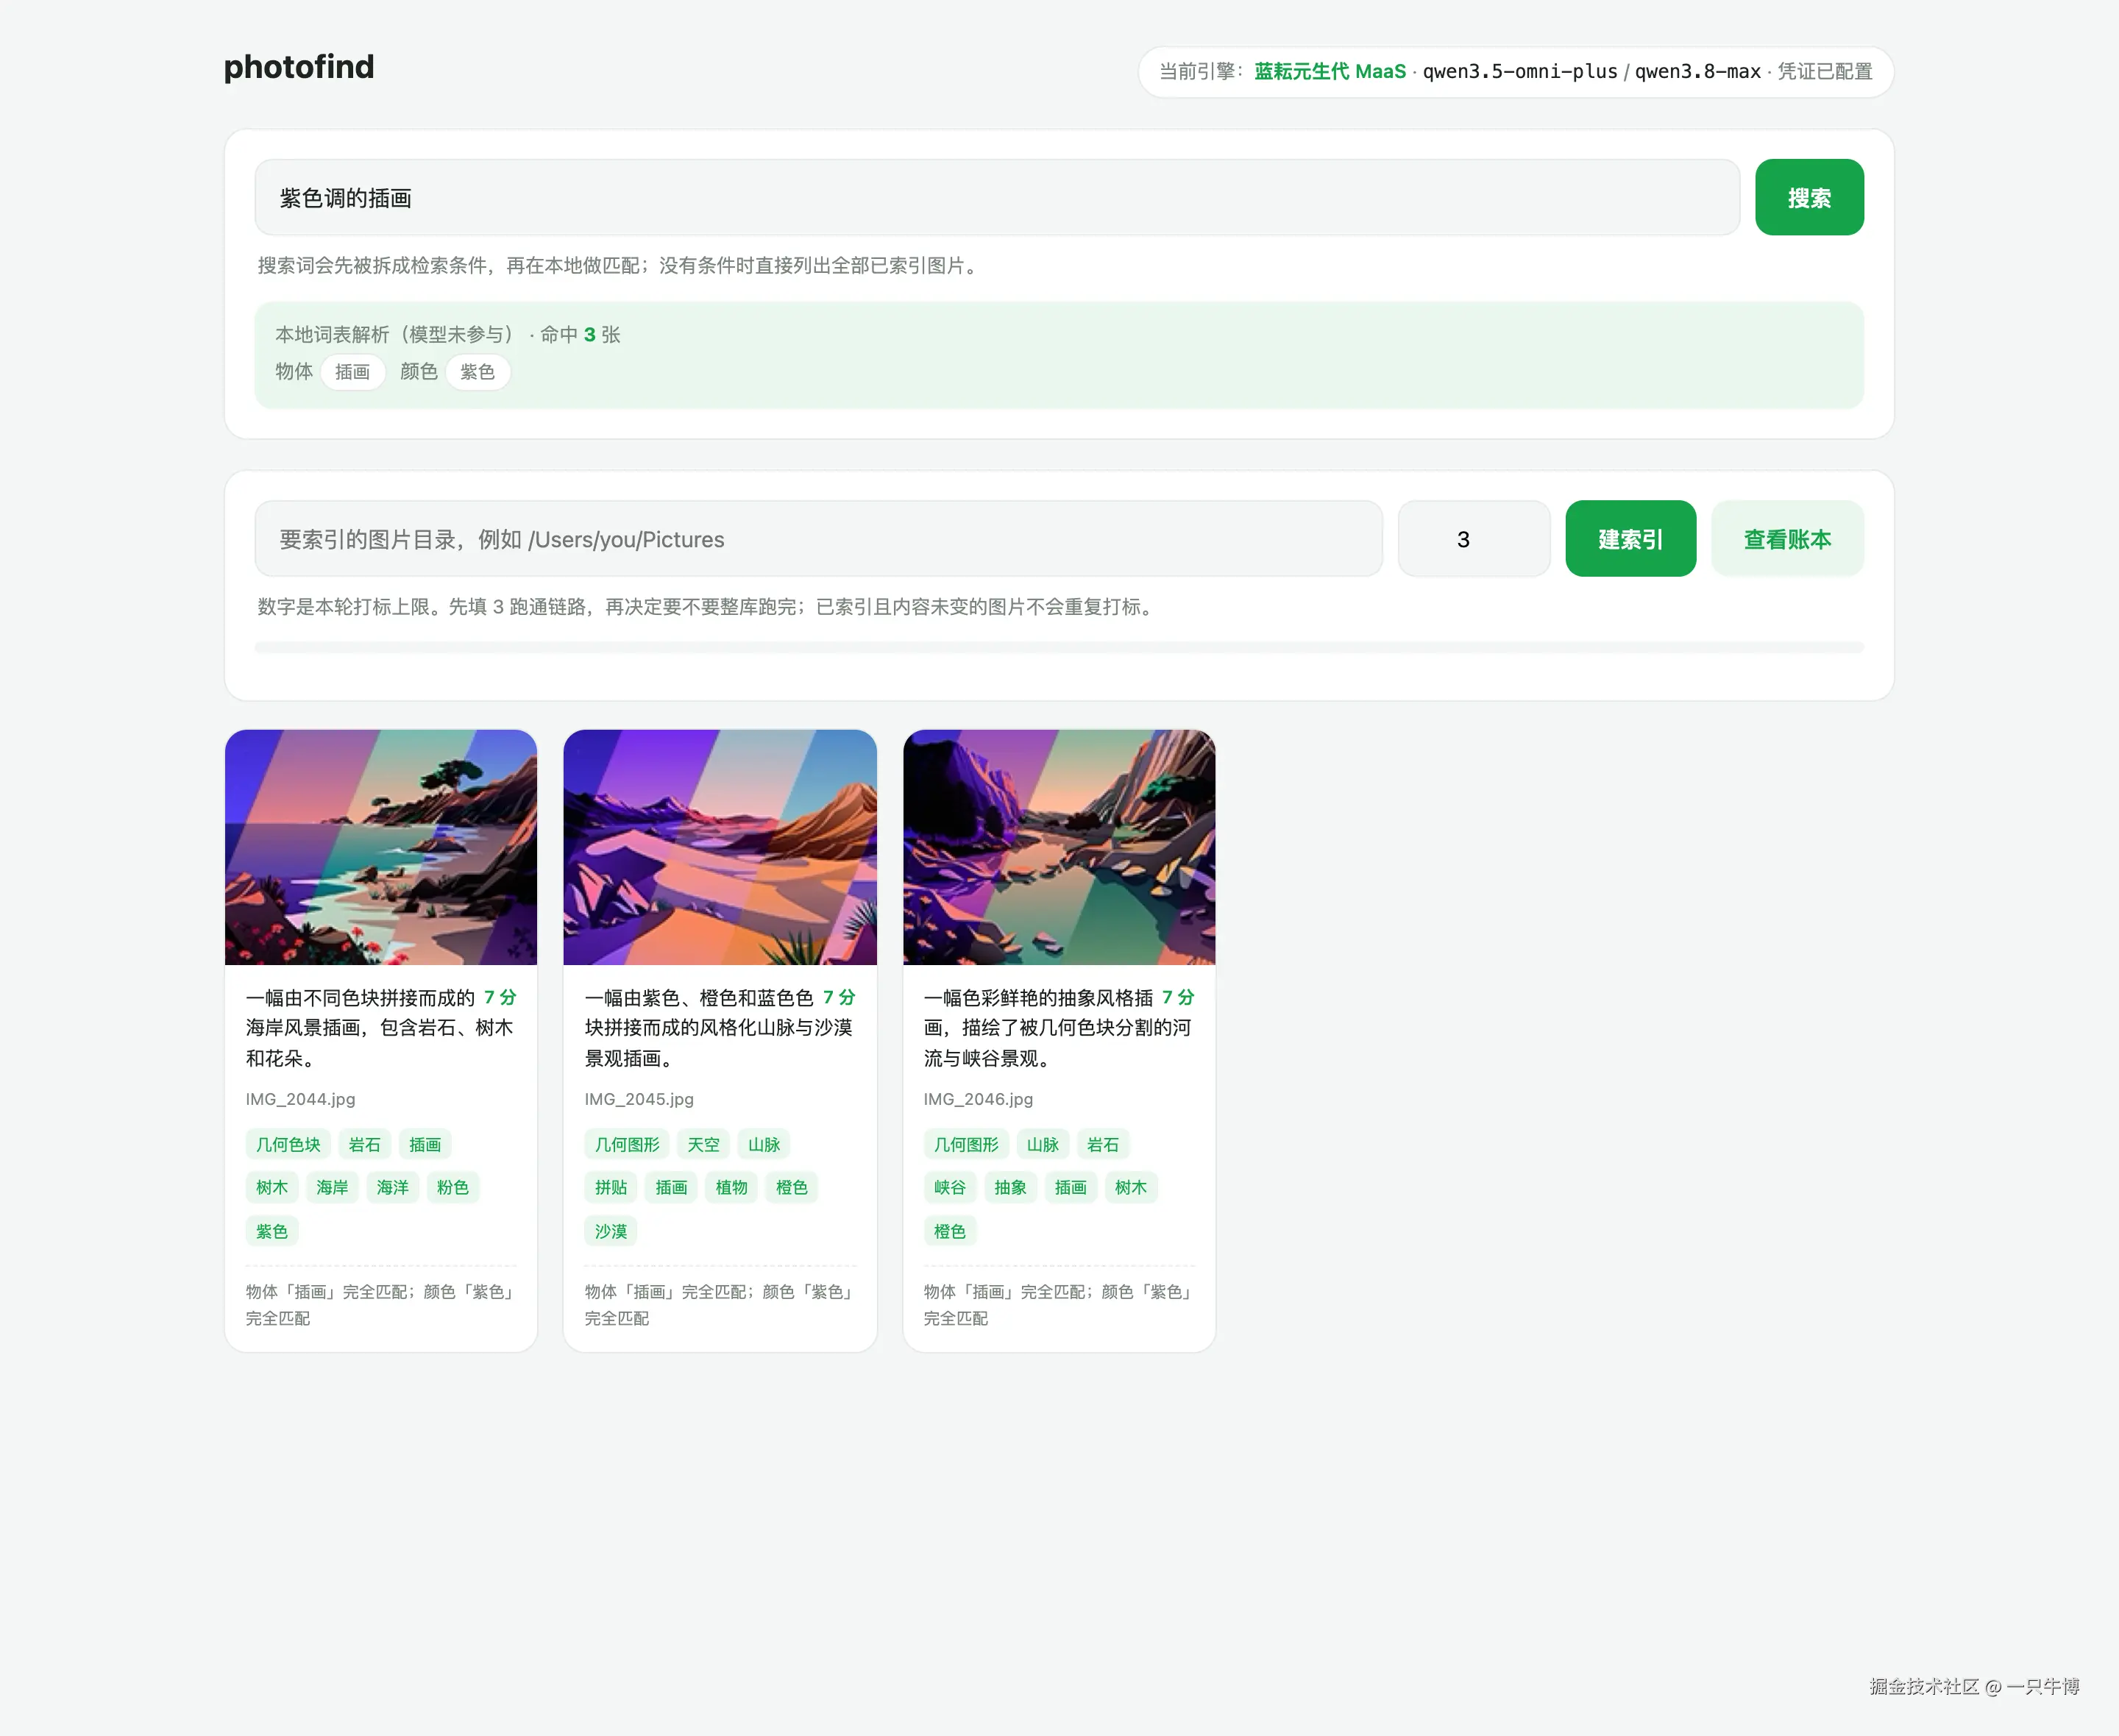
颜色和物体分开走两条通道,所以"紫色调的插画"会被拆成一个颜色条件加一个物体条件。命中的三I张都是拼接风格的插画,颜色和内容同时在起作用,这张截图里两个条件块分开列着,分数也标在卡片上。
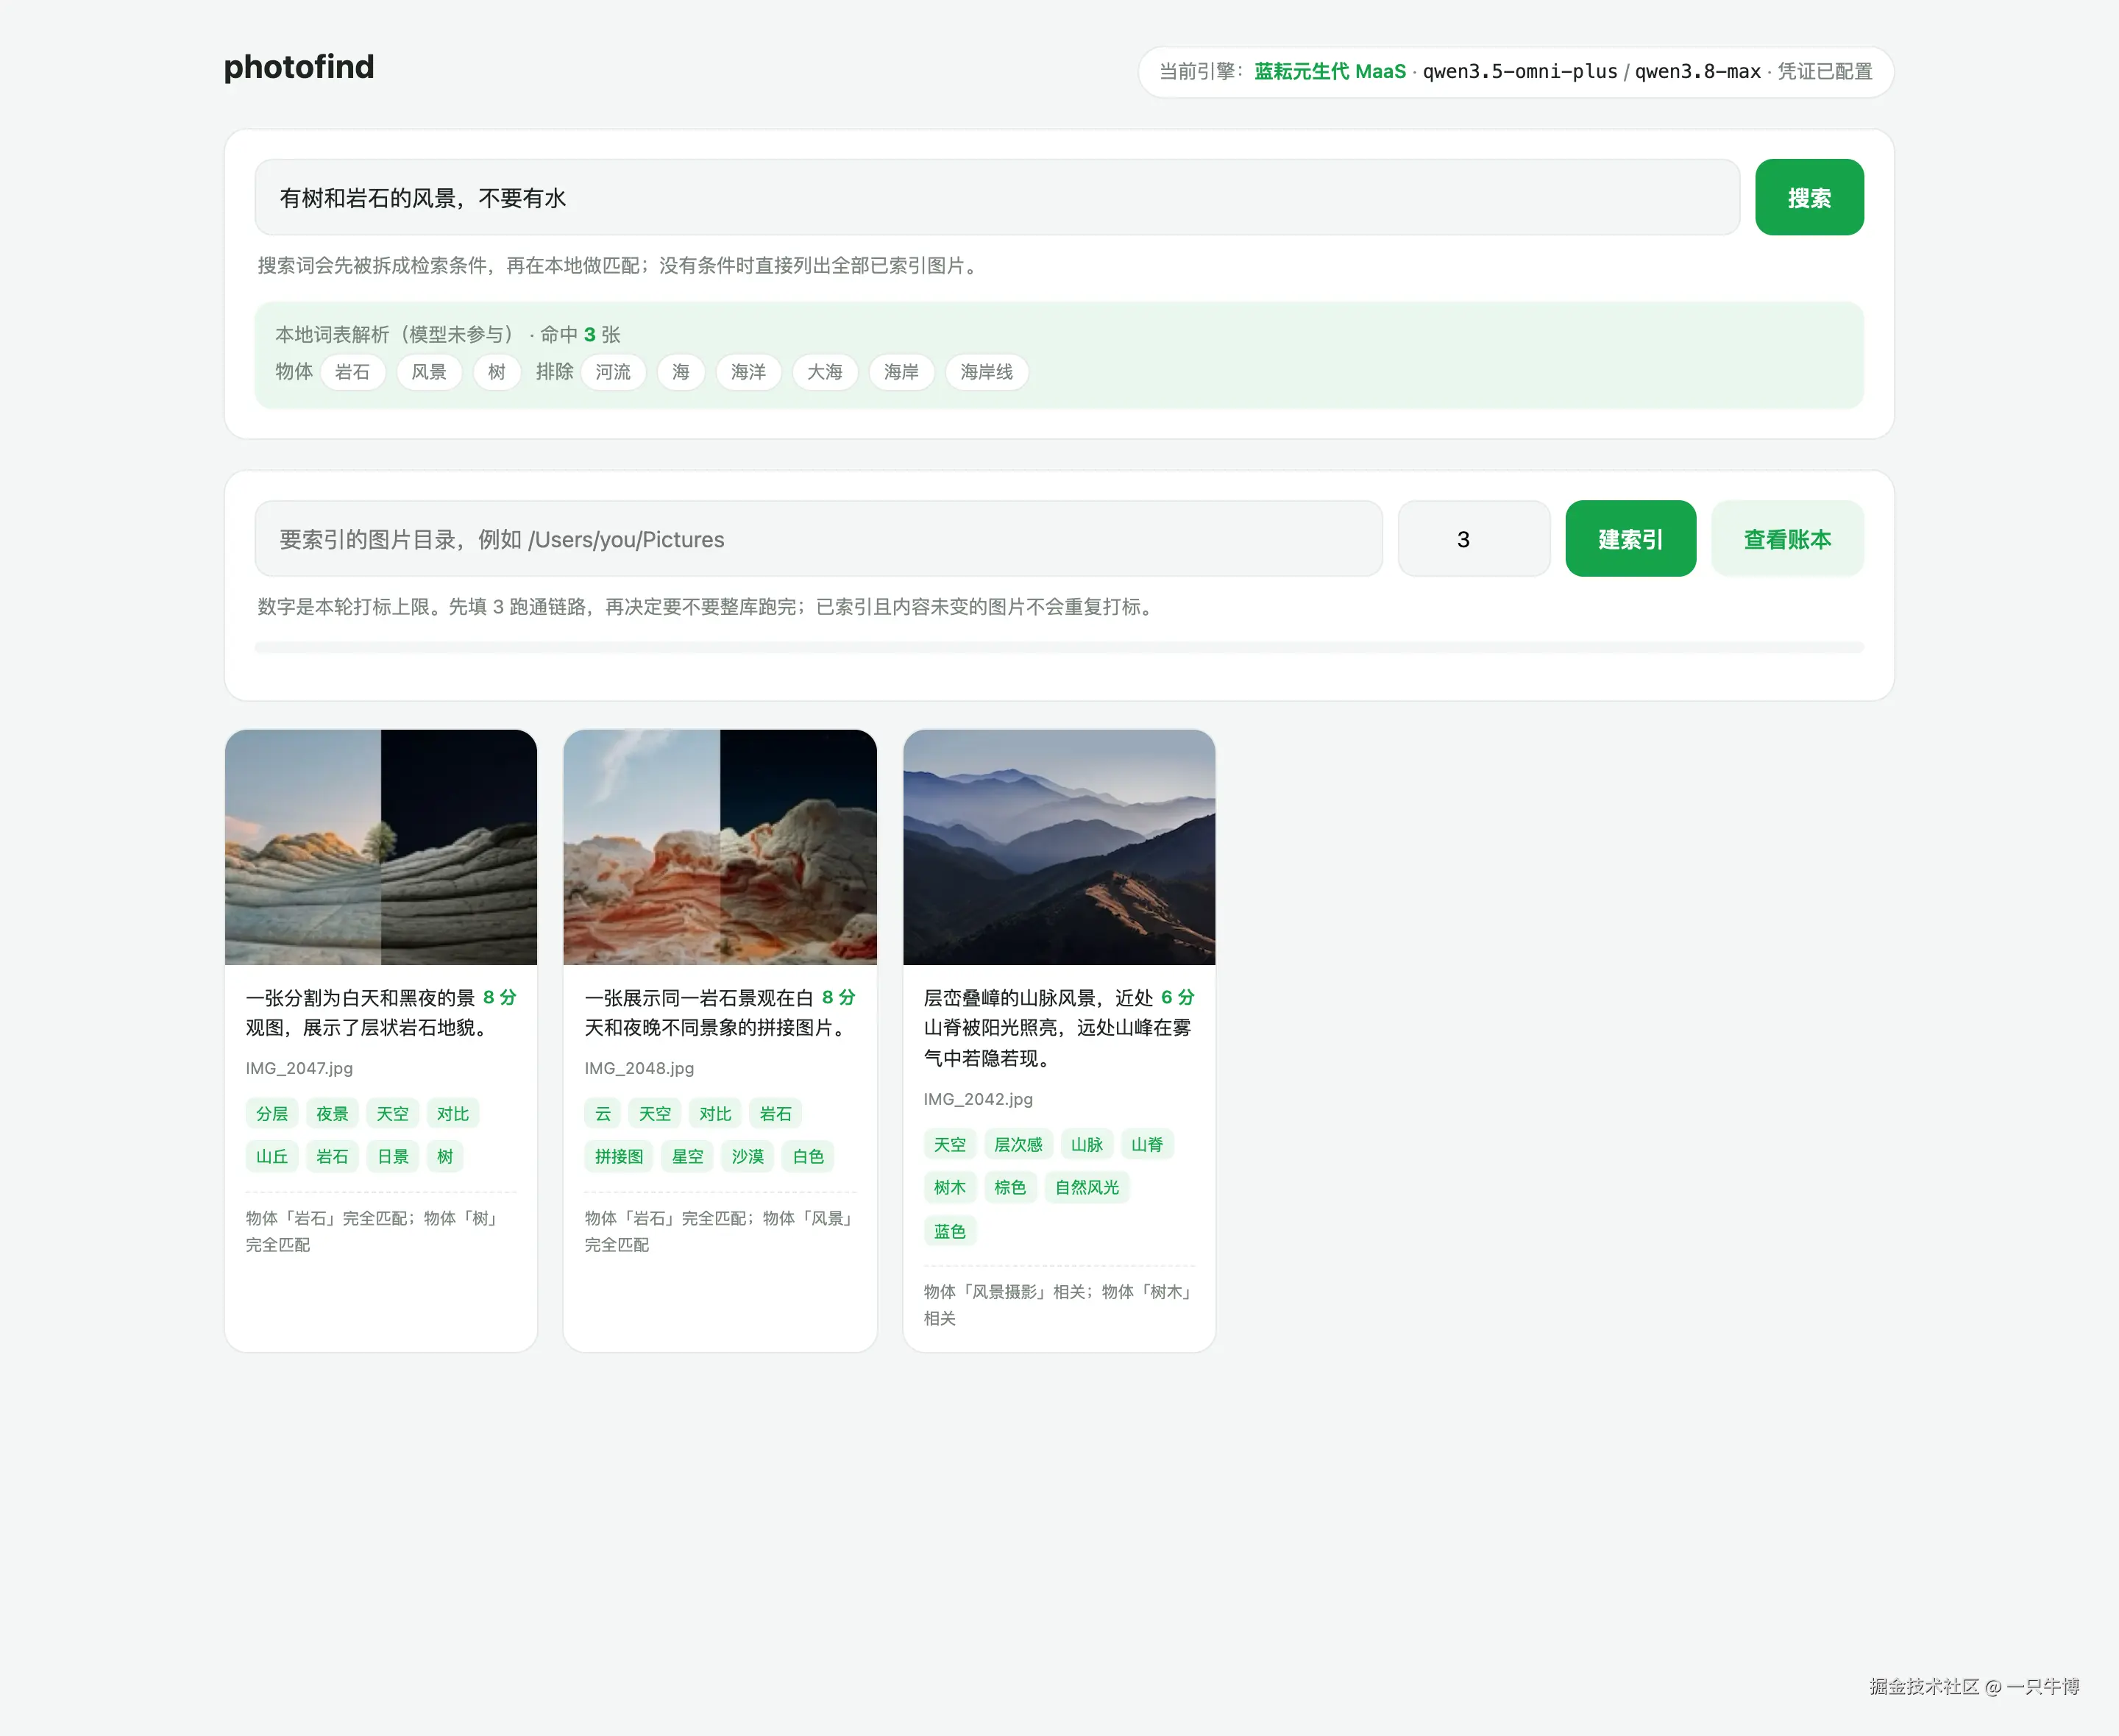
排除条件是最能说明本地路径价值的一处,搜"有树和岩石的风景,不要有水",正向条件是岩石、风景、树,排除项展开成河流、海、海洋、大海、海岸、海岸线六个词。结果是命中三I张,六张带水的图一张都没漏进来,如果这一步交给模型,排除词也可能被理解成"想要水",那就要靠人工去核对结果了。
六、几处取舍,和现在还没做好的地方
先说不好用的地方,本地词典这条路解决的是"能按这套图库自己的词表找",不是"懂你的意思"。图库里没出现过的概念它就真的找不到,比如搜"有故事感的照片",词典里没有任何一个标签能对应,它只能退成整句切词,命中多半是零。
模型在线时这一步是能救回来的,模型给得出"剪影""层次感"这类词。再说现在还没做好的,账本只记了打标那一层,搜索走模型时的调用没有落进去,所以本地账本里看不到搜索的消耗。
这个问题我是整理数据的时候才发现的,属于埋点漏了一处。蓝耘元生代那边的调用记录是完整的一份,两边口径不一样,对齐的时候才把它翻出来。
第三处是分词,现在的同义映射是我手写的,收得比较克制,只写有把握的对应关系。写宽一点命中率会上去,但会把不相干的图一起捞进来,写窄一点就是现在这样,碰上没收录的说法只能落到字面匹配。
这是本地路径真实的边界,不是能靠调参绕过去的。
七、小结
这套东西现在能做的事,是把"我要找一张傍晚海边有山的图"变成一次带条件的检索。八张图跑一轮 28.9 秒,全程只有看见画面和理解人话这两步离开了本机,其余从遍历、压缩、去重到打分排序都在本地闭环。
模型那两层交给蓝耘元生代之后,最省事的地方不在调用本身,在于视觉和文本两个模型共用一份凭证和一个地址。换模型改的是配置里的一行,账本和调用记录也还是同一份。
这条链路上真正需要判断的地方不是选哪个模型,是哪一层该交给模型、哪一层必须留在本地,分错了,要么白花调用,要么结果不可信。下一步我打算把搜索那一层的调用也记进本地账本,再把同义映射换成从标签里自动聚类的做法,让词典能跟着图库自己长大。