Jev 入门:从结构化决策到 Python 实战
许多业务接入 AI,并不需要一段流畅的回答,而是需要一个能被程序直接消费的明确判断,例如工单该分给哪个部门、风险处于什么等级,或某个条件成立的概率。Jev 正是面向这类结构化决策场景设计的模型。下面将从输出机制、题型选择和 Python 示例入手,说明它的适用方式与工程边界。
2026 年 9 月 15 日,由前 OpenAI InstructGPT 核心作者 Diogo Almeida 创立的 TypeSafe AI 宣布获得 4,000 万美元种子轮融资,并推出了其首个公开产品——Jev。
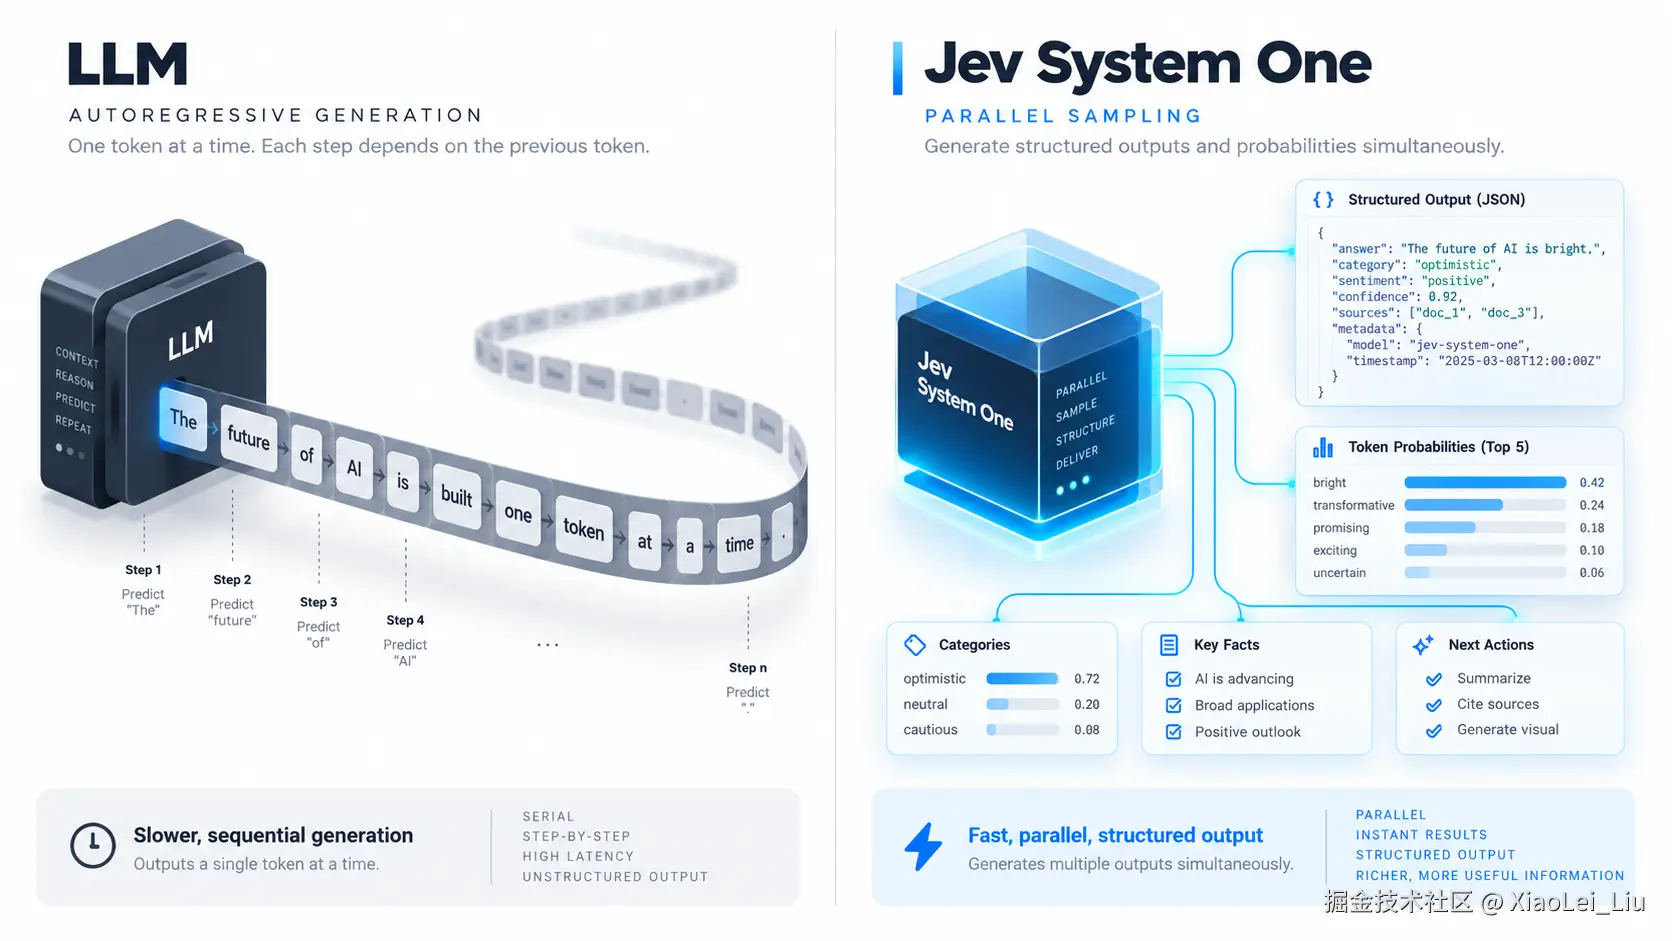
TypeSafe 将 Jev 归类为 System One Model(系统 1 决策模型) 。理解 Jev 最直接的角度,不是把它看作“又一个 ChatGPT”,而是把它当成一个嵌入在业务流中的「确定性判断函数」:它根本不生成自然语言文本,而是只接收状态、根据预设 Schema 并行输出决策值及其概率分布。
一、Jev 和 LLM 的三处结构差异
我们要理解 Jev,关键在于看清它和传统 LLM 的三处底层差异:
-
输出接口:LLM 本质上是用 token 序列来交付答案的。哪怕你开了 JSON mode 或者严格结构化输出,它交付的依然是一串字符串,你的程序必须自己从字符串里反序列化解析出决策。而 Jev 则是直接输出类型事先定义好的结构化值与概率分布。虽然传输结果依然可以用 JSON 承载,但 Jev 本身完全不生成文字。
-
采样方式:LLM 采用自回归生成机制,一个 token 接一个 token 往外吐。如果你要求 LLM 输出思考推理过程或是附带概率,它的生成量就会显著增加。Jev 则采用并行采样,一次查询即可同时返回多个决策。官方给出的端到端延迟在 70 到 500 毫秒之间。
-
训练目标:不同的模型架构对应着不同的对齐目标:
- RLHF(人类反馈强化学习) :优化目标是人类评审偏好的文字,主要应用于聊天产品。
- RLVR(可验证奖励强化学习) :优化目标是程序可以验证的奖励,主要应用于数学、编程等领域。
- RLCD(校准决策强化学习,Reinforcement Learning for Calibrated Decisions) :优化目标是校准过的决策以及如实反映把握程度的概率,专为 System One 任务设计。RLCD 直接针对结构化决策进行优化,严格要求模型给出的概率与现实中事件实际成立的频率保持一致。
二、三种题型:Choice、Score、Noul
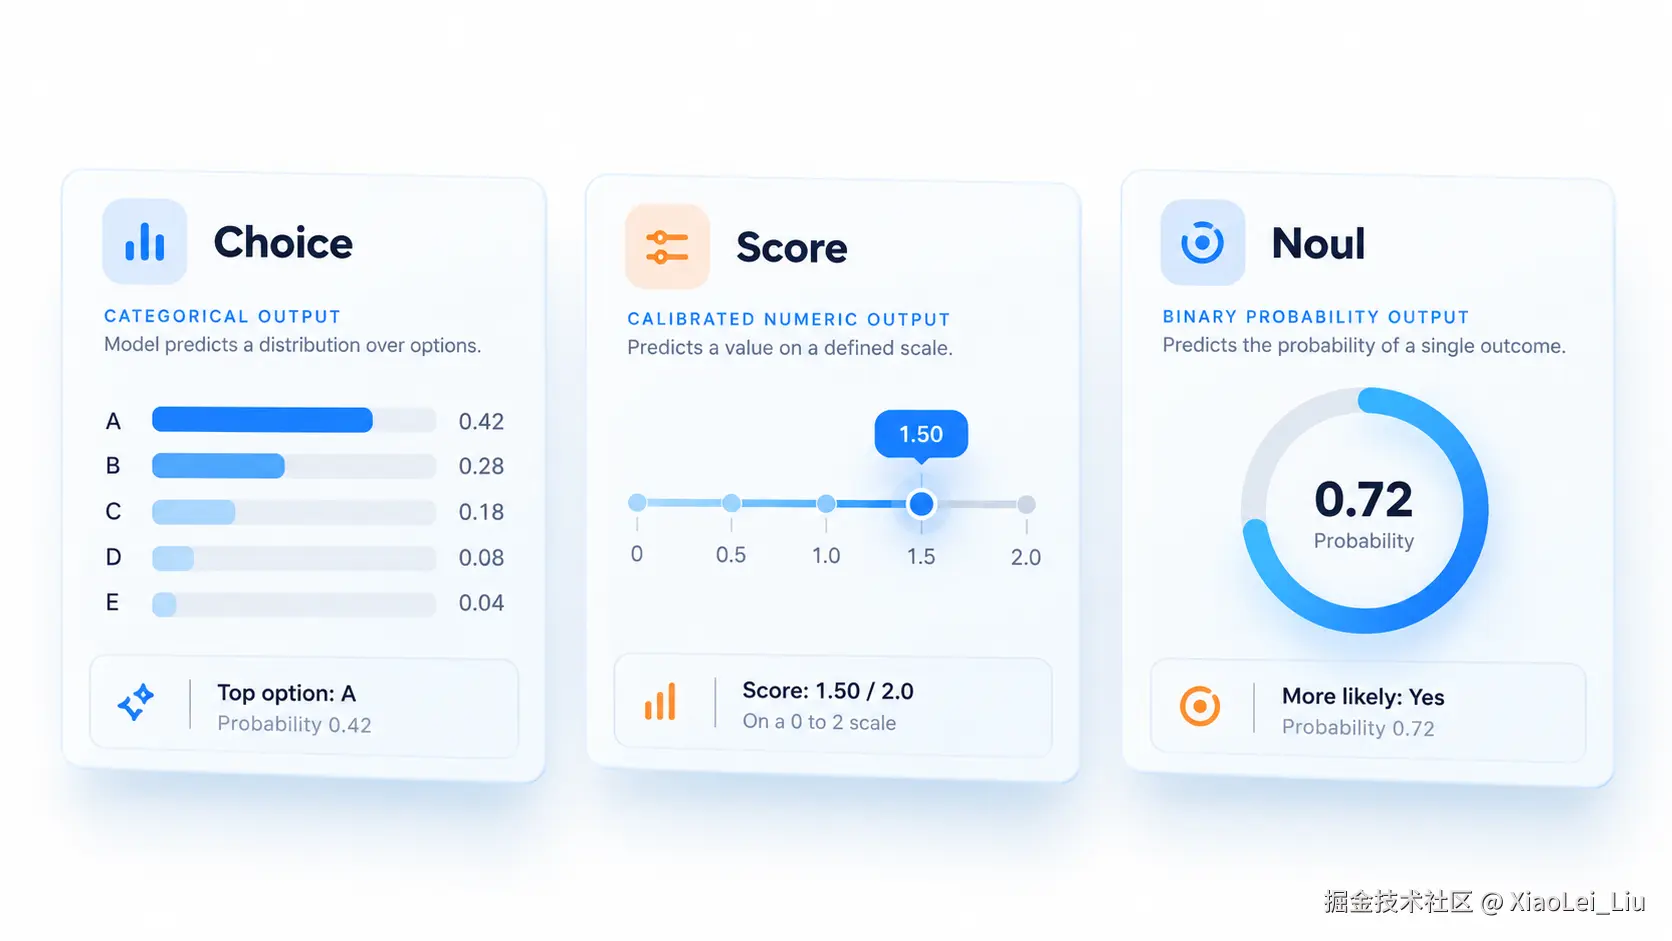
在 Jev 的体系里,所有问题只分为以下三种题型:
-
Choice(单选) :从几个没有顺序的选项里挑出一个。适用于客服部门分类、文件类型判断等工作。Jev 会返回概率最高的选项、每个选项各自的概率,以及一个整体的 confidence。
- 示例:输入一条客诉,模型返回退款概率 0.86、投诉 0.11、咨询 0.03。
- 避坑要点:设计 Choice 时务必加上
other或none_of_the_above。如果缺少兜底项,一旦遇到边界例外情况,模型就只能在既有的错误选项里硬挑一个。
-
Score(打分) :在一把有刻度的尺子上进行打分。适用于情绪识别、故障严重程度、候选人经验等有顺序的等级判断。Jev 会返回每一级的概率、一个加权综合分数、等级说明 legend 以及 confidence。
- 加权分数算法(以三级为例):
score = 0 × P(等级0) + 1 × P(等级1) + 2 × P(等级2)。例如当P = [0.1, 0.3, 0.6]时,计算出的score = 1.5。 - 理解要点:这里的 1.5 仅仅代表结果落在标尺上的相对位置,绝不能直接当成具体金额或物理量来使用。同时,Score 的每一级定义都要写成客观可观察的状态。如果仅写「低、中、高」,每个人的理解都参差不齐;建议大家具体写成「不影响使用」「主要功能失效但有替代做法」「核心流程完全中断」这种明确定义。
- 加权分数算法(以三级为例):
-
Noul(判断) :判断某一个陈述成立的概率值。Jev 会返回一个介于 0 到 1 之间的 noul 数值:接近 1 偏向「是」,接近 0 偏向「否」,接近 0.5 则代表难以判断。
- 示例:针对「客户是否明确要求退款?」,返回
noul = 0.72。 - 理解要点:Noul 题型没有单独的 confidence 字段,因为 noul 本身就已经代表了二元事件的成立概率。需要特别警惕的是,0.5 仅代表是与否的几率均等,绝不等于「中等程度」;如果要衡量程度深浅,请换用 Score。
- 示例:针对「客户是否明确要求退款?」,返回
总结一下题型选择的法则:
- 从几个无序类别里选一个,用 Choice。
- 衡量有顺序的程度深浅,用 Score。
- 判断一件事成立的概率,用 Noul。
- 如果你想问「这个人的 Python 能力算中等吗?」,更好的做法是将能力拆解为几级描述明确的 Score 题,直接提问模糊的 Noul 题效果往往很差。
三、第一个实战例子:客服工单分流
我们来看一段来自 aiposthub 教程的 Python 示范。场景是一张工单进来,我们同时向 Jev 抛出三个问题:该派给哪个部门、客户有多沮丧、事情到底急不急。
Python
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "I changed my password and now I cannot log in. "
    "The reset email never arrives, and I need access today."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "department": Choice(
                instructions="Which team should handle this request?",
                criteria={
                    "account": "Login, password, profile, or security issues",
                    "billing": "Charges, invoices, refunds, or subscriptions",
                    "technical": "Product bugs, outages, or integrations",
                    "other": "Anything outside the other categories",
                },
            ),
            "frustration": Score(
                instructions="How frustrated does the customer appear?",
                criteria=[
                    "Calm and only stating facts",
                    "Concerned but still civil",
                    "Very angry or using strong language",
                ],
            ),
            "is_urgent": Noul(
                instructions="Does the message express urgency or time sensitivity?"
            ),
        },
    )

department = response.answers["department"]
urgent_probability = response.answers["is_urgent"].noul

if department.confidence < 0.60:
    route = "human_review"
else:
    route = department.choice
在这段工程实现中,大家要注意三处核心细节:
state代表输入的上下文状态,这里传入的是工单原文。三个问题完全共享同一个state,一次 API 请求全部打包返回。- 在
department的 Choice 题型中,明确配置了兜底的other。 - Jev 的职责非常纯粹,它只负责给出判断。至于最终是自动分发还是转人工审核,完全由下游的 Python
if逻辑掌控。业务门槛完全由开发者自己设定,模型绝不替你决定业务阈值。
安装方式非常标准:直接执行 pip install typesafe-sdk,并将鉴权密钥配置在环境变量 TYPESAFE_API_KEY 中即可。
四、理解本质:confidence 不等于正确率
请大家牢记:confidence 是直接从概率分布的集中程度计算出来的,它反映的是分布到底有多聚集:
- 当分布呈现
0.95 / 0.03 / 0.02时,某个选项断层领先,算出来的 confidence 就很高。 - 当分布呈现
0.40 / 0.35 / 0.25时,没有明显的胜出者,算出来的 confidence 就会很低。
因此,confidence = 0.9 绝对不代表「模型有 90% 的概率做对了」,它的实际作用是帮你的业务系统筛出模棱两可的模糊判断。
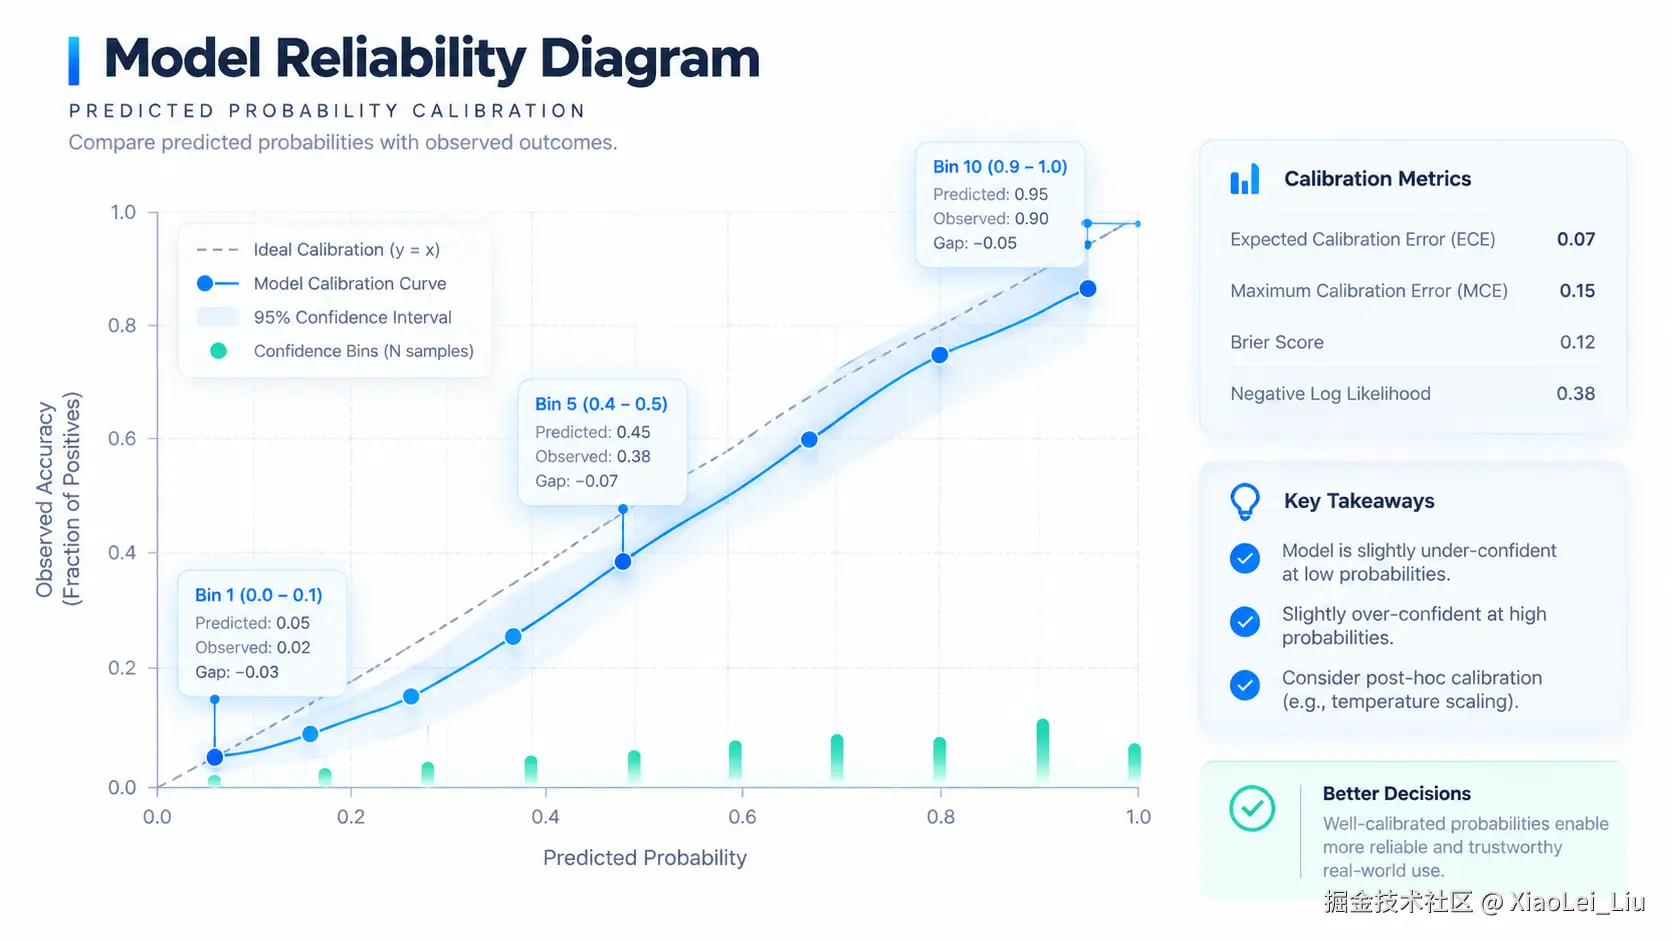
要检验模型输出的概率是否真的靠谱,必须看「校准(Calibration)」。校准的定义是:模型给出的预测概率,是否与长期实际发生的客观频率相符。比如模型声称有 80% 把握的一批事件,如果校准做得好,长期统计下来应该确实有大约 80% 是成立的;如果校准很差,真实成立的比例可能只有 40%,也可能高达 95%。
我们需要把准确率和校准清晰地区分开:
- 如果模型 10 题答对了 9 题,但每道题它都声称有 100% 的绝对把握——这意味着答错的那道题它同样自信满满。这种情况叫准确但未校准。
- 如果模型每道题都表示只有 50% 的把握,实际结果也确实只答对了一半。这种情况叫校准良好但毫无用处。
在实际的工业级自动化落地中,系统必须两项指标同时达标。
检验校准的标准工程方法是分桶法:按照模型的 probability 或 noul 分割成若干区间(如 0.5–0.6、0.6–0.7 等),统计各区间在实际业务中的真实准确率。在设定放行阈值时,一定要持续追踪不同门槛对应的放行率、放行案件的错误率以及需转交人工的复核工作量。
千万不要盲目照抄官方文档的示例阈值。如果是客服工单派错了部门,通常后续还能再改派,门槛可以放宽一些;但如果是自动批准退款、封禁账号、直接淘汰求职者这类高危操作,就必须制定极为严密的阈值与人工复核机制。
五、「零幻觉」保证的真实范围
TypeSafe 官方首页宣称的「Zero Hallucinations(零幻觉)」,特指零类型幻觉。
假设我们在接口中定义了 A、B、C 三个合法动作:
- Jev 能绝对保证不会突然返回一个动作 D,也绝不会夹带一串自由文本导致下游程序反序列化崩溃。这是 Schema Matching 在系统设计层面提供的确定性保证,性质如同「三角形绝不可能有四条边」,属于结构规则,而非统计推断。
- 但 Jev 绝不保证在业务上理应选择 B 的时候不会误选成 A。格式合规的结构化数据里,装的完全可能是业务上的错误决策。同理,模型面对模糊意图时,依然有可能给出虚高的置信度。
换句话说:类型安全由 Jev 兜底;但语义决策是否正确、概率是否精准校准,依然需要我们自己做验证。
此外,类型安全完全无法防御提示注入(Prompt Injection)。输入数据中的恶意指令依然能够干扰或篡改 Jev 的判断逻辑。在正式上线生产环境前,大家必须测试对抗样本、严格限制工具的调用权限,并始终保留安全熔断与中止路径。
六、如何理性解读价格与速度数据
截至 2026 年 9 月 19 日,Jev 1.13 的官方定价是每百万输入 token 0.042 美元,输出 token 完全免费。作为对比,官方引用的传统 LLM 输入价格约为每百万 token 0.20 至 10 美元,输出价格通常是输入的 5 倍左右。
我们来算一笔账:假设处理 100 万条文本分类任务,每条长度 2,000 token,合计为 20 亿 token 的输入。
- 使用 Jev 的整体成本仅仅是 84 美元。
- 如果使用每百万 token 5 美元的通用 LLM,光是输入端就需要花费 10,000 美元,输出产生的 token 费用还要另算。
官网宣传 Jev「速度快 193.6 倍、成本便宜 444.6 倍」。我们要清醒认识到:这两个极致数字来源于官方自己的工作流评测(workflow evals),官方自己也承认这是偏高端的极端表现。官方技术博客给出的常规对比范围是:在同等智能水平下,速度大约快 40 到 200 倍。
官方在发布评测时,非常诚实地列出了四项局限与保留意见:
- 评测工作流完全是由 TypeSafe 自己的模型能力团队搭建的。
- 评测的参考标准答案来自 OpenAI 和 Anthropic 的模型输出。
- 评测输入的上下文状态刻意设计得短小而高密度,这种形态对 Jev 天然有利。
- 对照组的 LLM 是通过官方包装的 System One wrapper 进行调用的,这种封装方式本身就会让 LLM 跑得更慢、更贵。
目前业界可参考的第三方实测数据主要有两份:
- Vercel:将 Jev 用于指令安全分类任务,实测处理速度提升了 5 到 18 倍,且分类准确度更高。
- Bryo AI:在商务邮件分类任务中对比了 Jev 和 Gemini,实测 Jev 便宜 10 到 20 倍,但在决策准确度上 Gemini 略占优势。
关于定价策略,官方也坦承了三点现实:目前无法证明该价格不存在早期市场补贴;这种定价能否长期维持需要时间检验;不过他们预期的长期价格走势是只降不升。
因此,我在评估架构时建议大家:速度和成本的账面数字适合作为立项测试的假设依据,千万不要直接原封不动地写进采购回报测算里。而且校准表现的所有结论,目前全都是官方团队内部评测得出的,尚无独立的第三方校准检验报告出炉。
七、什么任务适合交给 Jev?
在选型时,只有当一项任务同时满足以下三个条件,才适合交给 Jev:
- 输入是纯状态或数据,而不是多轮对话。
- 输出是结构化决策(类别、打分、选项等),而不是长篇大论的文章。
- 结果直接交由程序消费(进入代码分支 if 判断、写入数据库),不需要直接过人眼阅读。
业界材料总结了五个典型的动作动词:Classify(分类) 、Route(路由流转) 、Score(量化评分) 、Extract(实体抽取,如合同到期日、订单流水号) 、Branch(逻辑分支,如自动放行或转交人工) 。这些任务的共性是:吞吐量极大、单次判断的边际价值中等,而且其业务风险完全可以通过概率门槛与防御代码有效对冲。
另一个经典场景是用 Jev 来坚控大型 LLM。我们可以用它来实时审查 LLM 的输入 Prompt、抽取后的关键字段、模型推理轨迹以及工具调用的参数,严防越狱攻击、错误引用和事实幻觉。因为这类坚控性调用的并发频次远高于业务调用本身,所以坚控模块在成本上必须比业务核心低上至少一个数量级。
相对地,以下任务依然必须交给通用 LLM:开放式聊天、撰写富文本客服回复、写作 Copilot、Coding Agent、深度复杂数学推演以及开放式多步规划。
这两种模型完全可以打好配合。比如 Browser Use 的联合创始人 Gregor Zunic 曾展示过一个查机票的实际 Demo:让 Jev 负责判断并选定下一步执行动作,而让轻量级的小型 LLM 专门负责输入对应的文本内容。整个交互仅耗时约 7 秒,花费仅约 0.0039 美元。不过大家要保持理性,这仅仅代表一次成功的原型演示,并不能直接推导为工业级普遍成立的高成功率。
另外,大家在开发时必须清楚 Jev 1.13 当前的边界与限制:
- 模型弱项:根据官方说明,它不擅长计数与精确数值运算、日期前后比对、多层间接因果推理,且在输入中混杂大量无关噪音时表现会下滑。
- 模态支持:目前仅原生支持文本输入。图像、音频、视频必须先在预处理阶段转化为文本或结构化字段。
- 语种表现:英文表现最为优秀;中文等 CJK 语系虽然支持,但准确度相对稍逊一筹。
- 容量上限:输入的
state加上最长的问题定义不能超过 32K token,单次完整请求的总量不能超过 64K token。 - 选项上限:单个 Choice 题型最多仅支持 255 个选项。如果候选类别过多,建议拆解为两步工程处理:先对每个类别做独立的快速打分筛选,再在缩小范围后的候选集里做最终明确单选。
工程应对的最佳实践是:先利用工程检索粗筛过滤无关数据,接着由 Jev 进行精准语义判断,而具体的日期对比、数学运算和强规则核验,坚决交还给传统代码逻辑处理。
八、新手最容易踩的五个坑
根据前人的实操教训,新手最容易踩进这五个坑里:
- 直接把巨型模糊问题丢给模型:比如直接问模型「这位客户该怎么处理?」。一个看似简单的问题内部其实混杂了类别路由、情绪烈度、退款资格核验、风险识别等多个维度的决策。大家应该将其拆解为多个专职的小问题,最后在代码层面汇聚结果。
- Choice 题型漏设
other:缺乏逃生选项,导致模型在遇到未涵盖场景时只能在预设的错误选项里盲猜。 - Score 题型使用抽象主观词:在刻度定义中简单粗暴地写「低、中、高」,导致模型与开发者的理解严重脱节。
- 起步阶段就让模型直接触发不可逆的敏感操作:正确的系统落地顺序,是先从打标签、优先级排序和辅助建议做起;等到离线回归测试和大量人工抽检查验充分验证了门槛的合理性后,再逐步开放低风险环节的自动化流转。
- 拿英文评测表现盲目推测中文场景:做中文业务的团队一定要拿生产环境的真实样本做独立验证,重点覆盖官方书面用语、口语化表达、带错别字的场景以及中英夹杂的真实输入。
九、四步工程上线法则
目前 Jev 处于 Early Access 预览阶段,大家需要先去官方控制台(console.typesafe.ai)申请登记排队。顺便提醒一句,在它刚刚发布上线时,曾因突发请求量暴增导致 API 出现过短暂中断。
如果要引入现有生产环境,我建议大家严格遵循这四个步骤:
- 对照测试:准备同一批真实的历史数据样本,让现有的 LLM 跑一遍,让 Jev 同样跑一遍,拉齐比对双方在准确率、校准稳定性、p95 延迟以及总体消耗成本上的差异。
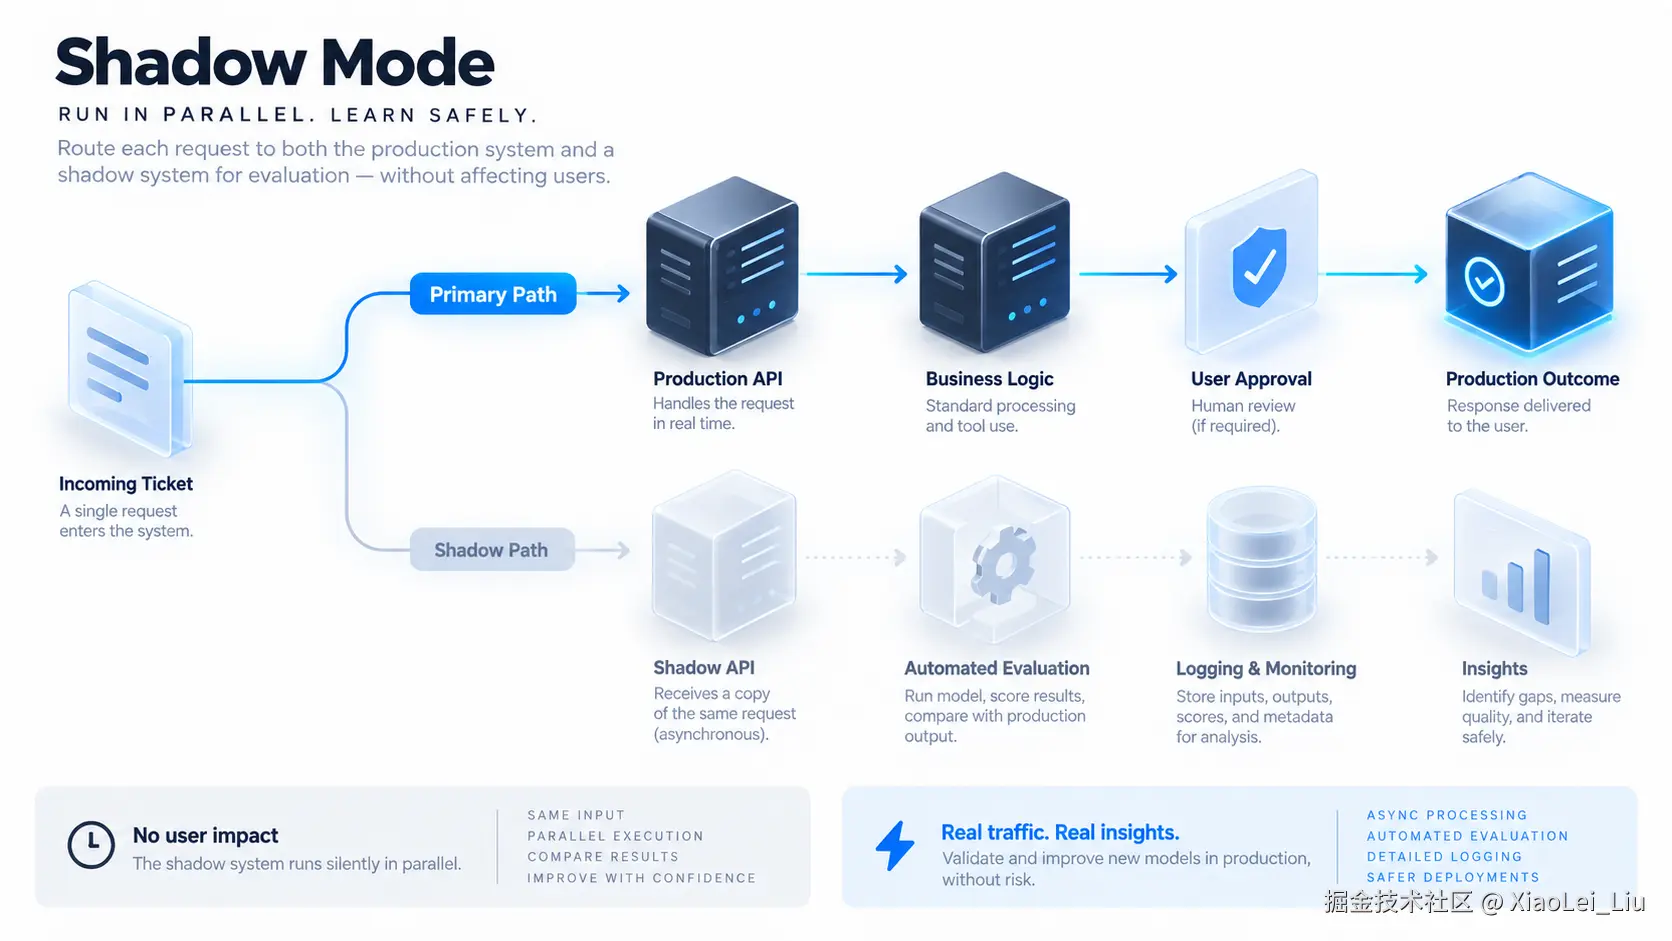
- 影子模式:将 Jev 正式接入真实环境链路,但只在后台静默记录其决策结果,不触发任何实际业务动作。让它与现有的成熟系统并行跑一段时间,用线上真实业务流量喂养并积累观测数据。
- 小流量试行:经过影子数据验证后,圈定部分低风险边界,正式给 Jev 开放决策放行权限,持续灰度观察稳定性。
- 持续监测:生产环境必须始终保留随时一键切回传统 LLM 兜底的备用路径;一旦通过指标发现模型的概率校准出现漂移,立刻触发报警介入。
另外在生产治理上:默认的 jev-latest 会随着官方版本迭代自动变动。在阈值参数已经调优定型的正式线上系统里,务必显式锁定具体的模型版本 ID,并要在日志里完整记录每次业务响应对应的确切版本号。
如果你暂时还没有拿到官方的内测资格,社区里有开源的 System One Adapter,它能通过标准 LLM API 完整模拟出 Jev 的这一套调用接口,大家完全可以先用它来跑通工程架构与对照评测。
十、命名来历与第一步行动
最后聊聊 Jev 这个名字的来源,了解这些能帮你更好地把握它的定位。
System One 的概念源自丹尼尔·卡尼曼(Daniel Kahneman)的名著《思考,快与慢》。在认知心理学中,系统 1(System 1)代表快速、凭直觉运作但容易出错的本能反应,而系统 2(System 2)代表缓慢、耗费精力的深思熟虑。官方坦言系统 1 在公众认知里的名声似乎带着「容易出错」的偏见,但他们坚信经过 RLCD 专门优化的 System One Model 能够比其他方案更加稳定可靠,具体的理论论证官方表示未来会专门撰文阐释。
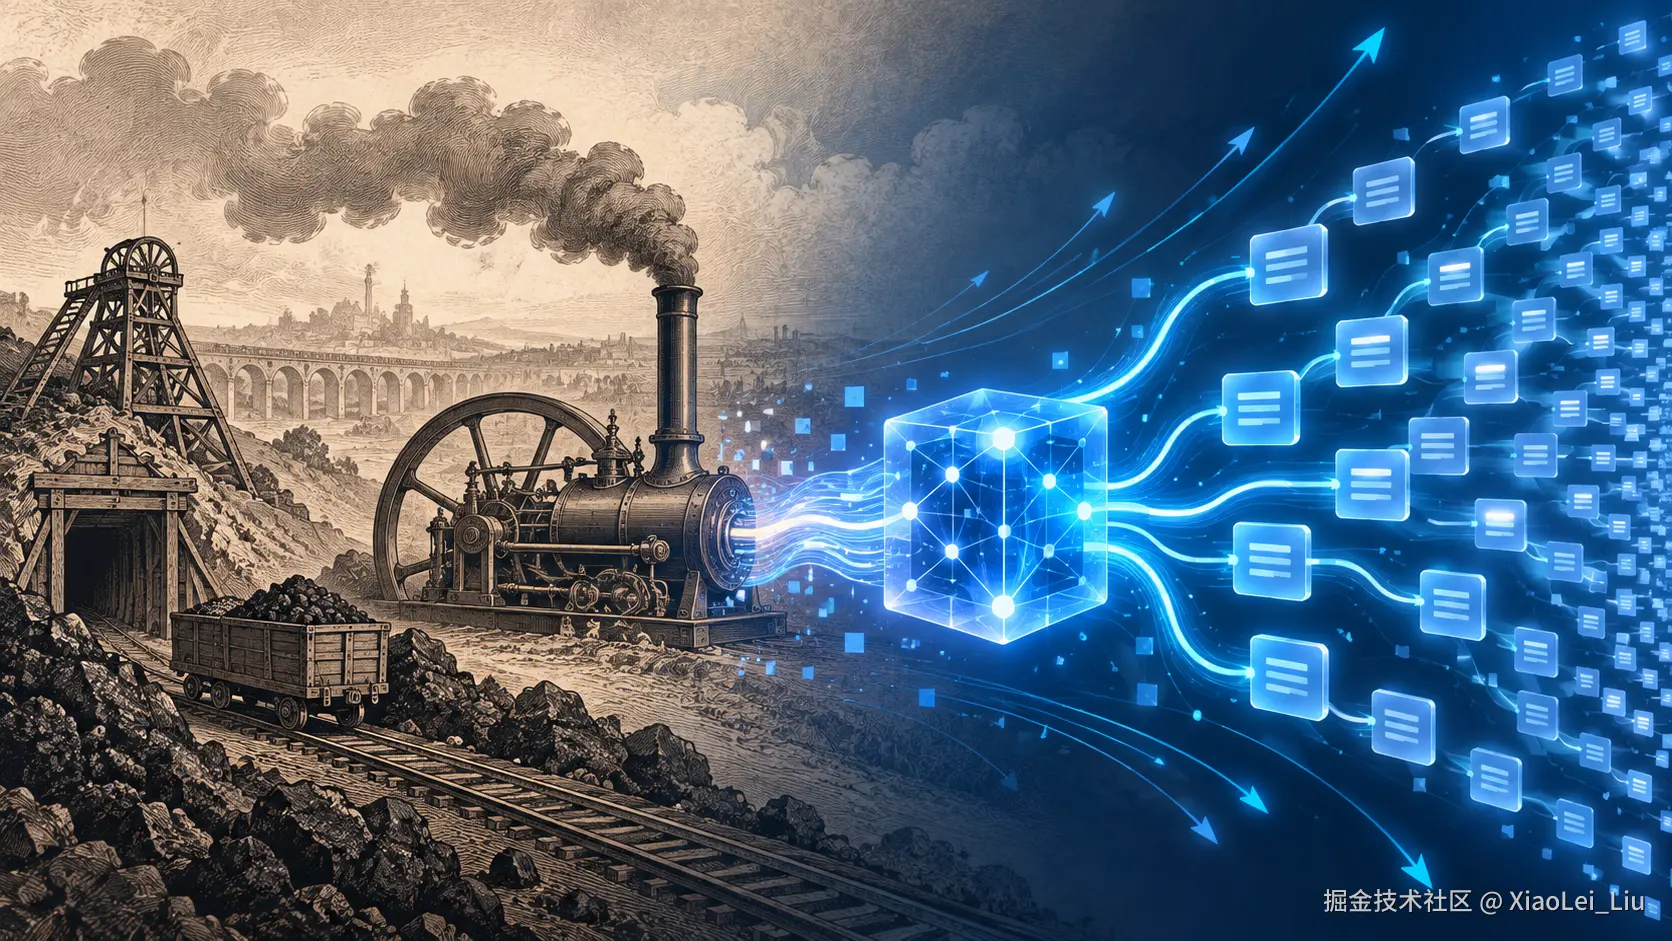
Jev 这个代号,则致敬了 19 世纪的著名经济学家威廉·斯坦利·杰文斯(William Stanley Jevons)。早在 1865 年,杰文斯就在其著作《煤炭问题》(The Coal Question)中提出了著名的「杰文斯悖论」:当蒸汽机的工作效率大幅提升、煤炭利用率显著提高后,煤炭的整体消耗总量不仅没有下降,反而呈爆发式增长——因为极其低廉的使用成本,往往会激发出数量级激增的全新使用场景。
TypeSafe 用这个名字,实际上是在做一场巨大的战略:当单次智能判断的成本下降一个数量级时,必定会彻底解锁多出几个数量级的全新应用场景。 过去那些因为太贵、太慢而被迫放弃使用 AI 的海量高频判断,在全新的成本结构下,都将被重新激活。
这笔赌注最终能否兑现,关键要看工具链的发展成熟度、开发者的工程部署惯性,以及大家对模型原生输出概率的信任程度。在接下来的几个月内,建议大家重点盯紧这几个风向标:
- 它的极低价格能否真正守住而不提价;
- 线上 API 的可用性与稳定性是否足够健壮;
- 业界首批非官方的第三方独立校准评测结果如何;
- 市场上类似架构的同生态竞争对手何时会正式出现。
对于我们开发者来说,当前最有效的第一步行动是什么?
挑出一个你当前正在用通用 LLM 处理、但一直苦于其昂贵成本或高延迟的“小判断”任务,拉出一批历史脱敏数据,亲自跑一次对照测试。哪怕最终你决定暂时不用 Jev,在梳理这个流程的过程中,你也为自己的业务系统沉淀出了一套可以终身复用的基准评测集。