AI 编程工具如何管用量:让 Token 成本可归属的三项核心指标
随着 AI 编程 CLI、IDE 和 Agent 在团队中快速增加,管理者很快会遇到一个比采购更棘手的问题:费用产生了,却难以准确回答由谁使用、归属哪个项目,以及投入是否带来了有效产出。要让预算审批和效能评估有据可依,首先需要建立统一的采集口径,并用一组可持续观测的指标连接使用行为、Token 消耗与研发结果。
团队里的 AI 编程工具从一个变成十个之后,管理成本往往先于研发收益显现。本文梳理用量治理的指标体系与平台化纳管的实现路径,供技术管理者参考。
一、工具多了之后,管理问题先暴露
过去一年,AI 编程工具在企业内部的渗透速度超出了多数 IT 部门的预期。行业调研数据显示,平均每个大型企业运行中的 AI 工具与 Agent 已超过 12 种;有企业披露在不到一年时间里,员工累计自建了 900 多个 Agent,彼此之间互不相通[1]。
工具数量本身不是问题,账算不清才是问题。到了月底对账时,管理员通常回答不了三个问题:谁在用、用了多少、产出值不值。
这个痛点已经大到工具厂商自己都在补课。9 月 16 日,GitHub Copilot 正式上线额度追加申请(budget increase requests)功能:成员额度耗尽后可以即时发起申请,请求自动路由到付费的组织或企业账户,由 Owner 或管理员逐笔审批[2]。此前额度耗尽即直接阻断使用。头部厂商把"用量审批流"做成正式功能,某种程度上说明 AI 编程工具已经进入按用量经营的阶段——仅按席位采购已经不足以覆盖实际消耗。
二、"怎么管"要回答的三个问题
治理的起点是可见性。没有统一的度量口径,审批流容易流于形式,成本预警也无从谈起。在实践中,用量治理可以收敛为三个关键指标。
| 指标类别 | 回答的问题 | 建议观测粒度 |
|---|---|---|
| 用量归属 | 谁在用、用在哪个项目 | 人 / 项目 / 会话 |
| 消耗结构 | 花了多少、花在哪 | 输入输出比、单任务 Token |
| 效能转化 | 投入值不值 | AI 代码占比、留存采纳率 |
三个指标对应三种管理动作:归属决定成本能否分摊到部门或项目;结构决定优化方向是收敛上下文还是调整模型;转化决定下一笔预算是否值得批。需要说明的是,三个指标必须建立在同一套采集口径上,否则跨团队对比会失去意义。
三、TitanIDE 平台化纳管的实现路径
把分散的工具收敛到统一入口,是让度量可落地的前提。常见的实现可以拆成三层。
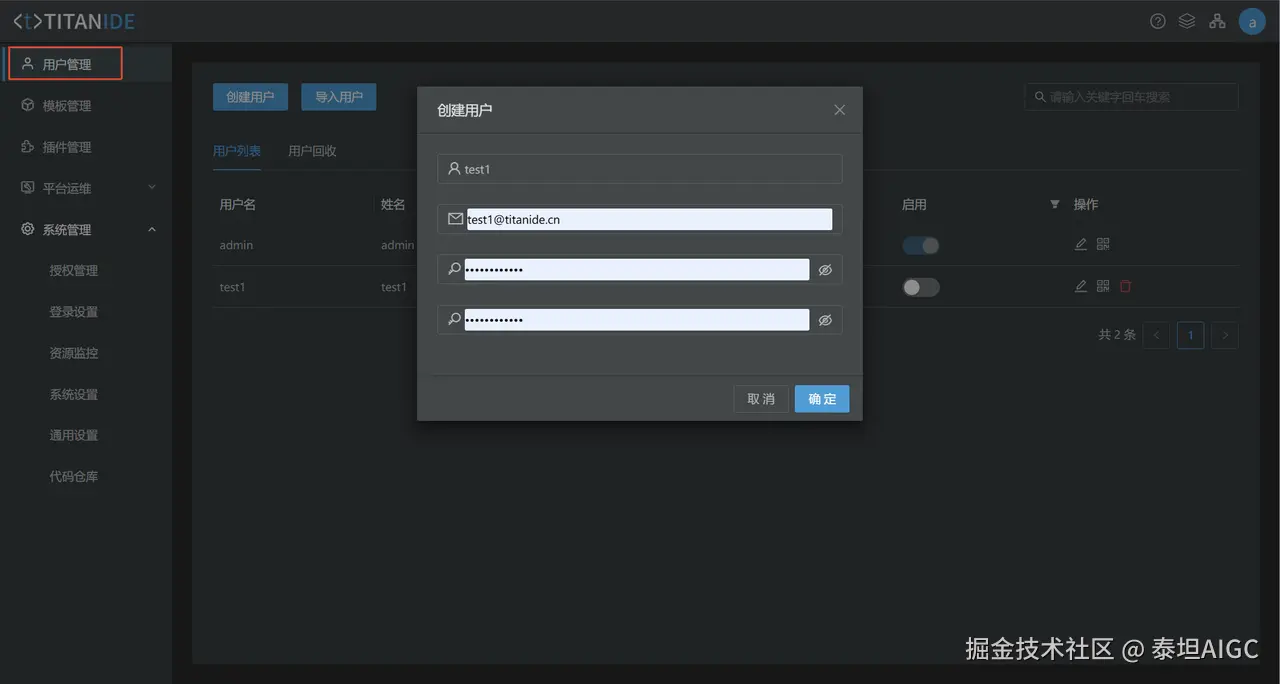
第一层:统一入口与模板化环境。 将主流 AI 编程 CLI(如 Claude Code、Qoder、OpenCode)与 AI IDE(如 Cursor、Trae)预置为云端模板,开发者从模板创建项目即可获得一致的运行时与依赖版本,避免"各装各的、版本漂移"。这一层解决的是采集前提:工具在受控环境内运行,度量数据才可被统一采集。
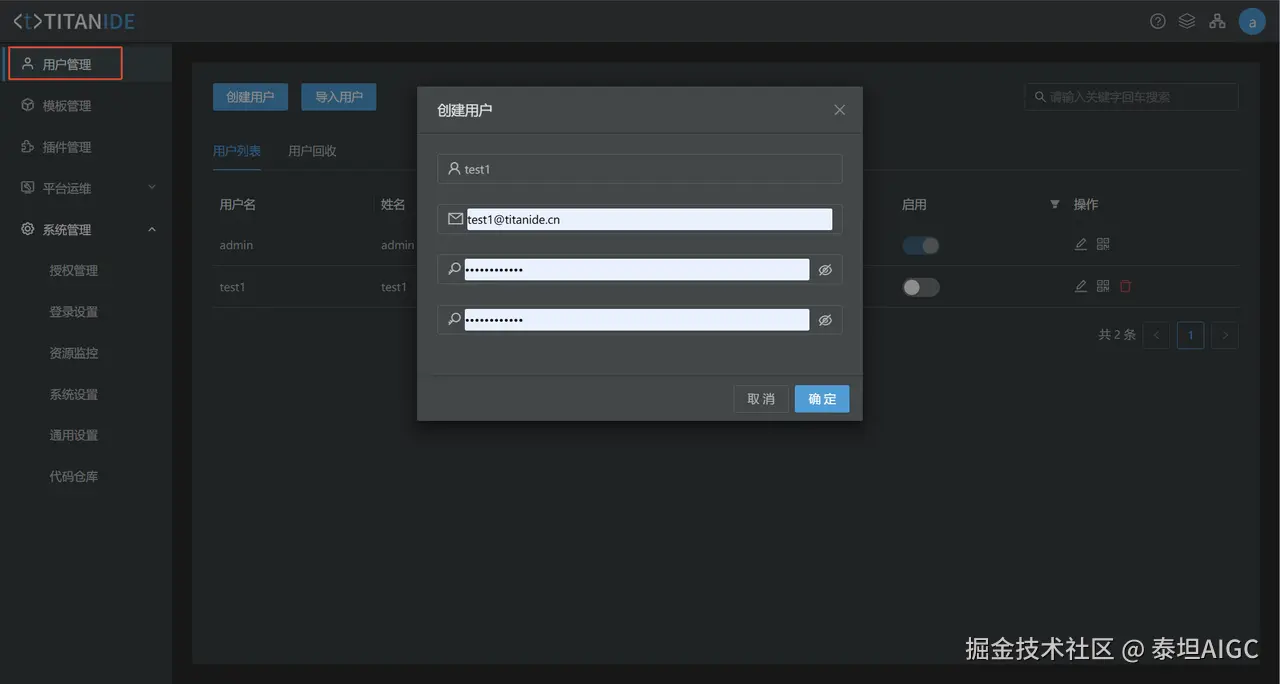
第二层:会话级度量。 以开发空间为根节点,树形展示项目及其下的 Agent 会话,实时活动流按时间倒序记录每次交互的时间戳、活动类型与内容摘要,并按会话维度下钻到活动量、时间分布、响应时长、异常记录、资源成本五个维度的分析报表。
编辑
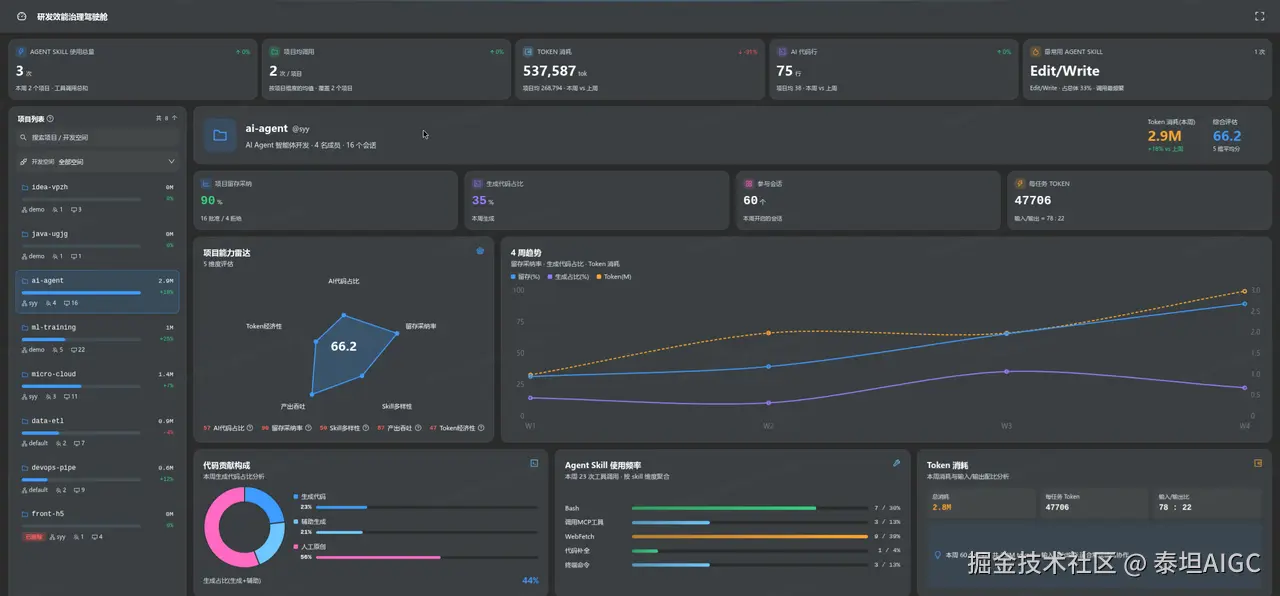
第三层:项目级效能评估。 在会话数据之上做项目粒度的聚合,从 AI 代码占比、留存采纳率、Skill 多样性、产出吞吐、Token 经济性五个维度给出综合评分,并提供 4 周趋势曲线,用于区分"偶发波动"与"持续劣化"。
编辑
上述三层能力的实现细节,可参考 TitanIDE 官方文档中的 Agent 管控台与研发效能驾驶舱章节[3],其中对指标定义与报表维度有更完整的说明。
四、TitanIDE的落地实践
如果团队正准备推进 AI 工具用量治理,以下四点建议来自实践中的常见踩坑:
- 先定义计量口径,再谈指标。 Token 是按请求计还是按会话累计、空转会话是否计入,口径不统一会让后续所有横向对比失效。
- 审批流绑定项目,而非个人。 额度与项目成本中心挂钩,能避免"额度批了但说不清花在哪"。
- 保留趋势数据,不要用单周波动做判断。 AI 用量天然存在任务型波峰,4 周以上的趋势才有参考价值。
- 环境模板化。 依赖与工具版本可追溯,是度量数据可比的前提。
TitanIDE 用量治理的目标不是限制开发者使用 AI,而是让每一笔 AI 投入都能够被解释——这既是成本管理的要求,也是后续扩容申请的重要依据。
参考资料
[1] The AEC Industry Never Learns(企业 AI 工具与 Agent 蔓延数据):The AEC Industry Never Learns
[2] AI Coding Roundup — September 17, 2026(GitHub Copilot 额度申请 GA):AI Coding Roundup: Claude Code 2.1.274 Ships Fixes | Oday Bakkour
[3] TitanIDE 官方文档(Agent 管控台、研发效能驾驶舱):TitanIDE Docs