两台机器部署 vLLM:何时需要接入 Ray?
当 vLLM 推理服务从单机扩展到两台 GPU 服务器时,团队很容易把 Ray 当成多机部署的默认答案。但机器数量并不是充分条件,后端选择还取决于资源是否固定、调度能力由谁提供,以及服务失败后如何重建。要做出可靠判断,需要先分清 multiprocessing 与 Ray 分别承担哪些职责。
两台机器跑 vLLM,什么时候才值得引入 Ray?
一套 vLLM 服务从一台机器搬到两台机器,部署方案里往往会顺手加上 Ray。理由也很直接:multiprocessing 管本机,Ray 管多机。
这个判断会让团队过早更换运行时。vLLM v0.28.0 已提供多节点 multiprocessing 路径。真正需要重新作出的决定是:这组 GPU 已经由现有平台分配好了,还是需要一个运行时在共享资源池里,为整组推理 Worker 找到位置?
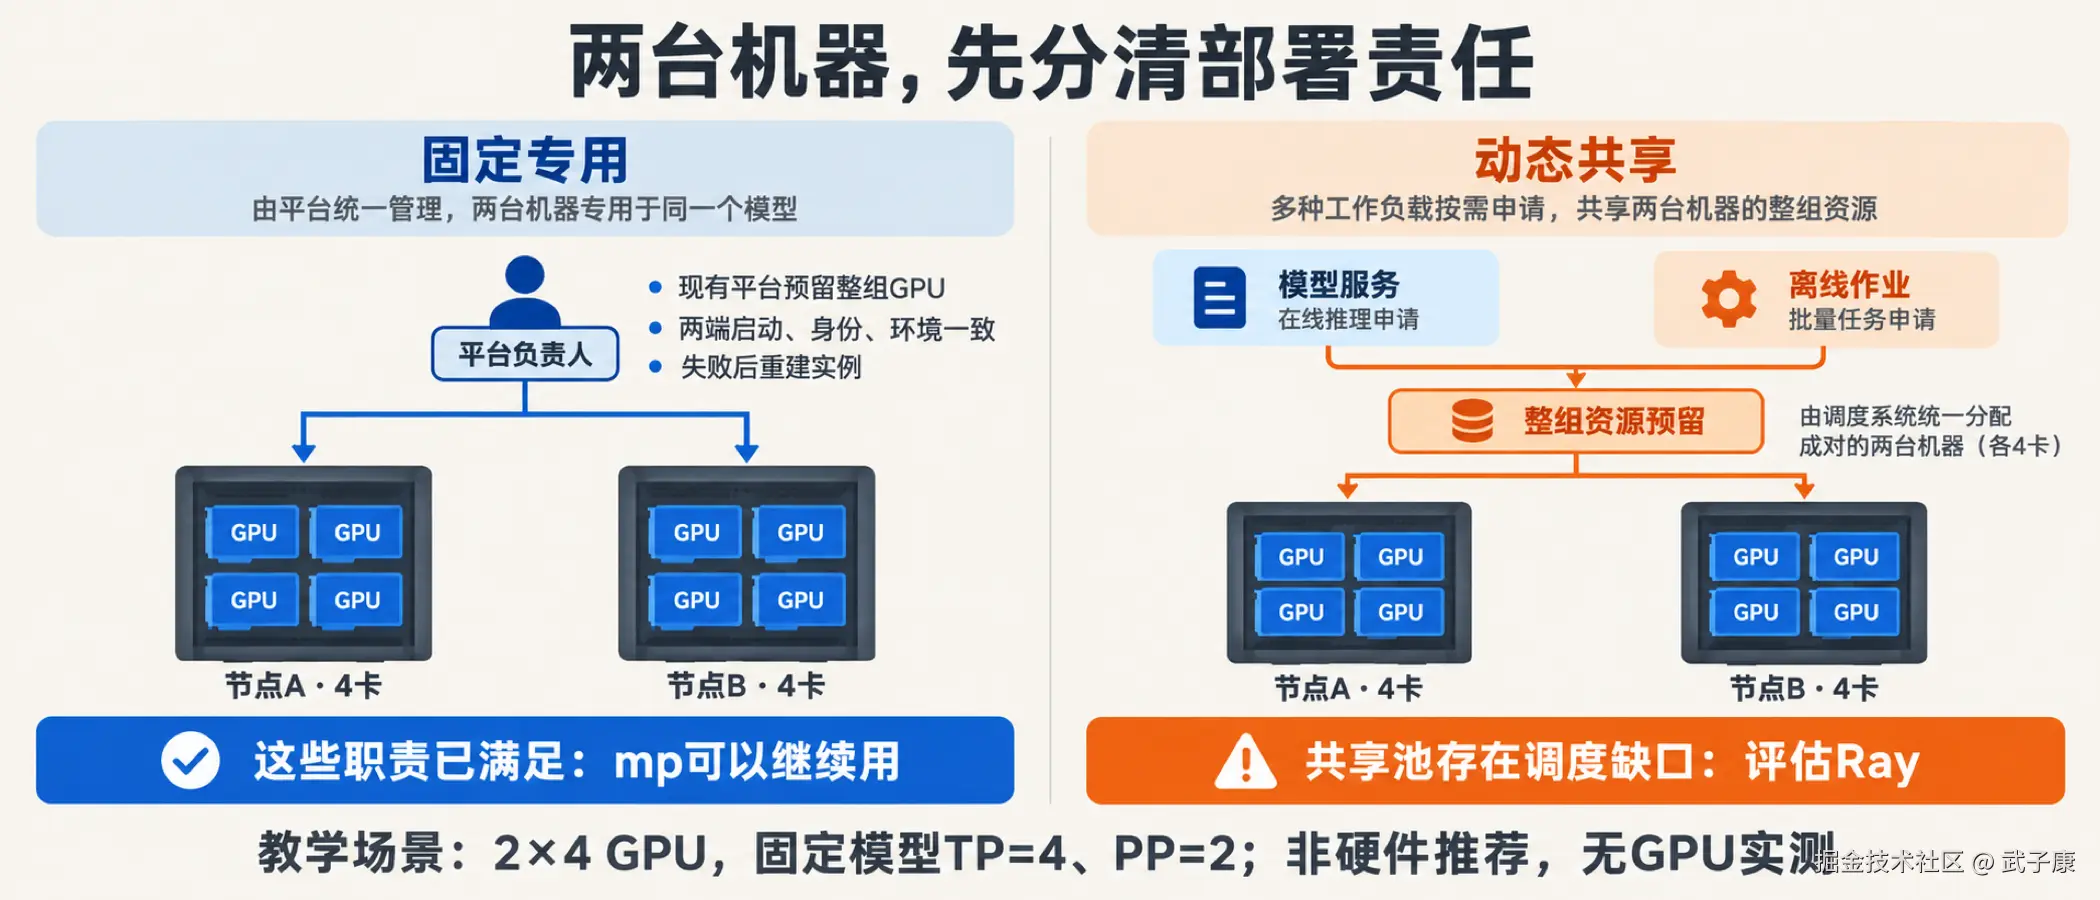
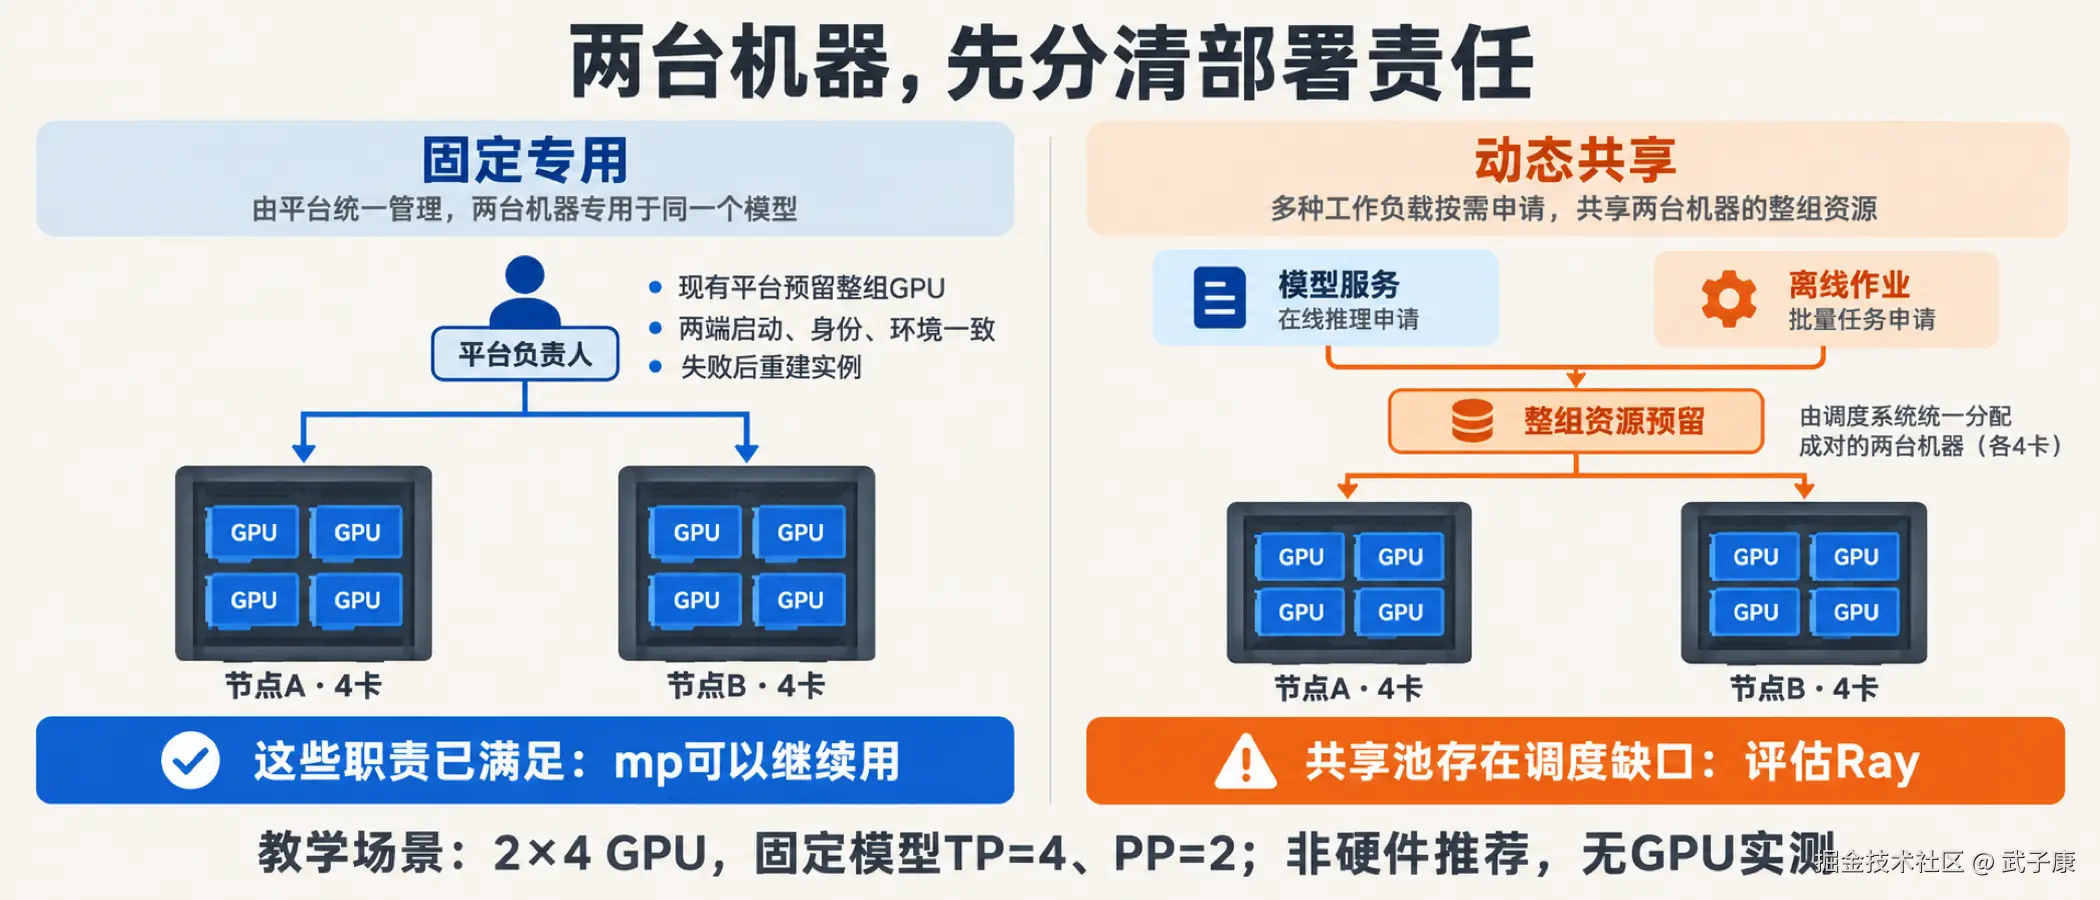
假设我们有两台各 4 卡的 CUDA 服务器,运行一个固定模型副本,采用 TP=4、PP=2:每台机器内部做张量并行,两台之间做流水线并行。模型、精度、上下文长度和网络均假定已经满足运行条件。这是用于比较部署责任的教学场景,不是硬件推荐,也没有对应的 GPU 实测。
同样是这 8 张卡,固定专用与动态共享,会得到不同的后端选择。
两台机器,仍然可以是一组固定进程
v0.28.0 官方部署页同时给出了 Ray 和多节点 mp 的启动方式。多节点 mp 示例在两端分别启动 vLLM,通过 --nnodes、--node-rank 和 --master-addr 组织进程;非主节点使用 --headless。官方示例采用每节点 8 卡、TP=8、PP=2,与本文两台各 4 卡的假设不同。官方多节点 mp 示例
这说明跨机能力已经存在,但不意味着在第一台机器执行一次命令,第二台就会自动准备好。两端的启动、身份分配和环境一致性,仍要由部署脚本或现有作业平台负责。
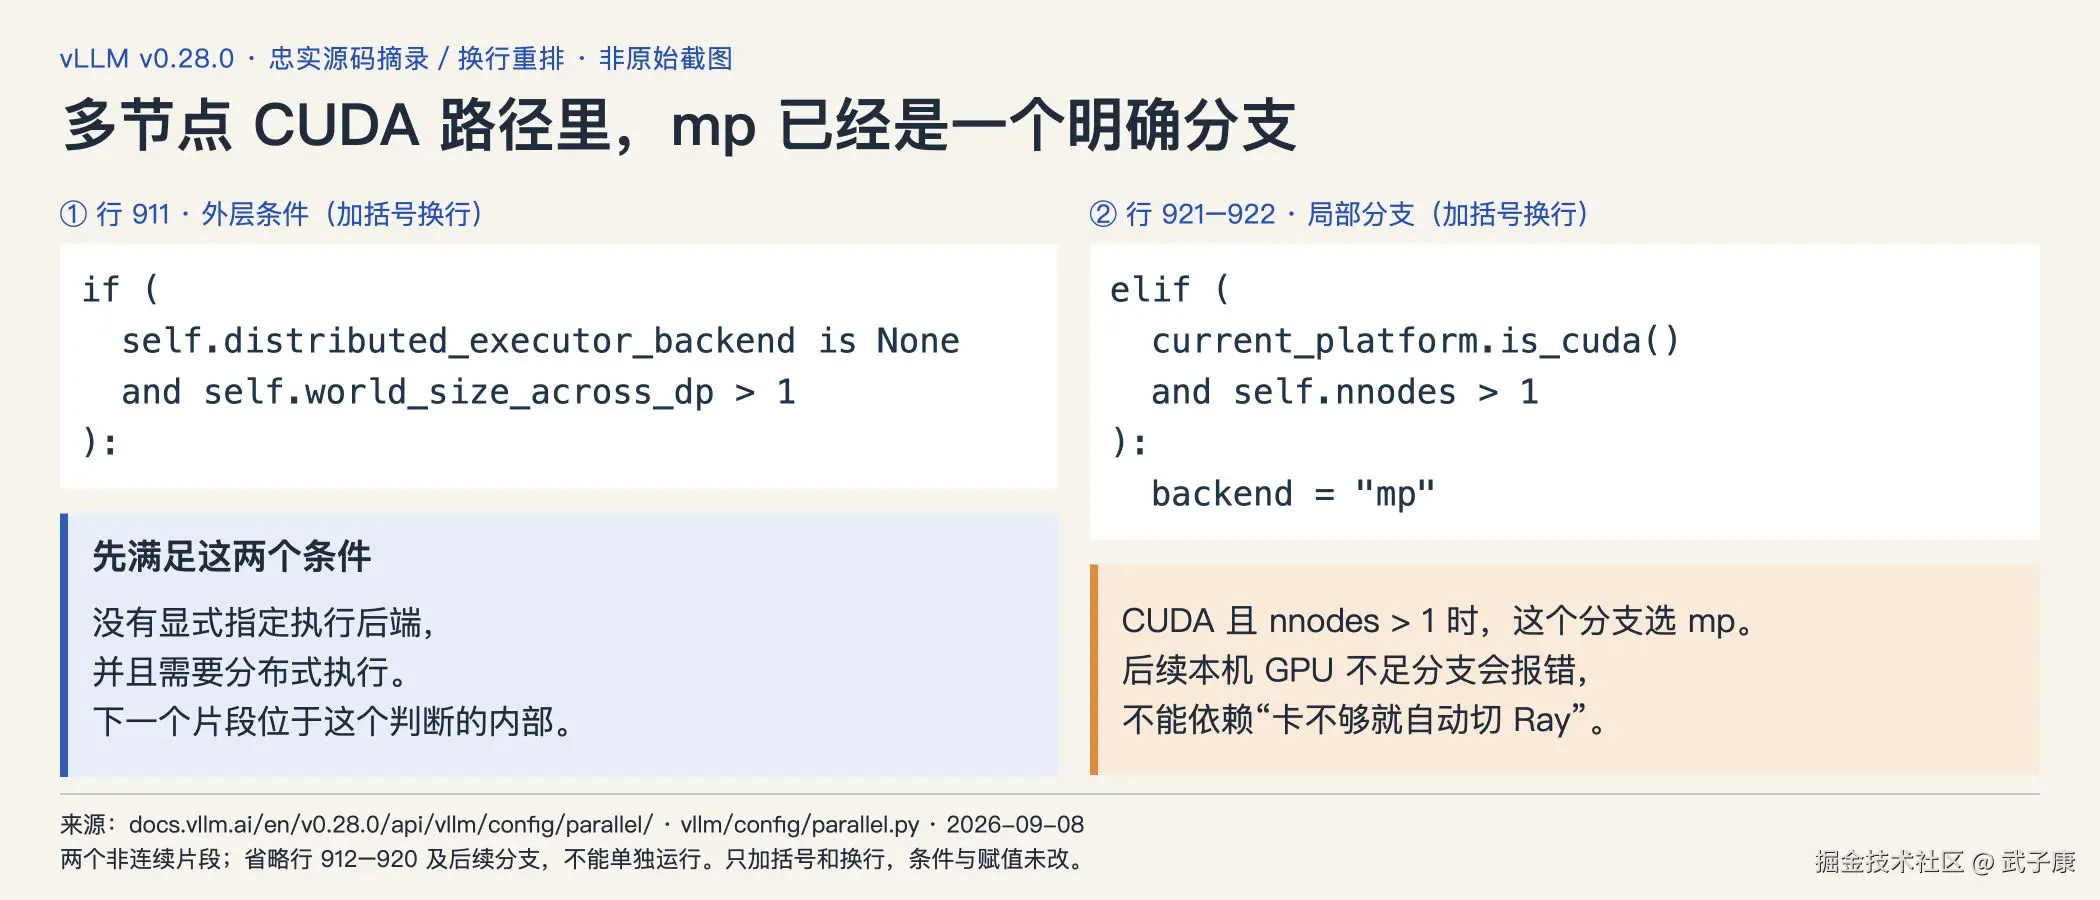
更容易踩错的是默认选择。v0.28.0 的 ParallelConfig 在未指定执行后端、需要分布式执行时,包含下面这段条件分支:
elif current_platform.is_cuda() and self.nnodes > 1:
    backend = "mp"
这是源码中的局部摘录,省略了前后的判断。紧接着的 CUDA 分支会在本机可用 GPU 少于所需 Worker 数、又没有通过前述多节点条件时抛错,提示显式选择 Ray,或为 mp 正确设置节点数。它不会看到本机装不下,就自动替你接入 Ray。v0.28.0 ParallelConfig 源码
因此,本文这个普通 CUDA、单模型副本场景,可以明确按 mp 配置两节点,而不是依靠旧文章里“多机自动用 Ray”的记忆。已经使用 Ray placement group、Ray 数据并行或其他平台的环境还有不同分支,不能把这两行当作完整默认规则。
选择 Ray 时也要换掉启动思路:先有可用的 Ray 集群,再由 vLLM 使用集群资源。不要把 mp 的 --nnodes 2 原样叠到 --distributed-executor-backend ray 上;该版本对 nnodes > 1 允许的后端有明确限制。后端与节点参数说明
如果现有平台已经能为作业保留两台机器、同时启动两端并在失败后重建实例,那么继续使用 mp 是一个有依据的选择。你省下的是一套额外运行时的维护;付出的则是必须把这几项跨机责任留在现有平台中。仅仅“机器变成两台”,不足以证明这笔交换值得做。
当 8 张卡开始被多个作业争用
现在改变一个条件:两台服务器不再专用。另一个模型可能占用其中两张卡,离线作业也会在空闲时提交。vLLM 副本仍要求整组资源才能启动。
此时缺口就具体了:谁负责让这个副本等到整组资源可用,再为它预留资源? 如果只写逐节点启动脚本,可能出现一端已经占卡等候,另一端却长期得不到资源的情形。这是共享池场景下需要防止的部署失败模式,并非所有 mp 部署必然如此;已有作业调度器也可能完成整组调度。
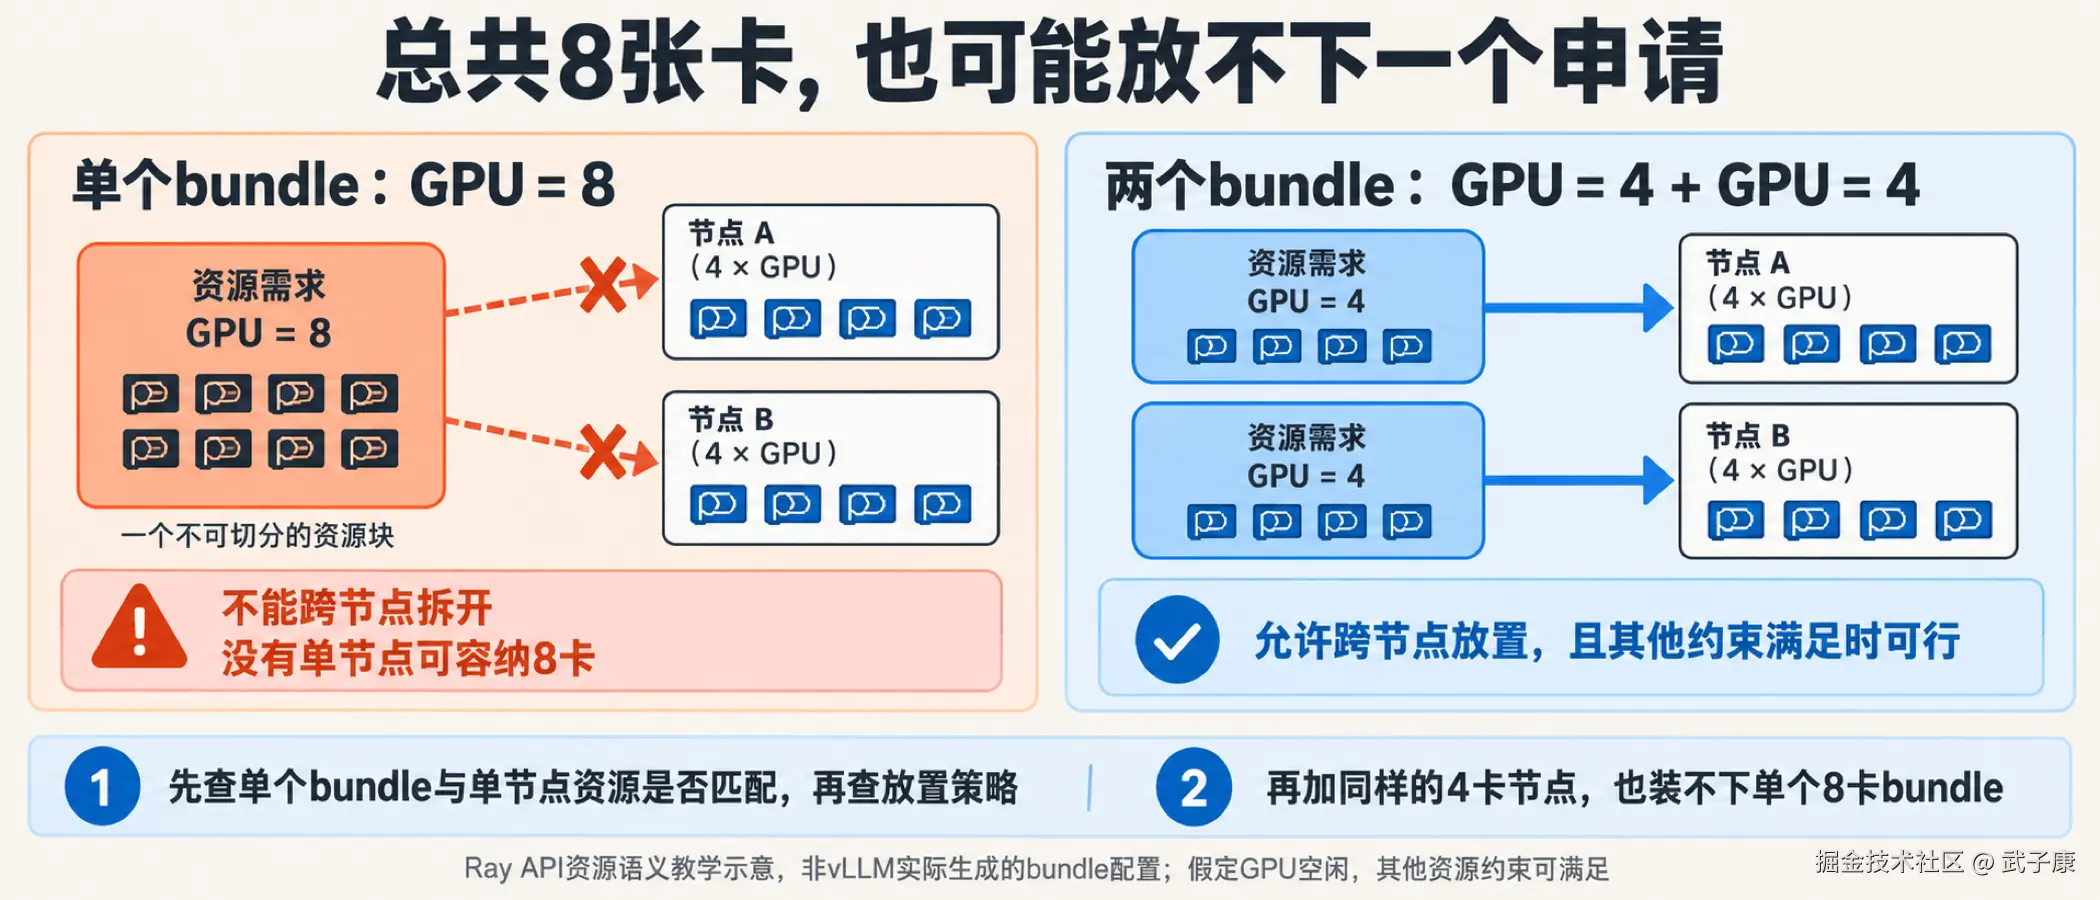
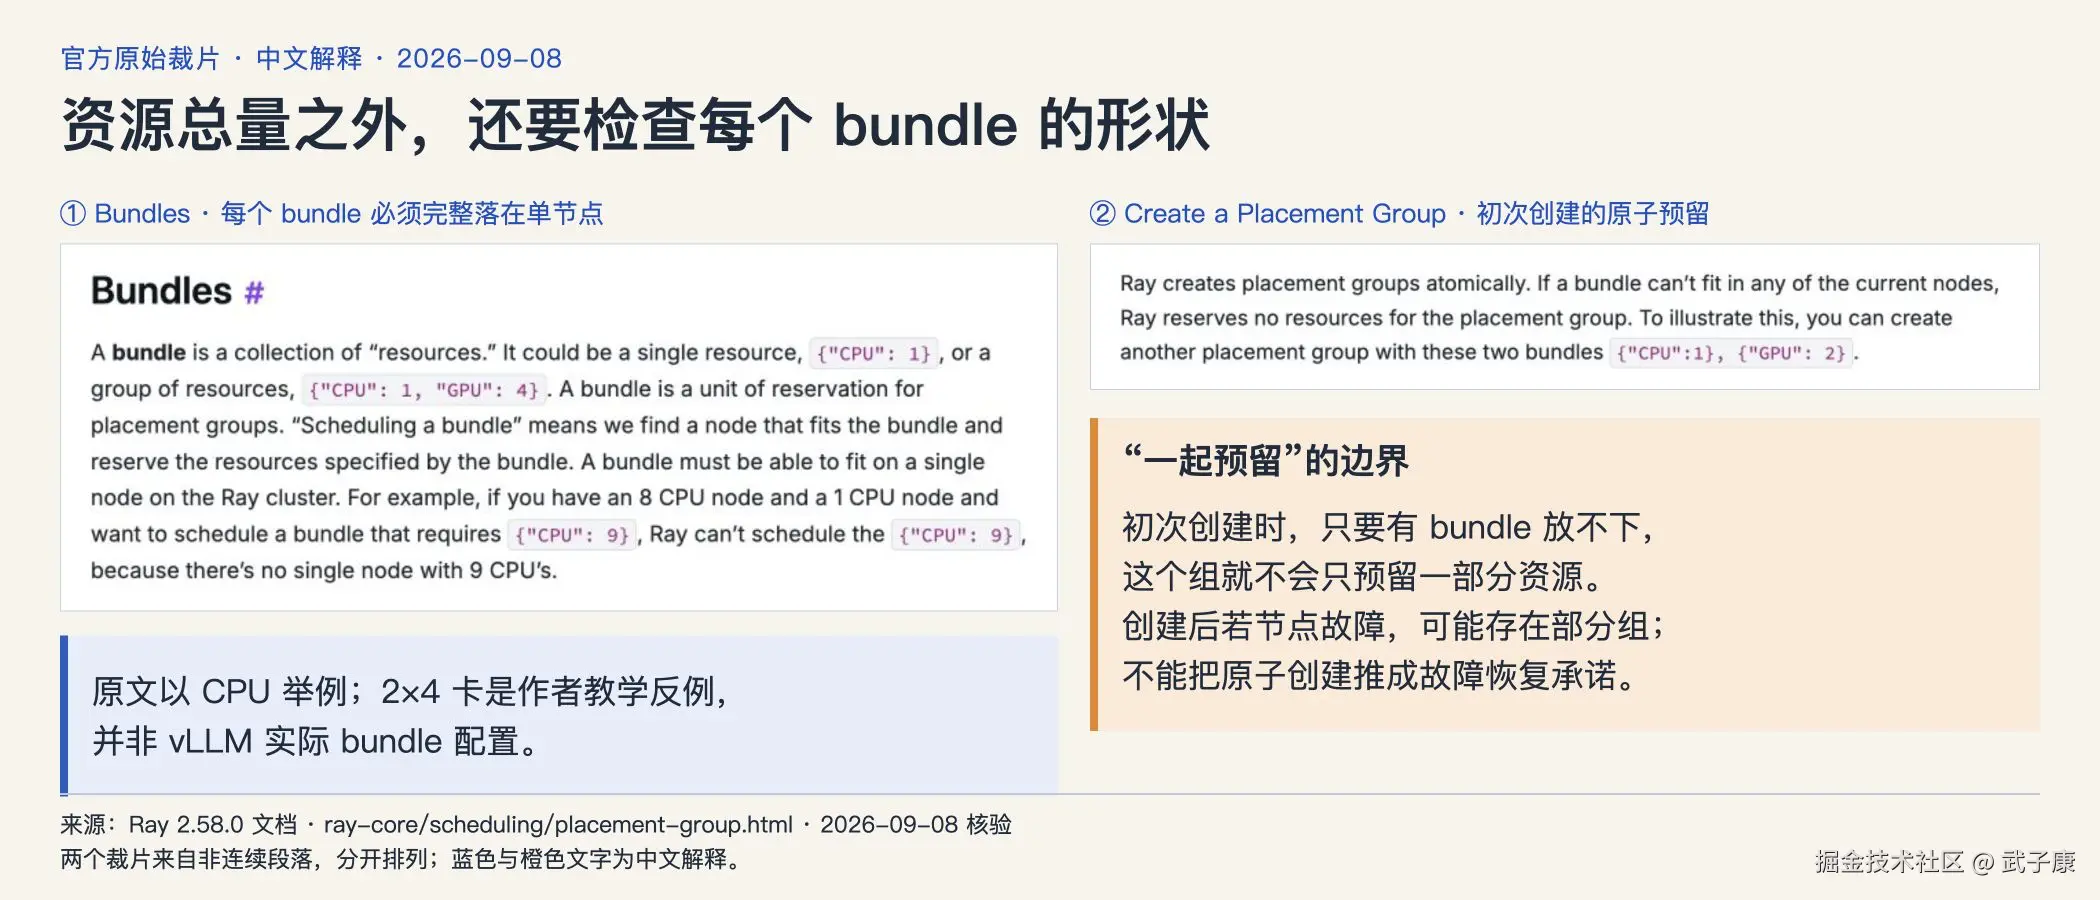
Ray 的 placement group 正好提供这种资源预留能力。它把一组需求作为整体调度,不能满足其中某个 bundle 时,不会只为这个组预留一部分资源。这里的 bundle 是一次不可跨节点拆开的资源申请。
官方文档有一句非常关键的限制:
A bundle must be able to fit on a single node on the Ray cluster.
也就是说,集群总量够用,仍可能无法满足资源形状。Ray placement group 的 bundle 与原子预留规则
用本文的两台各 4 卡做一个 Ray API 层的反例。假定 GPU 都空闲,其他资源和放置约束均可满足:
| 教学用资源申请 | 两台各 4 卡能否容纳 | 原因 |
|---|---|---|
一个 {"GPU": 8} bundle | 不能 | 没有任何单节点容纳 8 卡 |
两个 {"GPU": 4} bundle | 在允许分散到两节点的策略下可以 | 每个 bundle 能完整落在一台机器 |
这两行用于解释 Ray 的资源语义,不是 vLLM 实际生成 bundle 的配置示例,更不是让读者把它们直接粘进启动命令。真正部署时,要看目标版本生成或继承了什么 placement group、Worker 绑定到了哪个 bundle。v0.28.0 的 Ray Executor 会为 Worker 设置带有具体 bundle 索引的调度策略,然后创建 Ray Worker Actor。vLLM Ray Executor 源码
这个区别直接改变排障动作。组一直等待时,先检查每个 bundle 与单节点可用资源、放置约束是否匹配;只盯着集群 GPU 总数,甚至继续增加同样的 4 卡节点,也无法满足那个单个 8 卡 bundle。
Ray 在这里带来的收益是减少自建资源发现与整组预留逻辑。若现有平台已经可靠提供这些能力,它的新增价值就会缩小;若团队的多个工作负载本来就在 Ray 上运行,沿用同一套资源管理更有理由。
资源安排好了,服务责任还没有消失
把 Worker 放进去,只解决了启动所需的一部分条件。
Ray 的 GPU 资源是调度用的逻辑资源;它通过可见设备设置帮助进程使用分配到的 GPU。这个机制不等于按申请数字隔离显存容量。把一张 GPU 逻辑上分给多个进程,并不能据此证明模型权重和运行状态都放得下。Ray 逻辑资源与物理资源
同样,换成 Ray 后端也没有消除 GPU 通信。v0.28.0 Ray Executor 的编译图通信路径中,仍能看到 NCCL 通道以及对 vLLM 流水线通信组的封装。具体数据路径取决于配置,不能简单说 Ray 完全不参与张量传输;但也不能说它替代了 NCCL,或据此承诺推理更快。Ray Executor 通信实现
另一个常被顺带许诺的能力是“以后自动扩缩容”。执行后端只说明 Worker 由什么运行时承载。Ray Serve 的副本扩缩容、Ray 集群的节点扩缩容是另外的配置与控制过程:前者决定服务副本数量,资源不足时还需要后者补足节点。仅把后端改成 ray,没有完成这些服务配置。Ray Serve 扩缩容说明
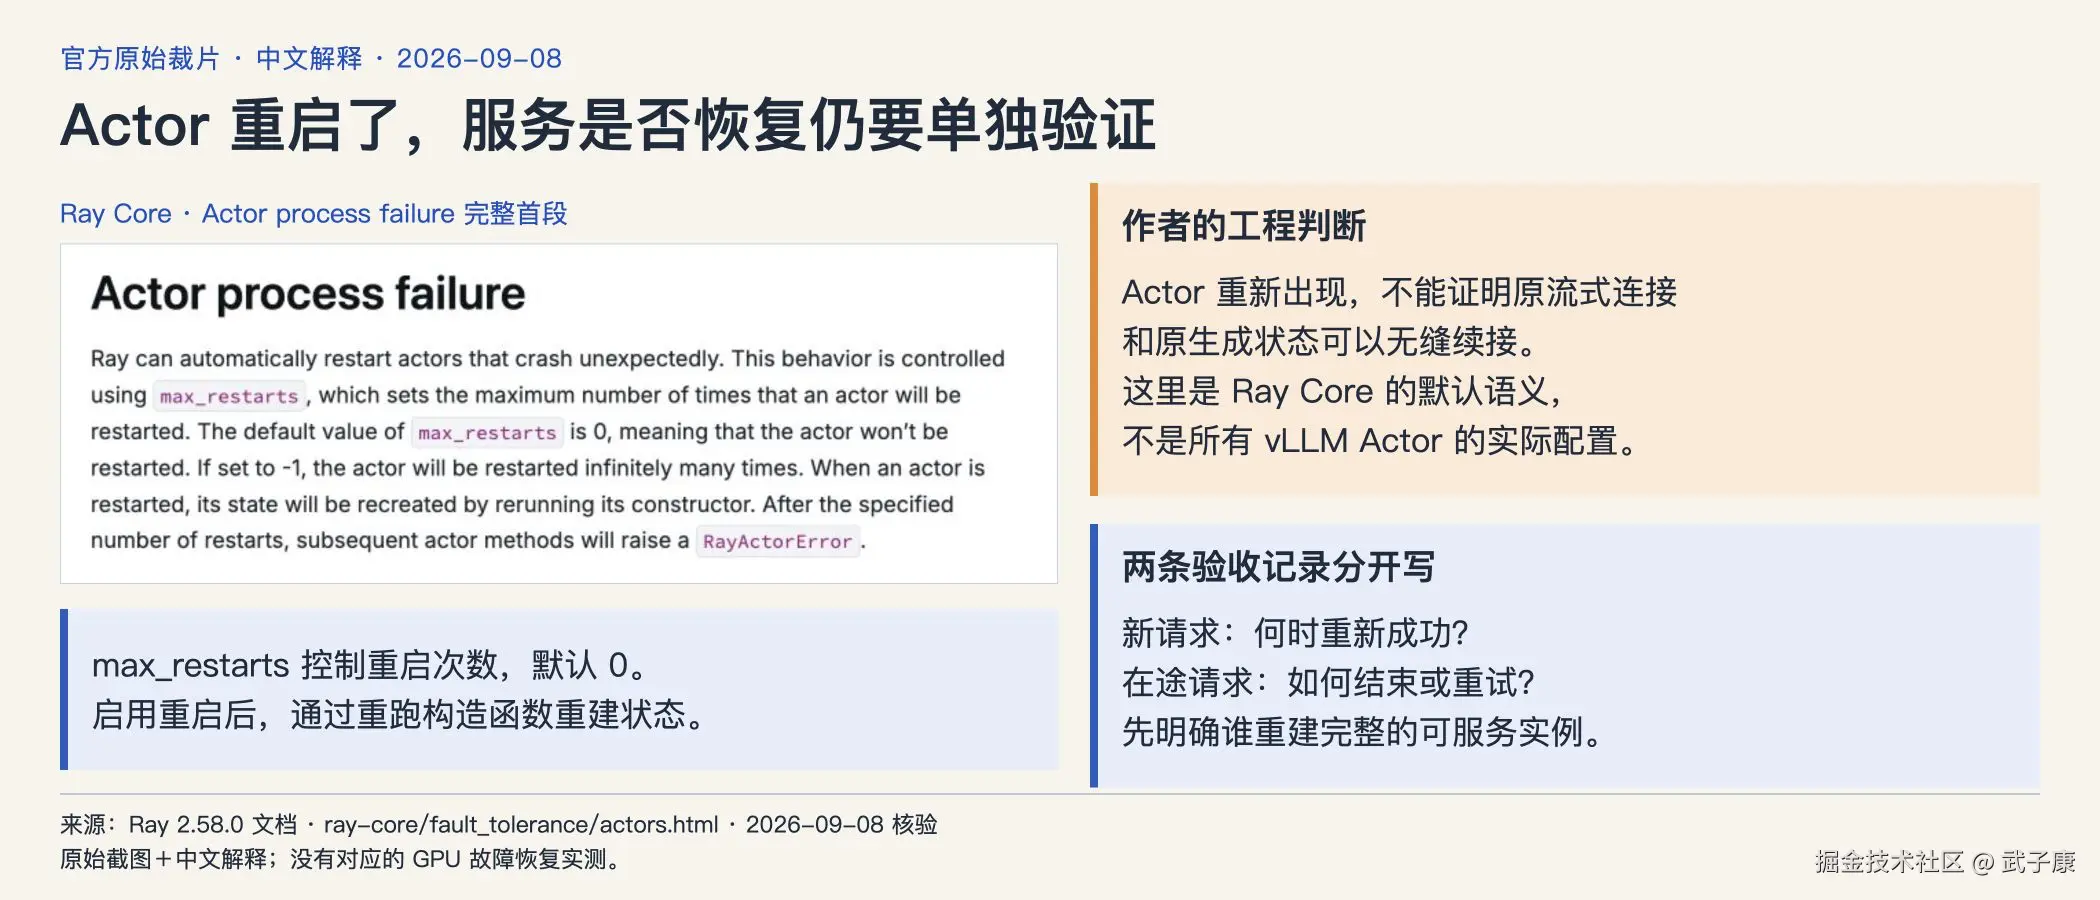
故障恢复也需要单独验收。Ray Core 文档说明,Actor 的自动重启由 max_restarts 控制,默认是 0;即使启用重启,状态也是通过重新执行构造函数建立。它不是恢复任意业务内存的承诺。Ray Actor 故障语义
由此作出的工程判断是:不要把“Actor 重新出现”作为“流式请求恢复”的验收结果。对于跨多个 Worker 的推理副本,应实际验证 Worker 失败后由谁重建可服务的实例,以及已发出部分文本的请求怎样结束或重试。没有这项证据,就不能承诺原连接和原生成状态能无缝续接。
这些限制不是否定 Ray。它们帮助团队把迁移收益写准确:解决整组资源放置,就验收整组资源放置;需要服务副本恢复,就另外实现并验证恢复。
用一张部署决策记录结束争论
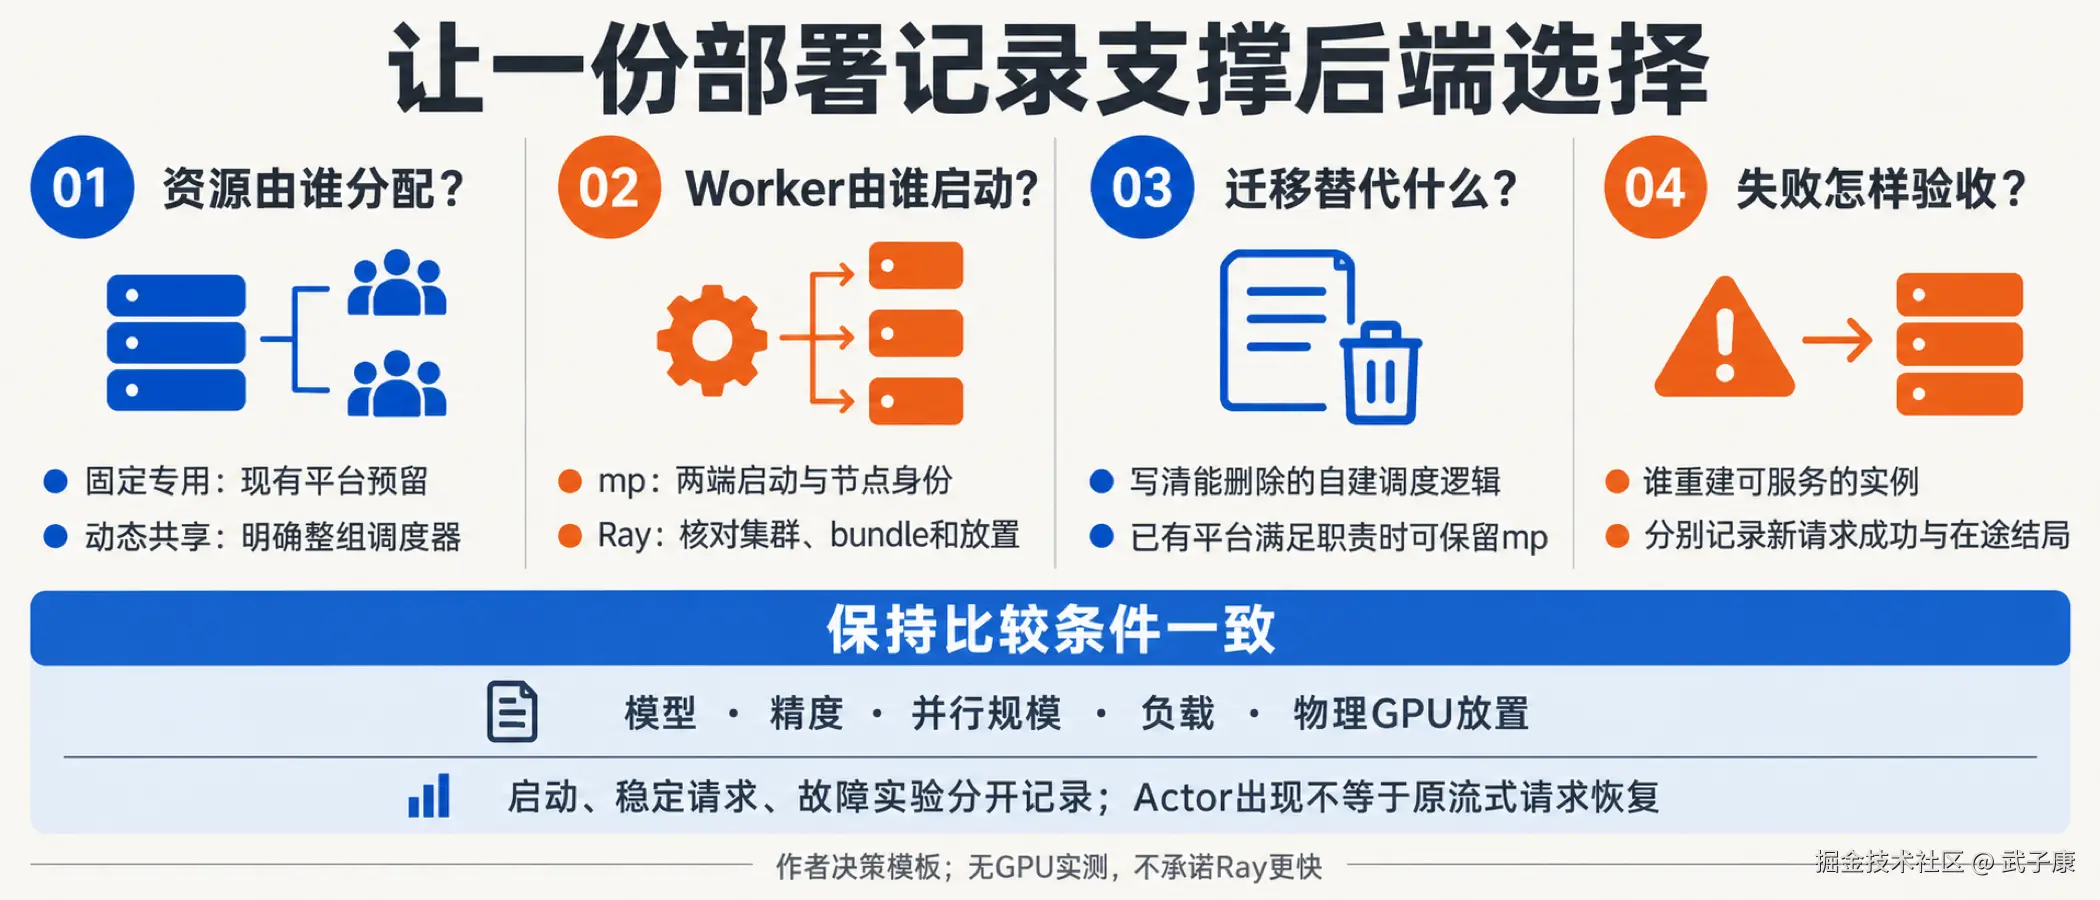
回到两台各 4 卡的场景。可以把选择写成下面这份记录,交给实际维护这套服务的人逐项填实,而不是继续争论哪个后端更“生产级”。
| 要记录的事实 | 固定专用两节点 | 动态共享资源池 |
|---|---|---|
| GPU 由谁分配给这个副本 | 现有平台预留整组 GPU | 指定负责整组预留的调度器;Ray placement group 是一个候选 |
| 谁启动并组织 Worker | 明确两端启动、节点身份与统一配置的负责人,mp 可用 | 核对 Ray 集群、实际 bundle 与 Worker 放置 |
| 采用 Ray 的具体收益 | 若当前职责已被满足,暂不迁移 | 写清能删除哪部分自建调度逻辑,或如何复用已有 Ray 环境 |
| 失败后如何重新接流量 | 指定实例重建与请求失败处理 | 同样要指定,不能以 Actor 状态代替服务可用性 |
| 如何证明选择成立 | 保存启动、请求完成和故障恢复记录 | 在相同记录上增加资源等待与放置证据 |
这是部署决策的记录模板,不是已经完成的测试结果。
若决定评估 Ray,先保持模型、精度、并行规模、请求输入和物理 GPU 放置尽量一致,再比较启动至可服务的耗时、稳定请求的首 token 延迟与 token 间隔、完成率。故障实验单独进行,记录从 Worker 失败到新请求成功的时间,以及在途请求的结局。测量值和业务接受阈值都需要由实际环境提供,本文没有填入虚构结果。
若 Ray 测试时恰好把 Worker 放到不同节点或不同 GPU 拓扑,性能变化就不能全部归因于后端。若同时接入 Serve 和节点扩缩容,则应拆开验证新增环节,否则一次波动很难判断来自哪里。
最后真正要落笔的,是一句能被验证的选择理由。例如:“继续用 mp,因为现有平台已经完成两节点预留、启动和实例重建”;或者“接入 Ray,因为共享池的整组预留目前由我们手写,试验已证明它可以替代这部分逻辑”。两句话都比“现在有两台机器了”更能支撑部署决定。