通用 LLM 流式对话:前后端完整链路实现
在大模型对话应用中,真正影响交互体验的不只是模型响应质量,还包括内容能否及时、稳定地呈现在页面上。要实现逐段输出,需要前端持续解析数据流,后端维护 SSE 连接,并同步处理状态、Token 统计与会话记录。下面将从一次完整请求出发,拆解这条前后端通信链路。
前言
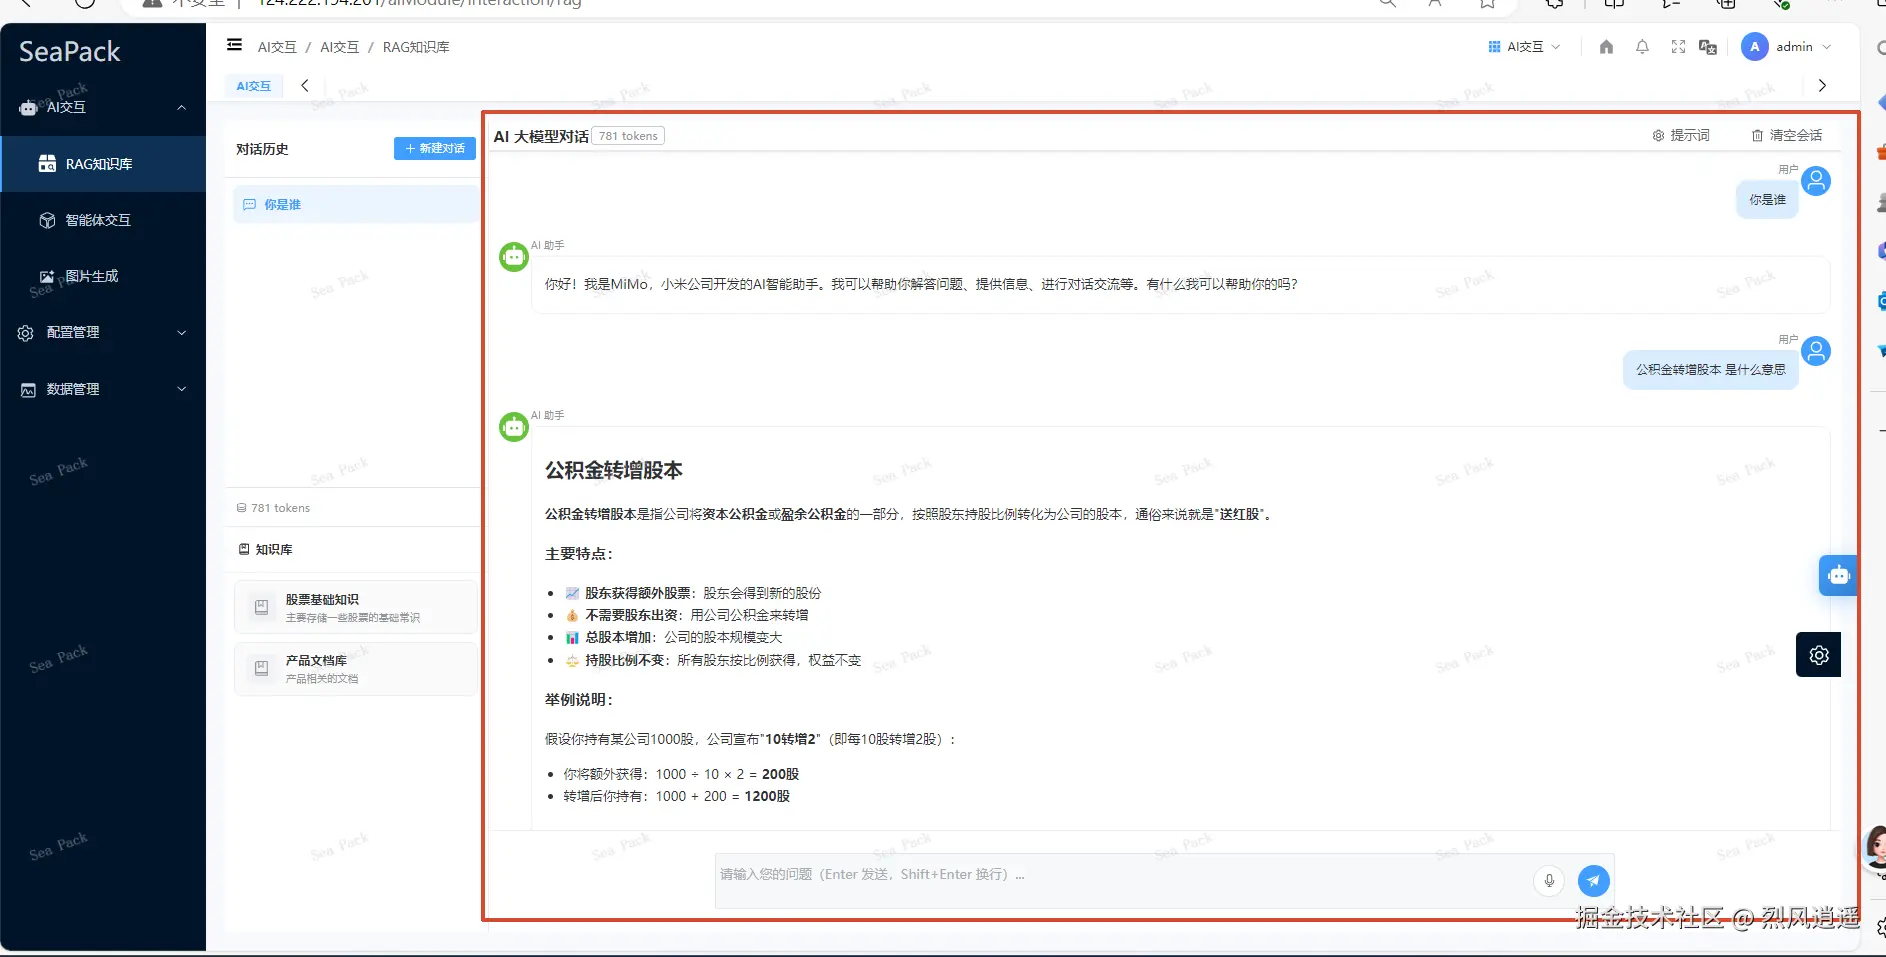
本文是 SeaPack 项目技术系列的第五篇,聚焦 通用 LLM 流式对话模式——这是三种对话模式中最基础、最纯净的一种:前端发消息,后端直连 LLM,逐 token 流式返回。不涉及知识库检索、不涉及技能调用、不涉及提示词模板——纯粹的「人 → 大模型 → 人」。
访问地址:http://124.222.194.201/
前端代码:github.com/seapack-hub…
后端代码:github.com/seapack-hub…
前置文章:
SSE(Server-Sent Event) 介绍前言 一、SSE 是什么?有什么作用? SSE 基于 HTTP 协议 - 掘金 (juejin.cn)
为什么流式加载大模型API接口需要使用Fetch前言 大模型流式返回选择 fetch + ReadableStream - 掘金 (juejin.cn)
AI大模型中fetch 和 ReadableStream为啥一起出现下面从 fetch 和 ReadableStream - 掘金 (juejin.cn)
一、为什么单独讲「通用对话」
三种对话模式中,通用对话的代码路径最短、依赖最少,但它承担了两个重要职责:
- 理解全链路基础设施——SSE 事件协议、Token 统计、取消机制、会话落库,这些在 Agent/编排模式中复用的基础设施,在通用对话中第一次亮相,代码路径最清晰。
- 理解前端通信骨架——
fetch + ReadableStream → buffer 切行 → JSON 解析 → Composable 分发 → Store 更新 → 视图渲染,这条链路是所有对话模式共享的前端管道。
把通用对话讲透了,后面 Agent 和编排模式只需要关注「多了什么步骤」,不用重新理解基础机制。
二、整体架构:一次对话从头到尾
┌─────────────────────────────────────────────────────────────────────────────┐
│                          前端(Vue 3 + TypeScript)                          │
│                                                                             │
│  ChatInterface.vue  →  useChatExecution.ts  →  [email protected]               │
│  (UI 输入/展示)        (Composable 调度)       (SSE 流式读取器)               │
│                                                                             │
│  ┌─────────────────────────────────────────────────────────────────────┐     │
│  │  ch@tStore (Pinia)                                                  │     │
│  │  · sessions[] 多会话管理        · getContextMessages() 上下文裁剪     │     │
│  │  · addMessage / updateLastMessage  · setLastMessageTokens           │     │
│  └─────────────────────────────────────────────────────────────────────┘     │
└────────────────────────────────┬────────────────────────────────────────────┘
                                 │ fetch + POST /api/ai/dialog/stream
                                 │ Content-Type: application/json
                                 │ Authorization: Bearer <token>
                                 ▼
┌─────────────────────────────────────────────────────────────────────────────┐
│                          后端(Spring Boot)                                 │
│                                                                             │
│  AiDialogController.stream()          → 创建 SseEmitter,提交异步线程         │
│      │                                                                       │
│      ▼                                                                       │
│  AiDialogService.handleStream()       → Token 额度校验 → 按 mode 分发         │
│      │                                                                       │
│      ▼                                                                       │
│  AiDialogService.handleLlmStream()    → 核心:构建请求 → 流式调用 → 落库       │
│      │                                                                       │
│      ├──→ AiProviderIdentities.get()  → 注入模型身份 system prompt            │
│      ├──→ LlmSseHelper.createConnection()  → HttpURLConnection POST          │
│      ├──→ LlmSseHelper.readChunks()        → 逐 chunk 回调                   │
│      ├──→ SseEvent.send()             → 向前端推送事件                       │
│      ├──→ TokenStatsService.recordCall()  → 写入 token_usage_log            │
│      └──→ saveLlmSession()            → 异步保存执行记录                     │
└─────────────────────────────────────────────────────────────────────────────┘
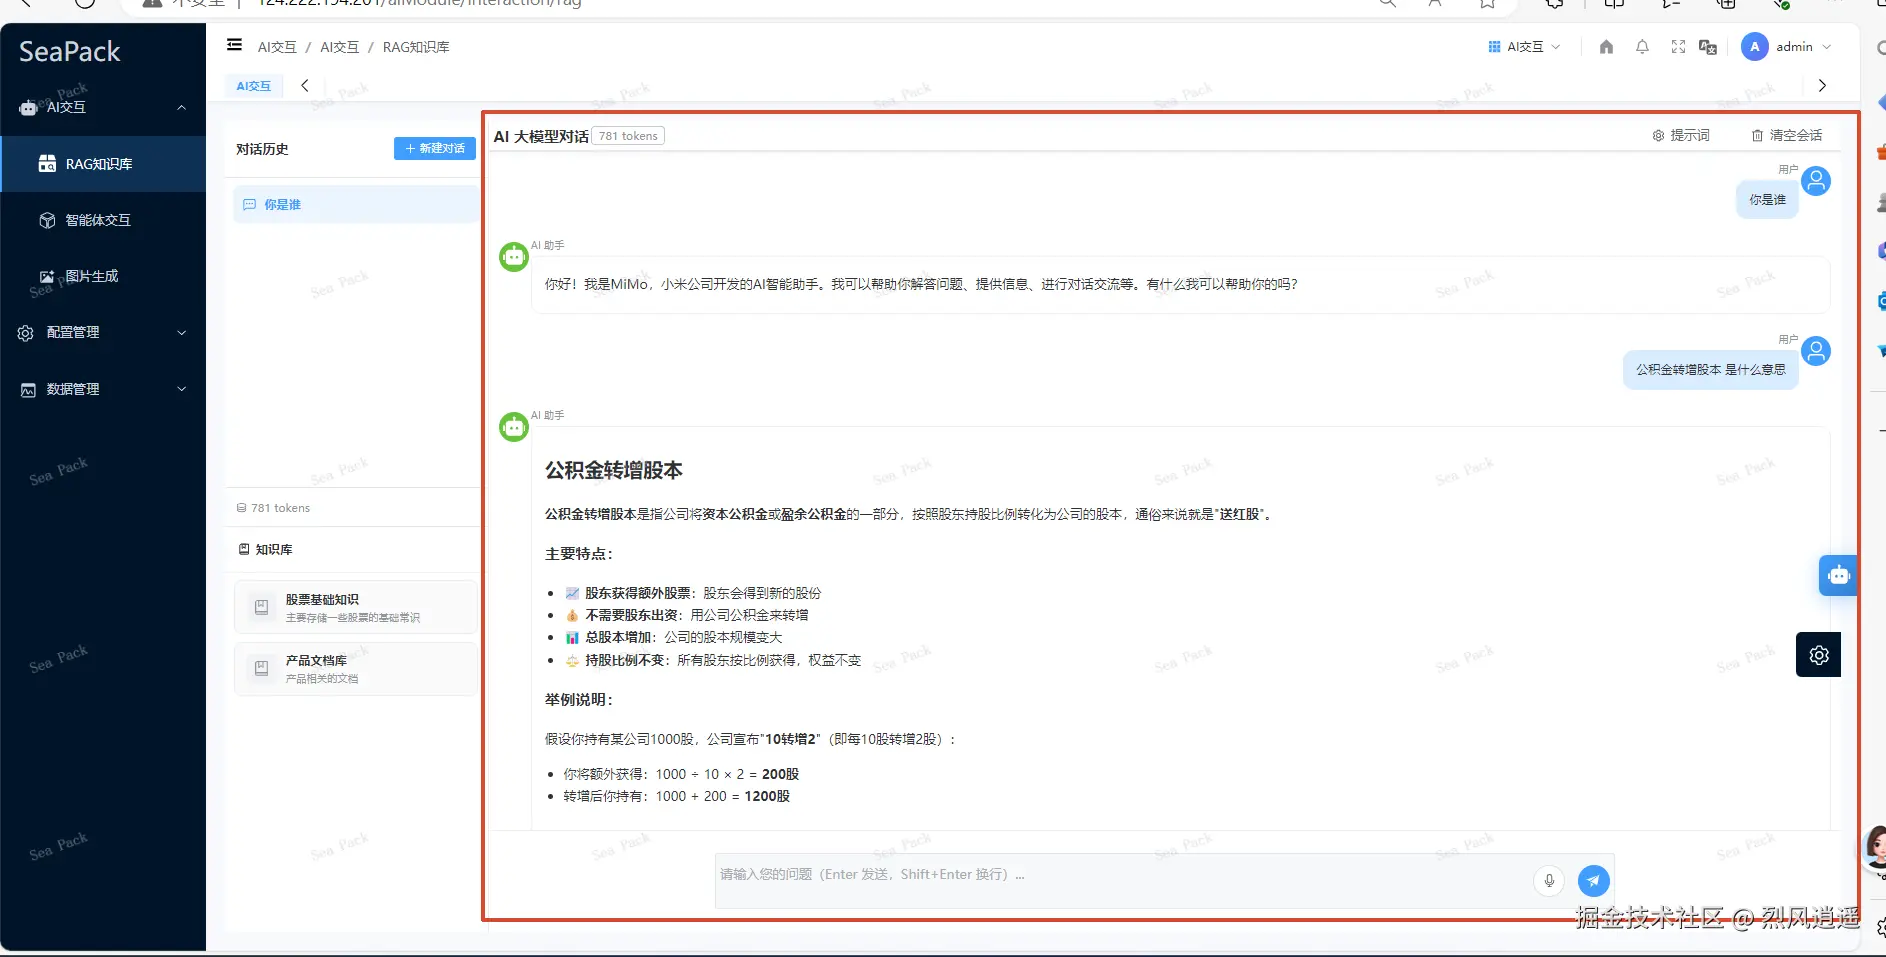
三、前端 UI 层:ChatInterface.vue
ChatInterface.vue 是对话界面的核心组件,包含三个区域:消息列表、输入区域、系统提示词设置。
3.1 消息列表——气泡式展示
AI 回复用 Markdown 渲染,用户消息纯文本展示:
<div v-for="(msg, index) in store.messages" :key="index">
  <!-- 用户消息:右对齐 -->
  <div v-if="msg.role === 'user'" class="msg-bubble user">
    {{ msg.content }}
  </div>
  <!-- AI 消息:左对齐,Markdown 渲染 -->
  <div v-else class="markdown-body msg-bubble assistant"
       v-html="renderMarkdown(msg.content)" />
  <!-- 流式指示器:loading 时显示"正在生成..." -->
  <span v-if="msg.role === 'assistant' && store.loading"
        class="streaming-indicator">正在生成...</span>
</div>
Markdown 渲染使用 markdown-it 库,配置了 html: false(禁止 HTML 标签,防 XSS):
const md = new MarkdownIt({ html: false, linkify: true, typographer: true });
function renderMarkdown(text: string): string {
  return md.render(text);
}
3.2 输入区域——发送与语音
支持 Enter 发送、Shift+Enter 换行,loading 时禁用输入:
<el-input v-model="inputText"
  type="textarea" :rows="3"
  :autosize="{ minRows: 2, maxRows: 8 }"
  placeholder="请输入您的问题(Enter 发送,Shift+Enter 换行)..."
  :disabled="store.loading"
  @keyup.enter="handleEnter" />
handleSend() 是发送的核心入口:
async function handleSend() {
  const text = inputText.value.trim()
  if (!text || store.loading) return

  store.addMessage({ role: 'user', content: text })
  inputText.value = ''
  store.loading = true
  store.addMessage({ role: 'assistant', content: '' })  // 预留空消息

  // 获取上下文消息(含 system prompt + 历史 + 当前问题)
  let contextMessages = store.getContextMessages()

  // 调用 LLM 流式对话
  await executeLlmStream(contextMessages, store.currentSession?.namespace || '', (event) => {
    if (event.type === 'content' && event.text) {
      store.updateLastMessage(event.text)  // 逐 token 追加
    } else if (event.type === 'done') {
      store.loading = false
      if (event.tokens) {
        store.setLastMessageTokens(event.tokens.prompt, event.tokens.completion)
      }
    } else if (event.type === 'error' && event.message) {
      store.updateLastMessage(`nn[错误: ${event.message}]`)
      store.loading = false
    }
  })
}
注意这里直接调用了 executeLlmStream——这是简化路径。在更复杂的场景中,会通过 useChatExecution composable 间接调用(见第五节)。
3.3 系统提示词设置
每个会话独立管理 system prompt,Popover 弹框编辑:
<el-popover placement="bottom-end" :width="400" trigger="click">
  <template #reference>
    <el-button text :icon="Setting">{{ systemPromptShort }}</el-button>
  </template>
  <el-input v-model="editSystemPrompt" type="textarea" :rows="6"
    placeholder="例如:你是一个专业的前端开发工程师..." />
  <div class="flex justify-end gap-2 mt-3">
    <el-button @click="resetSystemPrompt">恢复默认</el-button>
    <el-button type="primary" @click="saveSystemPrompt">保存</el-button>
  </div>
</el-popover>
3.4 自动滚动
使用 useAutoScroll composable,消息内容变化自动滚到底部:
// 最后一条消息的内容变化(流式响应时内容会持续更新)
watch(
  () => {
    const msgs = store.messages
    if (msgs.length === 0) return ''
    return msgs[msgs.length - 1].content
  },
  () => scrollToBottom()
)

//  loading 状态变化(流结束时确保滚动到底部)
watch(() => store.loading, (v) => { if (!v) scrollToBottom() })
useAutoScroll 的实现关键点:用户向上滚动时暂停自动滚动,滚动回底部时自动恢复——这避免了用户在阅读历史消息时被强制拉到底部。
四、前端状态管理:ChatStore 与上下文裁剪
[email protected] 是 Pinia Store,管理多会话的全生命周期。
4.1 会话数据结构
export interface Session {
  id: string                    // 会话唯一标识(UUID)
  conversationId: string        // 对话 ID(进入对话界面时生成,所有轮次共享)
  title: string                 // 会话标题(自动取第一条用户消息)
  messages: ChatMessage[]       // 消息列表
  systemPrompt: string          // 系统提示词
  namespace: string             // 绑定的知识库命名空间
  mode: 'llm' | 'scene'        // 对话模式
  sceneBinding: SceneBinding | null  // 场景绑定信息
  createdAt: number
  updatedAt: number
}
两个关键 ID 的区别:
| ID | 生成时机 | 生命周期 | 用途 |
|---|---|---|---|
conversationId | 进入对话界面时生成一次 | 整个会话期间不变 | 后端落库用,关联同一会话的所有轮次 |
requestId | 每次发送消息时生成 | 单轮对话 | 精确定位某一轮对话的执行记录 |
4.2 流式消息更新
核心方法 updateLastMessage——追加而不是覆盖:
function updateLastMessage(text: string) {
  const lastMsg = session.messages[session.messages.length - 1]
  if (lastMsg && lastMsg.role === 'assistant') {
    lastMsg.content += text  // 追加,不覆盖
  }
}
配合 ChatInterface.vue 中的 v-html="renderMarkdown(msg.content)",用户看到的是 AI 回复以 Markdown 渲染、逐字出现的效果。
4.3 上下文窗口管理
发送前自动裁剪上下文,防止 token 超限:
function getContextMessages(): ChatMessage[] {
  const allMessages = [
    { role: 'system', content: session.systemPrompt },
    ...session.messages,
  ]
  return trimContext(allMessages, 8000)  // 最大 8000 token
}
裁剪逻辑在 tokenCounter.ts:
export function trimContext(messages: ChatMessage[], maxTokens: number): ChatMessage[] {
  const systemMessages = messages.filter((m) => m.role === 'system')
  const normalMessages = messages.filter((m) => m.role !== 'system')

  let trimmed = [...normalMessages]
  while (countMessagesTokens([...systemMessages, ...trimmed]) > maxTokens && trimmed.length > 2) {
    trimmed.shift()  // 移除最早的消息
  }

  return [...systemMessages, ...trimmed]
}
策略保证:system prompt 永远保留 + 至少保留一对 user+assistant + 超限时从最早的消息开始丢弃。
Token 估算采用按字符近似法:中文 1 token/1.5 字符,英文 1 token/4 字符,每条消息额外计 4 token 作为 role 标记开销。
4.4 会话持久化
通过 pinia-plugin-persistedstate 自动保存到 localStorage:
export const useChatStore = defineStore('ch@t', () => { ... }, {
  persist: {
    paths: ['sessions', 'currentSessionId'],
  },
})
刷新页面后会话不丢失。Store 初始化时还会做版本兼容迁移——旧版的 agentBinding / orchestrationBinding 自动合并为 sceneBinding。
五、前端通信层:SSE 读取器与 Composable
在深入代码之前,先理清这一层的核心问题:这些方法之间是什么关系,数据从后端 SSE 流到用户屏幕经过了哪几步?
5.1 三层通信架构图
┌─────────────────────────────────────────────────────────────────────────────────┐
│                         后端 SSE 响应流(HTTP text/event-stream)                │
│                                                                                 │
│    data: {"type":"content","text":"你"}                                         │
│    data: {"type":"content","text":"好"}                                         │
│    data: {"type":"done","tokens":{...}}                                         │
└──────────────────────────────────┬──────────────────────────────────────────────┘
                                   │
                          ①  HTTP 二进制流
                                   ▼
┌─────────────────────────────────────────────────────────────────────────────────┐
│  第 1 层:readSseStream()             文件:[email protected]                       │
│  ───────────────────────────────────────────────────────────────────────────────│
│  职责:把原始 HTTP 流转成结构化 JSON 事件                                         │
│                                                                                 │
│  fetch → ReadableStream → TextDecoder 解码 → buffer 缓冲切行                     │
│  → 找到 "data:" 前缀 → JSON.parse → 调用 onEvent(json) 回调                      │
│                                                                                 │
│  这一层不知道 "对话" 是什么,只做「流 → 事件」的格式转换                            │
└──────────────────────────────────┬──────────────────────────────────────────────┘
                                   │
                          ②  onEvent(json) 回调
                                   ▼
┌─────────────────────────────────────────────────────────────────────────────────┐
│  第 2 层:executeLlmStream()           文件:[email protected]                     │
│  ───────────────────────────────────────────────────────────────────────────────│
│  职责:为 readSseStream 填入通用 LLM 对话的固定参数                               │
│                                                                                 │
│  只是 readSseStream 的薄封装:                                                   │
│    url    = "/api/ai/dialog/stream"                                             │
│    body   = { mode: "streaming_llm", messages, conversationId, requestId }      │
│    onEvent = 原样透传给上层                                                      │
│                                                                                 │
│  这一层不知道 "事件类型" 是什么,只做「URL + 参数」的组装                          │
└──────────────────────────────────┬──────────────────────────────────────────────┘
                                   │
                          ③  事件回调 (event: LlmTestChatSSEEvent)
                                   ▼
┌─────────────────────────────────────────────────────────────────────────────────┐
│  第 3 层:useChatExecution             文件:useChatExecution.ts                 │
│  ───────────────────────────────────────────────────────────────────────────────│
│  职责:理解每种事件类型的含义,驱动 Store 更新和 UI 状态                           │
│                                                                                 │
│  switch (event.type) {                                                          │
│    case 'content' → [email protected](event.text)  // 追加文字         │
│    case 'done'    → loading = false, setLastMessageTokens()  // 结束             │
│    case 'error'   → 显示错误 + loading = false                                   │
│  }                                                                              │
│                                                                                 │
│  这一层理解 "对话协议",是连接 API 和 UI 的调度枢纽                                │
└──────────────────────────────────┬──────────────────────────────────────────────┘
                                   │
                          ④  [email protected]("你好")
                                   ▼
┌─────────────────────────────────────────────────────────────────────────────────┐
│  ChatStore (Pinia)                   文件:[email protected]                              │
│  ─────────────────────────────────────────────────────────────────────────────── │
│  session.messages[最后一条].content += "你好"   // 追加,不覆盖                   │
│                                                                                 │
│  Vue 的响应式系统自动检测到 content 变化                                          │
└──────────────────────────────────┬──────────────────────────────────────────────┘
                                   │
                          ⑤  Vue 响应式渲染
                                   ▼
┌─────────────────────────────────────────────────────────────────────────────────┐
│  ChatInterface.vue                   文件:ChatInterface.vue                    │
│  ─────────────────────────────────────────────────────────────────────────────── │
│  <div v-html="renderMarkdown(msg.content)">  // Markdown 渲染 AI 回复            │
│  用户看到「你好」两个字逐字出现在屏幕上                                          │
└─────────────────────────────────────────────────────────────────────────────────┘
总结三层关系
readSseStream 负责「把流变成事件」,executeLlmStream 负责「告诉它调哪个接口」,useChatExecution 负责「拿到事件后更新界面」。
类比理解:
| 层 | 类比 | 职责 |
|---|---|---|
readSseStream | 信封拆信器 | 不管信里写了什么,只负责把信封拆开取出信纸(把流变成 JSON) |
executeLlmStream | 邮局地址簿 | 不管信的内容,只负责把信投到正确的地址(填好 URL 和参数) |
useChatExecution | 收信人 | 读信的内容,根据内容做出反应(判断事件类型,更新 Store) |
5.2 [email protected]——通用的SSE 流式读取器
[email protected] 是所有对话模式共享的底层通信层。readSseStream 是核心方法,
/**
 * 通用的 SSE 流式读取器
 * 解析 ReadableStream 中的 SSE data 行,逐个回调分发
 *
 * @param url    请求 URL
 * @param body   POST 请求体
 * @param onEvent 事件回调,每解析一个 JSON 事件调用一次
 */
async function readSseStream(
  url: string,
  body: any,
  onEvent: (json: any) => void,
): Promise<void> {
  // 1. 中断上一次请求(确保同一时间只有一个对话流)
  currentAbortController?.abort()
  currentAbortController = new AbortController()

  // 2. 发起 fetch 请求
  const response = await fetch(url, getFetchConfig(body, currentAbortController.signal))
  if (!response.ok) throw new Error(`请求失败: ${response.status}`)

  // 3. 获取 ReadableStream 读取器
  const reader = response.body!.getReader()
  //创建文本解码器,将二进制转换成文本
  const decoder = new TextDecoder()
  // 初始化缓冲区,暂存不完整的数据行
  let buffer = ''

  try {
    while (true) {
      //逐块读取
      //value:当前读取的数据块
      //done:流是否结束
      const { done, value } = await reader.read()

      //流结束,结束循环
      if (done) break

      //解码并追加到缓冲区
      //{ stream: true } 参数,处理多字节字符被截断的情况
      //比如一个中文字符占 3 个字节,可能第一块只收到前 2 个字节,
      //stream: true 会自动缓存,等下一块补齐后再解码
      buffer += decoder.decode(value, { stream: true })

      //按换行符切分,按换行符把 buffer 切成数组
      const lines = buffer.split('n')

      //取出数组最后一个元素,放回 buffer。
      //因为最后一行可能不完整,不能处理,要留给下一轮拼接。
      buffer = lines.pop()!

      // 逐行解析 SSE 事件
      for (const line of lines) {
        //去掉前后空白字符
        const trimmed = line.trim()

        //SSE 协议规定,每条消息以 data: 开头
        if (trimmed.startsWith('data:')) {
          //去掉 data: 前缀(5 个字符),再 trim 掉多余空格,得到纯 JSON 字符串
          const raw = trimmed.slice(5).trim()
          //空行跳过(SSE 协议中 nn 表示一个事件结束,可能产生空行)
          if (!raw) continue

          try {
            //把 JSON 字符串解析成对象
            //把解析好的对象通过回调传出去,调用方在这里更新 UI
            onEvent(JSON.parse(raw))
          } catch { /* 忽略解析异常 */ }
        }
      }
    }

    // 处理 buffer 中剩余数据
    //循环结束后(done === true),buffer 里可能还剩最后一行数据
    //(因为之前 pop() 把它留在了 buffer 里,没有处理)。
    //这里做最后的兜底:如果 buffer 里还有以 data: 开头的完整内容,就解析并回调。
    if (buffer.startsWith('data:')) {
      const raw = buffer.slice(5).trim()
      if (raw) { try { onEvent(JSON.parse(raw)) } catch {} }
    }
  } finally {
    //释放读取器对流的控制权,让流可以被其他消费者使用
    reader.releaseLock()
  }
}
这个方法解决了一个容易忽略的问题:多字节字符截断。
一个中文字符占 3 个 UTF-8 字节。如果一个 chunk 的边界恰好切断了"你"字的 3 个字节中的前 2 个,decoder.decode() 会返回乱码。stream: true 参数让 TextDecoder 保留未完成的字节,等下一个 chunk 补齐后再解码。
5.3 executeLlmStream——通用对话入口
通用对话的入口方法只是 readSseStream 的薄封装:
/**
 * LLM 对话(SSE 流式,含 token 统计和执行记录)
 *
 * 以 SSE 事件流形式逐 token 返回 AI 回复,完成时推送 token 消耗统计和耗时。
 * 对话记录会自动保存到 ai_execution_session 表中。
 *
 * @param messages  对话消息列表
 * @param namespace 知识库命名空间(可选)
 * @param onEvent   事件回调,接收 LlmTestChatSSEEvent
 * @param options   会话定位参数(conversationId / requestId / sceneId,落库用)
 */
export async function executeLlmStream(
  messages: ChatMessage[],
  namespace: string | undefined,
  onEvent: (event: LlmTestChatSSEEvent) => void,
  options?: { conversationId?: string; requestId?: string; sceneId?: number },
): Promise<void> {
  await readSseStream(
    `${BASE_URL}/ai/dialog/stream`,
    {
      mode: 'streaming_llm',
      messages,
      namespace,
      conversationId: options?.conversationId,
      requestId: options?.requestId,
      sceneId: options?.sceneId,
    },
    onEvent,
  )
}
5.4 useChatExecution——统一对话 Composable
useChatExecution 是连接 UI 和 API 的中间层,充当了 UI 组件与底层聊天状态(ch@tStore)及 LLM 接口之间的“调度中心”。核心作用是封装聊天应用中的消息发送、流式响应处理以及状态管理逻辑。
它根据 session.mode 自动选择对话接口:
export function useChatExecution() {
  // 引入聊天状态管理,用于操作消息列表、会话信息等
  const ch@tStore = useChatStore()

  // 记录当前对话的 Token 消耗量(包含提示词和补全部分的 token 数)
  const tokenUsage = ref<{ prompt: number; completion: number } | null>(null)

  // 记录 LLM 的执行步骤进度(如 Agent 思考过程、工具调用等)
  const llmSteps = ref<StepProgress[]>([])

  /**
   * 发送消息的核心入口函数
   * @param text 用户输入的文本内容
   */
  async function sendMessage(text: string) {
    const session = [email protected]
    if (!session) return // 如果没有活跃的会话,直接返回

    // 生成唯一 requestId(时间戳 + 随机字符串),用于精确定位某一轮对话,防止并发请求导致消息错乱
    const requestId = `msg_${Date.now()}_${Math.random().toString(36).slice(2, 8)}`

    // 1. 添加用户消息到列表(乐观更新,立即显示用户输入)
    [email protected]({ role: 'user', content: text, requestId })
    [email protected] = true // 开启加载状态,通常用于禁用发送按钮或显示加载动画

    // 2. 预添加一条空的 assistant 消息(流式内容将实时追加到这里,实现打字机效果)
    [email protected]({ role: 'assistant', content: '', requestId })

    // 3. 根据当前会话模式分发到不同的处理逻辑
    if (session.mode === 'scene' && session.sceneBinding) {
      await sendSceneMessage(text, session, requestId)  // 场景模式 → 走编排/Agent 工作流
    } else {
      await sendLlmMessage(requestId)  // LLM 模式 → 走通用大模型对话
    }
  }

  /**
   * 处理通用 LLM 对话的流式请求
   * @param requestId 当前请求的唯一标识
   */
  async function sendLlmMessage(requestId: string) {
    const session = [email protected]
    // 获取上下文消息(包含 system prompt 和历史对话,内部通常已做长度裁剪)
    const contextMessages = [email protected]()

    try {
      // 调用流式 LLM 接口,传入上下文、命名空间、事件回调和额外参数
      await executeLlmStream(contextMessages, [email protected], (event) => {
        switch (event.type) {
          case 'content':
            // 关键:每次收到 token 片段,实时追加到最后一条 assistant 消息中
            if (event.text) [email protected](event.text)
            break
          case 'done':
            // 流式传输结束,关闭加载状态
            [email protected] = false
            if (event.tokens) {
              // 记录 Token 消耗量,用于 UI 展示成本或配额
              tokenUsage.value = event.tokens
              [email protected](event.tokens.prompt, event.tokens.completion)
            }
            break
          case 'error':
            // 流传输过程中出错,将错误信息追加到助手消息末尾
            [email protected](`nn[错误: ${event.message}]`)
            [email protected] = false
            break
        }
      }, {
        // 传递额外参数,用于后端日志追踪或场景关联
        conversationId: session?.conversationId,
        requestId,
        sceneId: session?.sceneBinding?.sceneId,
      })
    } catch (err: any) {
      // 处理请求异常
      if (err?.name === 'AbortError') {
        [email protected] = false
        return  // 用户主动中断(如点击停止生成),不显示错误提示,体验更友好
      }
      // 其他异常(如网络错误、接口报错),将错误信息展示在聊天界面中
      [email protected](`nn[错误: ${(err as Error).message}]`)
      [email protected] = false
    }
  }

  // 对外暴露接口:发送消息、中断请求、Token 用量、执行步骤
  return { sendMessage, abort, tokenUsage, llmSteps }
}
这里有一个关键设计:**助手消息与用户消息共用同一 **requestId。这使得点击气泡查看该轮完整链路时,可以通过 requestId 精确定位到后端的执行记录。
六、前后端桥梁:SSE 事件协议
前后端之间通过统一的 SSE 事件协议通信。SseEvent 定义了所有对话模式共用的事件类型:
6.1 事件类型一览
| 事件类型 | 方向 | 触发时机 | 携带数据 | 前端动作 |
|---|---|---|---|---|
step_start | 后→前 | LLM 调用开始 | { stepIndex, stepType, stepName } | 显示步骤进度条 |
content | 后→前 | 每收到一个 token | { text } | 追加到消息气泡 |
step_done | 后→前 | LLM 调用完成 | { stepIndex, stepType, status, durationMs } | 标记步骤完成 |
done | 后→前 | 整个对话完成 | { tokens, durationMs, model } | 停止 loading,显示统计 |
stop | 后→前 | 用户终止对话 | { message, durationMs } | 追加"已终止"标记 |
error | 后→前 | 出错 | { message } | 显示错误信息 |
6.2 SSE 数据流格式
后端通过 SseEvent.send() 发送事件,每个事件在 HTTP 响应流中的格式:
data: {"type":"step_start","stepIndex":1,"stepType":"llm_call","stepName":"LLM 调用"}

data: {"type":"content","text":"你"}

data: {"type":"content","text":"好"}

data: {"type":"step_done","stepIndex":1,"stepType":"llm_call","status":"success","durationMs":2300}

data: {"type":"done","tokens":{"prompt":120,"completion":45},"durationMs":2300,"model":"MiMo-7B-RL"}
前端 readSseStream 的职责就是按 n 切行,找 data: 前缀,提取 JSON 并通过回调分发。后端 SseEvent.send() 的实现:
public static void send(SseEmitter emitter, String type, Map<String, Object> data) {
    Map<String, Object> event = new HashMap<>(data);
    event.put("type", type);  // 自动注入 type 字段
    emitter.send(SseEmitter.event()
        .name("message")
        .data(objectMapper.writeValueAsString(event), MediaType.APPLICATION_JSON));
}
6.3 请求体结构
前端发送给后端的请求体(AiDialogRequest):
{
  "mode": "streaming_llm",
  "messages": [
    { "role": "system", "content": "你是 DeepSeek..." },
    { "role": "user", "content": "你好" },
    { "role": "assistant", "content": "你好!有什么可以帮助你的?" },
    { "role": "user", "content": "介绍一下你自己" }
  ],
  "conversationId": "conv_1725000000_abc123_42",
  "requestId": "msg_1725000001_xyz789"
}
七、后端接入:Controller 层
AiDialogController.stream() 是所有流式对话的统一入口。通用对话走 POST /api/ai/dialog/stream:
/**
 * 流式 LLM 对话(SSE 流式返回,含 token 统计和执行记录)
 *
 * @param request  统一对话请求(mode=streaming_llm)
 * @param response HTTP 响应对象
 * @return SSE 发射器
 */
@PostMapping("/stream")
public SseEmitter stream(@RequestBody AiDialogRequest request,
                         @RequestHeader("Authorization") String authHeader,
                         HttpServletResponse response) {
    // 设置 SSE 响应头
    //TEXT_EVENT_STREAM_VALUE 的值是 text/event-stream,这是 SSE 协议要求的 MIME 类型,
    //告诉浏览器这是一个持续的数据流。
    response.setContentType(MediaType.TEXT_EVENT_STREAM_VALUE);
    //指定字符编码,确保中文等多字节字符正确显示
    response.setCharacterEncoding("UTF-8");
    //禁止缓存,确保每次推送的数据都是实时的
    response.setHeader("Cache-Control", "no-cache");
    //告诉 Nginx 不要缓冲这个响应。Nginx 默认会缓冲后端响应再一次性发给客户端,
    //这会导致 SSE 失去"流式"效果,必须关掉
    response.setHeader("X-Accel-Buffering", "no");

    //创建一个 SseEmitter 对象,它代表了与客户端的 SSE 连接。10 分钟超时
    SseEmitter emitter = new SseEmitter(600000L);
    Long userId = getCurrentUserId();

    // 使用公共线程池异步执行
    sseExecutor.execute(() -> {
        try {
            dialogService.handleStream(request, userId, null, emitter, response);
        } catch (Exception e) {
            try {
                emitter.completeWithError(e);
            } catch (Exception ignored) {
            }
        }
    });

    registerEmitterCallbacks(emitter);
    return emitter;
}

/**
 * 注册 SSE 发射器的生命周期回调
 */
private void registerEmitterCallbacks(SseEmitter emitter) {
    emitter.onCompletion(() -> log.debug("SSE 连接正常关闭"));
    emitter.onTimeout(() -> {
        log.warn("SSE 连接超时");
        try { emitter.complete(); } catch (Exception ignored) {}
    });
    emitter.onError((e) -> log.error("SSE 连接发生错误", e));
}
SseEmitter 是 Spring 提供的 SSE 工具。
**<font style="color:#DF2A3F;">return emitter</font>** 之后 HTTP 连接不会断开,后续 **<font style="color:#DF2A3F;">emitter.send()</font>** 每次都会往这个连接写一行 **<font style="color:#DF2A3F;">data:xxx</font>**。
这就是 SSE(Server-Sent Events)的本质 — 一个长连接,服务端可以多次推送。
几个关键设计决策:
| 设计点 | 选择 | 原因 |
|---|---|---|
**响应头 **X-Accel-Buffering: no | 禁用 Nginx 缓冲 | 避免 Nginx 攒满 buffer 再一次性发给前端,导致"卡半天突然一堆内容" |
| SseEmitter 10 分钟超时 | 600000L | 长对话可能耗时较久,10 分钟是安全上限 |
| 异步线程池执行 | sseExecutor.execute() | Spring Servlet 线程池有限,SSE 连接可能保持数分钟,必须异步释放 Servlet 线程 |
八、后端核心:AiDialogService
AiDialogService 是统一对话调度服务,按 mode 分发到不同处理方法。通用对话走 handleLlmStream()。
8.1 调度入口——额度校验 + 模式分发
/**
 * 流式对话(按 mode 分发)
 *
 * @param request  统一请求
 * @param userId   当前用户 ID
 * @param emitter  SSE 发射器
 * @param response HTTP 响应(用于 flush/close)
 */
public void handleStream(AiDialogRequest request, Long userId, String authToken,
                          SseEmitter emitter, HttpServletResponse response) {
    // 额度校验:调用大模型前检查用户剩余额度,超限则拒绝并返回提示
    String quotaError = tokenQuotaService.checkQuota(userId);
    if (quotaError != null) {
        //推送前端 额度不足
        SseEvent.sendError(emitter, quotaError);
        //关闭SSE连接
        sendDoneAndClose(emitter, response, quotaError);
        return;
    }

    String mode = request.getMode();
    switch (mode) {
        // 通用LLM调用
        case "streaming_llm" -> handleLlmStream(request, userId, emitter, response);
        // 单agent LLM调用
        case "agent_stream" -> handleAgentStream(request, userId, authToken, emitter, response);
        // 多agent 编排 LLM调用
        case "orchestration" -> handleOrchestration(request, userId, authToken, emitter, response);
        default -> {
            SseEvent.sendError(emitter, "未知对话模式: " + mode);
            sendDoneAndClose(emitter, response, "未知对话模式");
        }
    }
}

/**
 * 发送 done 事件并关闭 SSE 连接
 * <p>在异常路径中调用,确保前端能收到 done 事件并关闭连接。</p>
 */
private void sendDoneAndClose(SseEmitter emitter, HttpServletResponse response, String errorMessage) {
    try {
        SseEvent.send(emitter, SseEvent.TYPE_DONE, Map.of(
                "status", "error",
                "error", errorMessage != null ? errorMessage : "未知错误"
        ));
    } catch (Exception ignored) {}
    try { response.flushBuffer(); } catch (Exception ignored) {}
    try { response.getOutputStream().close(); } catch (Exception ignored) {}
    try { emitter.complete(); } catch (Exception ignored) {}
}
8.2 handleLlmStream()——核心逻辑
这是整个通用对话的核心,一个方法串联了配置读取 → 消息构建 → 身份注入 → LLM 调用 → 结果推送 → 统计落库全链路。
第一阶段:读取 Provider 配置
private void handleLlmStream(AiDialogRequest request, Long userId,
                              SseEmitter emitter, HttpServletResponse response) {
    //记录方法开始时间,用于最后计算总耗时
    long startTime = System.currentTimeMillis();
    //拼接模型返回的完整内容,后续用于保存对话记录
    StringBuilder fullContent = new StringBuilder();
    //输入 token 数(prompt tokens),输出 token 数(completion tokens)
    int[] tokenUsage = {0, 0};

    // 注册取消标志(用于用户终止对话)
    AtomicBoolean cancelFlag = registerCancelFlag(userId);

    //  获取当前激活的 AI 提供商名称(如 openai、qwen、deepseek 等)
    String providerName = aiProperties.getActiveProvider();
    //从配置中获取该提供商的详细配置(API Key、模型名、基础 URL 等)
    AIProperties.ProviderConfig config = aiProperties.getProviders().get(providerName);
    //获取要调用的模型名称(如 gpt-4o、qwen-max 等)
    String modelName = config.getChatModel();
    //拼接完整的 API 地址。
    String url = config.getBaseUrl().replaceAll("/+$", "") + "/ch@t/completions";
aiProperties 绑定的是 application.properties 中的 ai.* 前缀配置:
ai.active-provider=mimo
ai.embedding-provider=aliyun
ai.providers.mimo.api-key=sk-xxxxxxx
ai.providers.mimo.base-url=https://api.siliconflow.cn/v1
ai.providers.mimo.ch@t-model=MiMo-7B-RL
activeProvider 决定对话模型,embeddingProvider 决定向量化模型——两者可以来自不同厂商。
第二阶段:构建消息列表 + 注入身份提示词
    // 2. 构建消息列表(优先使用 messages 字段,兼容 history + question 模式)
    List<Map<String, String>> messagesToSend = new ArrayList<>();
    if (request.getMessages() != null && !request.getMessages().isEmpty()) {
        for (ChatRequest.MessageDTO msg : request.getMessages()) {
            messagesToSend.add(Map.of("role", msg.getRole(), "content", msg.getContent()));
        }
    }
    if (messagesToSend.isEmpty()) {
        if (request.getHistory() != null) {
            for (Map<String, String> h : request.getHistory()) {
                messagesToSend.add(Map.of("role", h.get("role"),
                    "content", h.get("content") != null ? h.get("content") : ""));
            }
        }
        String question = request.getQuestion() != null ? request.getQuestion() : "";
        if (!question.isBlank()) {
            messagesToSend.add(Map.of("role", "user", "content", question));
        }
    }

    // 2.5 注入 provider 身份提示词(确保模型知道自己是谁)
    String providerIdentity = AiProviderIdentities.get(providerName);
    if (providerIdentity == null || providerIdentity.isBlank()) {
        providerIdentity = config.getSystemPrompt();
    }
    if (providerIdentity != null && !providerIdentity.isBlank()) {
        messagesToSend.add(0, Map.of("role", "system", "content", providerIdentity));
    }
AiProviderIdentities 集中管理中文身份提示词:
public final class AiProviderIdentities {
    private static final Map<String, String> MAP = Map.of(
        "deepseek", "你是 DeepSeek,由深度求索公司开发的 AI 智能助手。",
        "aliyun",   "你是通义千问,由阿里云开发的 AI 智能助手。",
        "mimo",     "你是 MiMo,小米公司研发的 AI 智能助手。"
    );
}
这个设计解决了一个实际问题:如果不注入身份,MiMo 会自称"我是 ChatGPT"——因为大部分模型都基于 OpenAI 格式训练,没有显式身份指令时会默认报出训练数据中最常见的身份。
第三阶段:调用 LLM 并流式推送
    // 3. 构建请求体
    Map<String, Object> requestBody = new HashMap<>();
    requestBody.put("model", modelName);
    requestBody.put("messages", messagesToSend);
    requestBody.put("stream", true);

    // 4. 发送 step_start 事件
    SseEvent.send(emitter, SseEvent.TYPE_STEP_START,
        SseEvent.stepStart(1, "llm_call", "LLM 调用"));

    // 5. 流式调用 LLM
    HttpURLConnection connection = llmSseHelper.createConnection(url, config.getApiKey(), requestBody);

    llmSseHelper.readChunks(connection, cancelFlag, chunk -> {
        if (chunk.hasDeltaContent()) {
            fullContent.append(chunk.getDeltaContent());
            // 每收到一个 token,立即推送给前端
            SseEvent.send(emitter, SseEvent.TYPE_CONTENT,
                SseEvent.content(chunk.getDeltaContent()));
        }
        if (chunk.hasUsage()) {
            tokenUsage[0] = chunk.getPromptTokens() != null ? chunk.getPromptTokens() : tokenUsage[0];
            tokenUsage[1] = chunk.getCompletionTokens() != null ? chunk.getCompletionTokens() : tokenUsage[1];
        }
    });
    connection.disconnect();
注意 SseEvent.TYPE_CONTENT 事件的推送位置——每收到一个 delta content 就推一次。这意味着用户看到的是逐字出现的效果,而不是等 LLM 全部生成完毕后一次性返回。
第四阶段:完成推送 + 统计落库
    // 6. 发送 step_done 和 done 事件
    SseEvent.send(emitter, SseEvent.TYPE_STEP_DONE,
        SseEvent.stepDone(1, "llm_call", "LLM 调用", "success", totalDuration));

    Map<String, Object> doneData = new HashMap<>();
    doneData.put("tokens", Map.of("prompt", tokenUsage[0], "completion", tokenUsage[1]));
    doneData.put("durationMs", totalDuration);
    doneData.put("model", modelName);
    SseEvent.send(emitter, SseEvent.TYPE_DONE, doneData);

    // 7. 关闭 SSE
    emitter.complete();

    // 8. 异步保存执行记录
    saveLlmSession(request, fullContent.toString(), (int) totalDuration,
        tokenUsage[0], tokenUsage[1], modelName, "success", null, userId);
}
九、后端基础设施:LlmSseHelper
LlmSseHelper 封装了所有 LLM HTTP 调用的底层细节,被三种对话模式共同复用。
9.1 createConnection()——创建 HTTP 连接
public HttpURLConnection createConnection(String url, String apiKey,
    Map<String, Object> requestBody) throws Exception {
    HttpURLConnection connection = (HttpURLConnection) URI.create(url).toURL().openConnection();
    connection.setRequestMethod("POST");
    connection.setRequestProperty("Content-Type", "application/json");
    connection.setRequestProperty("Authorization", "Bearer " + apiKey);
    connection.setDoOutput(true);
    connection.setConnectTimeout(30000);     // 连接超时 30 秒
    connection.setReadTimeout(300000);       // 读取超时 5 分钟(LLM 生成可能很慢)

    byte[] body = objectMapper.writeValueAsBytes(requestBody);
    try (OutputStream os = connection.getOutputStream()) {
        os.write(body);
        os.flush();
    }
    return connection;
}
为什么用 HttpURLConnection 而不是 Spring 的 WebClient 或 RestTemplate?
- 控制粒度:需要在
readChunks的 while 循环中逐行读取 SSE 流,HttpURLConnection 的BufferedReader最直接 - 取消灵活性:
cancelFlag检查可以放在每次readLine()之后,随时中断 - 零依赖:不引入额外的 HTTP 客户端依赖
9.2 readChunks()——逐 chunk 回调
这是整个流式通信的核心方法,采用 回调模式——调用方传入一个 Consumer<Chunk>,每解析到一个有效 chunk 就回调一次:
public void readChunks(HttpURLConnection conn, AtomicBoolean cancelFlag,
    Consumer<Chunk> onChunk) throws Exception {

    // 检查 HTTP 响应码
    int responseCode = conn.getResponseCode();
    if (responseCode != 200) {
        String errorBody = new String(
            conn.getErrorStream() != null ? conn.getErrorStream().readAllBytes() : new byte[0],
            StandardCharsets.UTF_8);
        throw new RuntimeException("LLM API 返回错误: HTTP " + responseCode + ", body=" + errorBody);
    }

    try (BufferedReader reader = new BufferedReader(
            new InputStreamReader(conn.getInputStream(), StandardCharsets.UTF_8))) {
        String line;
        while ((line = reader.readLine()) != null) {
            // 检查取消标志(每读一行检查一次,响应用户终止请求)
            if (cancelFlag != null && cancelFlag.get()) {
                break;
            }

            if (line.startsWith("data:")) {
                String data = line.substring(5).trim();
                if (data.isEmpty()) continue;

                // [DONE] 标记表示流结束
                if ("[DONE]".equals(data)) {
                    Chunk doneChunk = new Chunk();
                    doneChunk.setDone(true);
                    onChunk.accept(doneChunk);
                    break;
                }

                // 解析 JSON chunk
                Map<String, Object> chunk = objectMapper.readValue(data, Map.class);
                Chunk result = parseChunk(chunk);
                if (result != null) {
                    onChunk.accept(result);
                }
            }
        }
    }
}
LLM 的 SSE 响应格式(OpenAI 兼容):
data: {"choices":[{"delta":{"content":"你"},"index":0}],"model":"MiMo-7B-RL"}
data: {"choices":[{"delta":{"content":"好"},"index":0}],"model":"MiMo-7B-RL"}
data: {"choices":[{"delta":{},"finish_reason":"stop","index":0}],
       "usage":{"prompt_tokens":120,"completion_tokens":45}}
data: [DONE]
parseChunk() 从每个 chunk 中提取 delta.content(增量文本)和 usage(token 统计,仅最后一个 chunk 有值):
private Chunk parseChunk(Map<String, Object> chunk) {
    Chunk result = new Chunk();

    // 提取 delta.content
    List<Map<String, Object>> choices = (List<Map<String, Object>>) chunk.get("choices");
    if (choices != null && !choices.isEmpty()) {
        Map<String, Object> delta = (Map<String, Object>) choices.get(0).get("delta");
        if (delta != null && delta.get("content") != null) {
            result.setDeltaContent(delta.get("content").toString());
        }
    }

    // 提取 usage(仅最后一个 chunk)
    Map<String, Object> usage = (Map<String, Object>) chunk.get("usage");
    if (usage != null) {
        result.setPromptTokens(usage.get("prompt_tokens") != null
            ? ((Number) usage.get("prompt_tokens")).intValue() : null);
        result.setCompletionTokens(usage.get("completion_tokens") != null
            ? ((Number) usage.get("completion_tokens")).intValue() : null);
    }

    return result;
}
十、Token 额度与统计
每次调用 LLM 前后都有配套的 Token 管理逻辑。
10.1 调用前——额度校验
TokenQuotaService.checkQuota() 在 AiDialogService.handleStream() 的第一行调用:
String quotaError = tokenQuotaService.checkQuota(userId);
if (quotaError != null) {
    SseEvent.sendError(emitter, quotaError);
    sendDoneAndClose(emitter, response, quotaError);
    return;  // 拒绝调用,直接返回
}
支持三种额度类型:
| 额度类型 | 重置周期 | 计算方式 |
|---|---|---|
daily | 每日凌晨 00:05 自动重置 | 当日已用 token 总量 vs 配置限额 |
monthly | 每月 1 日 00:10 重置 | 本月已用 token 总量 vs 配置限额 |
total | 不重置 | 历史累计 token 总量 vs 配置限额 |
10.2 调用后——用量记录
// 在 handleLlmStream 中,流式读取结束后记录 Token 消耗
TokenUsageLog tokenLog = new TokenUsageLog();
tokenLog.setCallTime(new Date());
tokenLog.setModelName(modelName);
tokenLog.setTokensInput(tokenUsage[0]);    // prompt tokens
tokenLog.setTokensOutput(tokenUsage[1]);   // completion tokens
tokenLog.setDurationMs((int) llmDuration);
tokenLog.setUserId(userId);
tokenLog.setBizType("ch@t");              // 通用对话
tokenLog.setRequestId(request.getRequestId());
tokenStatsService.recordCall(tokenLog);
TokenStatsService.recordCall() 同时写入两张表:
ai_token_usage_log——每次调用的明细记录(含 requestId,可追溯到具体某轮对话)ai_token_usage_daily——按天聚合的统计表(用于趋势图、模型占比图等看板)- 同时调用
tokenQuotaService.recordUsage()扣减用户额度
十一、取消对话——跨端终止机制
用户点击「停止」按钮时,前后端协作完成优雅终止。
11.1 前端触发
async function abort() {
  // 1. 通知后端设置取消标志
  cancelChatStream()  // POST /api/ai/dialog/cancel
  // 2. 等待 500ms(给后端时间处理)
  await new Promise(resolve => setTimeout(resolve, 500))
  // 3. 中断前端 fetch 请求
  abortChat()
  [email protected] = false
  // 4. 标记进行中的步骤为 skip
  llmSteps.value.forEach(s => { if (s.status === 'running') s.status = 'skip' })
}
11.2 后端响应
public void cancelStream(Long userId) {
    AtomicBoolean flag = cancelFlags.get(userId);
    if (flag != null) {
        flag.set(true);  // 设置取消标志
    }
}
readChunks() 在每次 readLine() 后检查这个标志:
while ((line = reader.readLine()) != null) {
    if (cancelFlag != null && cancelFlag.get()) {
        log.info("LLM 流式调用被取消");
        break;  // 跳出读取循环
    }
    // ... 正常处理
}
跳出后,handleLlmStream 检测到取消状态,发送 stop 事件和 step_done(skip) 事件,保存 status="cancelled" 的执行记录。
为什么要先通知后端再中断前端?因为如果直接 abort() 前端 fetch,后端的 LLM 调用会继续执行直到流结束(浪费 API 调用和 token),而且后端不知道这次对话被中断了,执行记录会标为 "success" 而不是 "cancelled"。
十二、完整数据流:一张时序图
用户输入    ChatInterface.vue     useChatExecution      [email protected]       后端服务
   │              │                      │                    │                  │
   │  Enter       │                      │                    │                  │
   ├─────────────>│                      │                    │                  │
   │              │  sendMessage(text)   │                    │                  │
   │              ├─────────────────────>│                    │                  │
   │              │                      │  addMessage(user)  │                  │
   │              │                      │  addMessage(assistant, "")            │
   │              │                      │  getContextMessages()                 │
   │              │                      │  → system + history + question        │
   │              │                      │  → trimContext(8000 tokens)           │
   │              │                      │                    │                  │
   │              │                      │  executeLlmStream(messages, onEvent) │
   │              │                      ├───────────────────>│                  │
   │              │                      │                    │  POST /ai/dialog/stream
   │              │                      │                    ├─────────────────>│
   │              │                      │                    │                  │ checkQuota()
   │              │                      │                    │                  │ 读取 Provider 配置
   │              │                      │                    │                  │ 构建 messages + 注入身份
   │              │                      │                    │                  │ 连接 LLM API
   │              │                      │                    │                  │
   │              │                      │                    │  step_start      │
   │              │                      │  onEvent(step_start)                  │
   │              │                      │                    │                  │
   │  "你"        │                      │                    │  content: "你"   │
   │<─────────────│  renderMarkdown()    │  onEvent(content) │                  │
   │              │<─────────────────────│  updateLastMessage │                  │
   │  "你好"      │                      │                    │  content: "好"   │
   │<─────────────│  renderMarkdown()    │  onEvent(content) │                  │
   │              │<─────────────────────│  updateLastMessage │                  │
   │  "你好!"    │                      │                    │  [DONE]          │
   │<─────────────│                      │  onEvent(done)    │  done: tokens    │
   │              │  loading = false     │                    │                  │
   │  统计信息     │  setLastMessageTokens│                   │  recordCall()    │
   │<─────────────│                      │                    │  saveLlmSession()│
十三、设计总结
| 设计点 | 实现方式 | 价值 |
|---|---|---|
| SSE 事件协议统一 | SseEvent.send() + type 字段 | 三种对话模式共享同一套前端事件处理,降低维护成本 |
| 回调模式读取流 | LlmSseHelper.readChunks(consumer) | 消除 Agent/编排/通用三个服务的重复 SSE 解析代码 |
| 取消标志跨线程 | ConcurrentHashMap<userId, AtomicBoolean> | 前端点击停止 → 后端设置标志 → 下一个readLine() 立即中断 |
| 上下文窗口管理 | trimContext(maxTokens=8000) | 防止多轮对话积累超出模型上下文限制,自动裁剪最早的消息 |
| 身份提示词注入 | AiProviderIdentities 常量类 | 解决多 Provider 切换时模型自报错误身份的问题 |
| requestId 全链路 | 前端生成 → 后端落库 | 可通过 requestId 精确定位某一轮对话的完整执行记录 |
| Nginx 缓冲禁用 | X-Accel-Buffering: no | 避免 Nginx 攒满 buffer 导致流式输出延迟 |
| Token 额度前置校验 | 调用 LLM 前checkQuota() | 避免已经消耗了 API 调用才发现额度不足 |
十四、关键文件索引
| 文件 | 层级 | 职责 |
|---|---|---|
ChatInterface.vue | 前端 UI | 对话界面(消息气泡 + 输入区 + 系统提示词设置) |
useAutoScroll.ts | 前端工具 | 智能自动滚动 Composable |
[email protected] | 前端 Store | 会话管理 + 上下文裁剪 + 持久化 |
tokenCounter.ts | 前端工具 | Token 估算与上下文窗口裁剪 |
useChatExecution.ts | 前端 Composable | 对话执行调度,模式分发 + 事件处理 |
[email protected] | 前端 API | SSE 流式读取器(readSseStream + executeLlmStream) |
AiDialogRequest.java | 后端 DTO | 统一对话请求 DTO |
AiDialogController.java | 后端 Controller | 创建 SseEmitter + 异步线程池分发 |
AiDialogService.java | 后端 Service | 统一对话调度,按 mode 分发到不同处理方法 |
LlmSseHelper.java | 后端工具 | LLM 流式调用工具,封装 HttpURLConnection + SSE 读取 |
SseEvent.java | 后端 DTO | SSE 事件协议,统一所有事件类型和发送方式 |
AiProviderIdentities.java | 后端配置 | 各 Provider 身份提示词常量 |
AIProperties.java | 后端配置 | 绑定ai.* 前缀配置的属性类 |
TokenQuotaService.java | 后端 Service | Token 额度校验与扣减(daily/monthly/total) |
TokenStatsService.java | 后端 Service | Token 用量统计,每次调用写入明细表 + 日统计表 |
十五、后续文章计划
本篇详细拆解了通用 LLM 流式对话的前后端联接。后续将逐步深入其他模块:
| 后续主题 | 预计覆盖 |
|---|---|
| Agent 四步流水线 | 提示词组装 → 知识库检索 → 技能调用 → LLM 流式调用 |
| RAG 知识库全链路 | 文档上传 → 解析分片 → ChromaDB 向量化 → 语义检索 |
| 编排执行引擎 | LLM 动态路由 → sequential/parallel 策略 → 多 Agent 协同 |
| 技能系统 | SkillHandler 策略模式 → HTTP/LLM/FileGen 三种执行器 |
| Token 额度管理 | 额度配置 → 前置校验 → 定时重置 → 看板统计 |
其他系列文章
第四篇:AI 模块架构设计:多 Provider 切换、RAG 知识库与 Agent 编排前言 访问地址:http:// - 掘金 (juejin.cn)
第三篇:组件化实践,SpTable 通用表格组件设计前言 访问地址:http://124.222.194.201/ 前端 - 掘金 (juejin.cn)
第二篇:SeaPack 权限体系:从"谁都能看"到"该看什么看什么"写在前面 上一篇聊了项目初始化和工程规范,这篇来聊一 - 掘金 (juejin.cn)
第一篇:SeaPack 全栈项目工程化实践写在前面 这篇文章是 SeaPack 项目技术系列的第一篇。在写代码之前,我想 - 掘金 (juejin.cn)