百人共学AI网站的架构是如何搭起来的
一套AI学习网站在本机能正常打开,并不代表其他设备能够访问,更不代表模型已经可靠使用了知识库。搭建面向多人共学的系统,需要分别验证入口网络、应用权限、模型推理、资料检索和部署恢复。下面从真实改造过程出发,拆解各层边界以及尚未完成的环节。
在运行网站的 Windows 电脑上,总览、AI 学习、笔记、知识库都能打开。我换到同一局域网的另一台设备,访问准备留给别人的 8080 入口,却只看到一句“服务器已运行”。两个地址的响应都是 HTTP 200。那一刻我才发现,自己差点把“我能打开”当成“别人能用”。
我想做的“百人共学”,也不是把数字 100 放进首页。一个人整理过的资料、走过的弯路,后来的人能不能查到,才是这个网站存在的理由。现在并没有一百名用户,也没有百人并发的测试结果。先把我实际搭起来的部分摊开,再讲还没接上的地方。
先画架构:请求和资料分别往哪里走
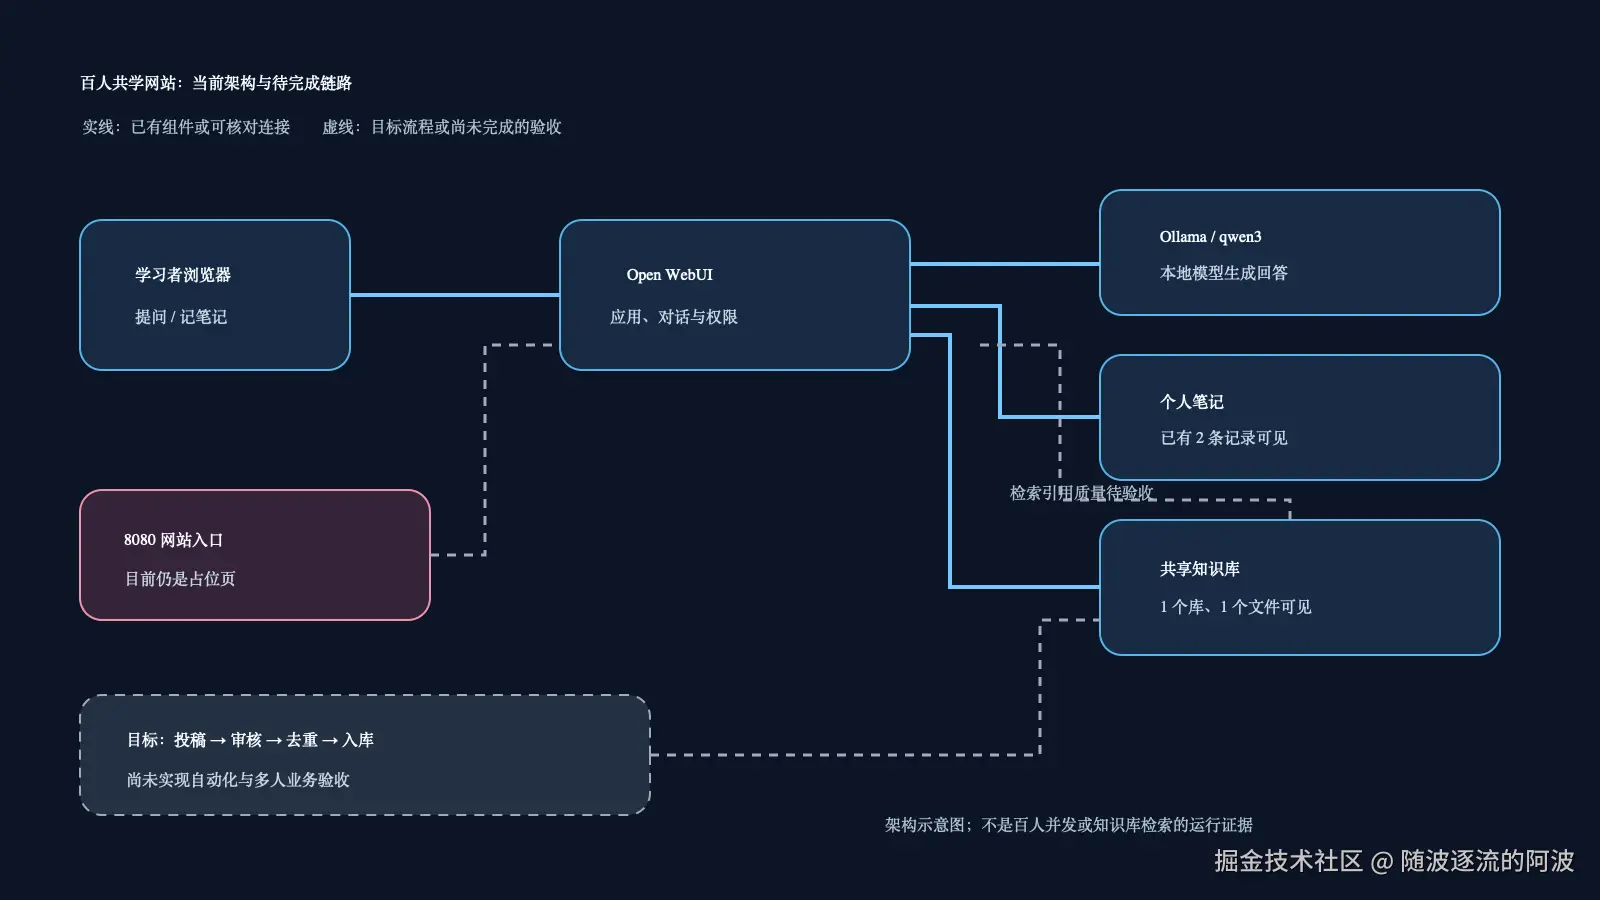
图里最容易混在一起的是两条路径。访问者从入口进入 Open WebUI,在页面里选学习助手、看笔记和知识库;提问时,Open WebUI 再把请求交给 Ollama 上的模型。资料走另一条路:文档进入知识库,被抽取、索引,等用户提问时才有机会作为上下文被取出来。图中的虚线是想做或还没验收的连接,不能照着虚线宣称功能已经可用。
这个划分决定了施工顺序:先保住已有的对话和资料,再改学习入口;最后从另一台设备验收访问。否则首页做得再完整,底下仍可能是空库,或者只有我自己能进去。
我给这张图划了三个数据边界。第一处在浏览器与 Open WebUI 之间:页面能不能打开、当前用户能不能看到资料,属于应用和权限问题。第二处在 Open WebUI 与 Ollama 之间:模型是否能生成回答,属于推理服务问题。第三处在知识库与模型输入之间:有没有取回相关片段、有没有把片段和来源交给模型,才决定回答能否被资料约束。排障时沿这三处依次看,比一上来换模型有效得多。
还有一条容易漏掉的“反向”路径:答完之后,学习者要把自己的实践整理成笔记;笔记经过核对,才可能进入共享知识库。当前网站有笔记和知识库两个入口,但“投稿—审核—发布—撤回”这条反向路径尚未实现。图里把它画成待完成链路,就是为了提醒自己:共学不等于多人共用一个聊天页面。
模型先接上,但不能把它叫作知识库
运行环境里已有 Ollama 和 qwen3:latest。Open WebUI 中的学习助手配置 ID 是 cohort-100-study-assistant。我保留了这个 ID 和基座模型,改的是面向学习者看到的名称、简介、提示词与推荐问题。这里没有训练一个新模型。
我最早关心的是“助手能否在网站里被选到”。做到以后,问题马上变了:它回答时究竟用了哪份资料?模型可以在没有检索结果的情况下给出一段很像样的文字,光看聊天框根本分不出来。因此模型接入我只按连接验收:配置还在、入口可见;资料可信度另开一项。Ollama 负责加载与推理,Open WebUI 负责会话和资料进入上下文的应用流程,二者不能互相替代。连接方式可对照 Ollama Windows 文档和 Open WebUI 的 Ollama 接入说明。
这轮没有做回答质量、长上下文或多人吞吐测试。qwen3:latest 能在配置里看到,并不等于它已经能为共学资料给出可靠答案。
为什么我不直接让 Ollama 管所有东西?因为模型名称和学习助手不是同一个对象。qwen3:latest 指向推理用的基座;cohort-100-study-assistant 是 Open WebUI 中保留下来的助手配置 ID,展示名、提示词和推荐问题可以随学习场景调整。以后修改入口文案,不应顺手改变模型或知识库的数据身份;以后试另一个模型,也应先对照相同资料和问题,而不是把页面是否能打开混进模型效果里。
这台机器之前单独检查过模型服务:16GB 内存、8GB 显存的环境里,Ollama 已有对话模型 qwen3:8b 和嵌入模型 nomic-embed-text:latest;后者的 /api/embed 返回过 HTTP 200 和 768 维向量。后来学习助手配置显示的是 qwen3:latest,交接记录确认它与当时的 qwen3:8b 指向同一模型 ID,并没有为了改一个显示名再存一份权重。这个细节提醒我把“对话模型”和“嵌入模型”分开看:一个生成回答,一个把文本表示成可检索的向量。嵌入接口单独成功,不证明 Open WebUI 已用它把那份知识库文件正确索引。
从这个项目能直接学到的一点是:先问“回答从哪里来”,再问“回答好不好”。如果没有检索片段,问题可能是资料没入库,也可能是助手根本没走检索链;如果片段正确但回答仍偏题,才轮到提示词、上下文长度或基座模型。只看最终一句回答,很难定位是哪一层出了问题。
知识库最怕的事:资料还在,却没人知道答案从哪来
现成的 Open WebUI 知识库里已有 1 个库、1 个文件。改页面时我没有新建一套库去替换它,库 ID 和原文件都保留了。原来的 2 条笔记也还在。对这个项目来说,这比先做出一张漂亮的知识库卡片更要紧:前面的人留下的东西若被页面改造顺手抹掉,“共学”从第一天就断了。
但“文件在列表里”只证明数据没有被这次改造覆盖。要让它回答问题,中间还有文档抽取、切分和索引;提问时还要检索片段,再送进模型。Open WebUI Knowledge 和 RAG 文档能核对这套产品机制,我没有把文档里支持的能力写成这台机器上的实测效果。
把这条链展开,写入侧是“原文件 → 文本抽取 → 分块 → 向量化与索引”;查询侧是“问题 → 同一套嵌入空间中的检索 → 候选片段 → 模型回答”。这里我最在意的不是某个参数的推荐值,而是每一段都有可检查的中间结果。比如 PDF 在列表里,抽取出来却只有页眉;此时调大 Top K 没用。抽取文本完整,但关键定义被切在两个块之间;此时应先看切分和重叠。片段已经命中,回答却没有可回溯出处;那就检查送入模型的上下文与展示引用的路径。
这也是为什么我不把“换一个更强的模型”当成知识库的第一步。模型不能凭空补回抽取时丢掉的字,也不能让没有索引的资料参与检索。更换嵌入模型时,已有文档通常需要按新模型重建索引,并让入库与查询使用兼容的向量空间;否则表面上仍有文件,检索结果却可能没有意义。具体操作要按当前 Open WebUI 版本和所选嵌入配置核对,不能把这段原理当成已在本机执行过的迁移记录。
本机还准备过一个资料收件箱,目的是先把原始材料留下,方便以后清洗和重导。它不是自动入库目录:把文件放进去,不会凭空产生可检索的切片。这里要同时核对两份东西——原始文件是否还在,以及应用里的知识库是否真的建出了可查询索引。一个解决资料保管,另一个解决检索;误把它们当成同一个“上传成功”,最容易在演示时露馅。
如果你也在做类似网站,我建议先拿一份自己能核对原文的短资料试库,不急着调参数。问一个原文直接写明的问题,再问一个需要拼起两处内容的问题,最后问一个原文根本没有回答的问题。每次都看抽取后的文本、命中的片段和引用位置;第三问尤其要看模型是否承认资料里没有。我的这套库还没有留下这组三问的测试回执,所以目前只能说“旧库保住了”,不能说“检索通过了”。
为了让这个测试能重复,我会把三道问题、期望引用的原文位置和“资料未覆盖”的标准答案一起存下来。第一次先不评价措辞,只看检索:目标片段有没有进候选结果。第二次再看生成:回答的每个事实句能不能落回那份材料。第三次故意问越界内容:如果资料没有,助手能否停下来。这样即使后面换分块方式或嵌入模型,也能比较变化发生在检索侧还是生成侧。这里写的是下一轮验收方案,并非已得到的命中率。
未来让大家投稿会更难。笔记不该自动变成共享结论;资料至少要写清来源、更新时间、适用范围和维护者,有纠错与撤回的办法。否则一个过期答案进入索引后,模型会替它说得更流畅。审核、授权、去重和重新索引目前都是待做的流程,不是已经上线的按钮。
我准备把“个人笔记”和“已发布的共享资料”分开处理。前者允许学习者记录尚未核实的过程,后者必须有人对来源和版本负责;一条内容被纠错后,还要考虑旧切片是否仍留在索引里。否则页面上看见的是新文件,检索时命中的可能还是旧说法。这是知识库比普通文件夹难维护的地方,也是我不敢现在就做“大家上传后自动汇总”的原因。
没有重写后台,先把学习路径接到真实数据上
我用的是 Open WebUI v0.11.3。它已有会话、鉴权和知识库能力,所以这轮改动集中在 Svelte 前端:总览、AI 学习、学习记录、共建知识库、共学进度、服务工作台被放进同一条导航;旧会话和高级工具没有删掉。这个决定省下了重写后端和迁移数据的工作,但页面必须继续按原有 API 和权限来取数。
总览页刚好暴露一个容易被忽略的问题:笔记和知识库是两个请求。如果其中一个失败,不能把整页一起判死,也不能默默展示零。下面是 overview/+page.svelte 中缩减过的生产代码片段:
const [noteResult, knowledgeResult] = await Promise.allSettled([
  searchNotes(token, null, null, null, 'updated_at', 1, 'desc'),
  searchKnowledgeBases(token, null, null, 1)
]);

if (noteResult.status === 'fulfilled') notes = noteResult.value?.items ?? [];
else dataError = true;

if (knowledgeResult.status === 'fulfilled') knowledge = knowledgeResult.value?.items ?? [];
else dataError = true;
这样至少能分开处理两份结果。进度页读不到数量时显示 —,不伪造一个 0;服务工作台入口仍按管理员角色控制。页面能显示真实笔记和知识库,不代表笔记已自动进入共享库,更不代表权限矩阵已经被多人走通。
这里有一个源码层面的细节值得单独说。Promise.allSettled 只保证我拿到两份请求各自的成败,不会自动把 UI 的“失败”和“真为空”分清。当前总览页在失败时仍保留空数组,同时另外显示“部分数据未能读取”的错误提示;单看卡片的空态文案,读者仍可能误会自己没有笔记。进度页走的是另一种策略:两个请求用 Promise.all 同时读取,任意一个失败,就让读不到的数量保持 null,页面显示 —。这两个页面的取舍并不完全一致。若继续完善,我会给每块卡片单独保留 loading / empty / error / data 状态,避免用户要靠页面底部的一句提示判断数据去哪了。
权限也不能只靠侧栏隐藏入口。源码中服务工作台导航用管理员角色判断,这能减少误入,但后端接口是否拒绝普通用户,仍要用普通账号实际请求来验。当前我只有“未登录认证接口返回 401”的证据,没有完成普通成员、编辑者、管理员的整套权限矩阵测试。对共学网站来说,这关系到谁能看个人笔记、谁能改共享资料,比导航上有没有一枚图标更重要。
构建失败之后,我把“可替换的东西”圈小了
前端第一次构建卡在 Node 默认 4GB 堆内存;把上限提高到 6GB 后,Vite 构建用了 1 分 43 秒完成。git diff --check 通过,但仓库已有的 npm run check 基线报错仍在。我能确认的是这次构建物产出了,不能把它写成全量检查通过。
当时的构建命令是 NODE_OPTIONS=--max-old-space-size=6144 npx vite build。调高堆上限只是让这次构建走完,不是性能优化,更不意味着线上机器需要给每个访问者分配 6GB。构建内存、服务器运行内存、模型推理占用是三笔不同的账;把这次 OOM 直接归因于 Ollama,方向就错了。仓库使用的 Node 版本与其声明范围还存在差异,这也被留在接手记录里,下一轮重建应先回到项目支持的版本再核对基线报错。
部署时我只动前端 build/ 和自定义样式。知识库文件、Open WebUI 数据和 Ollama 模型不在这个替换范围内。PowerShell 脚本先核对包的 SHA-256,再备份旧前端;复制新文件失败就把旧前端移回去。核心操作缩成下面几行,机器上的私有路径没有放进文章:
# 生产脚本的缩减片段;路径已匿名化
if ($actualHash -ne $expectedHash) { throw 'SHA-256 mismatch' }
Move-Item $currentFrontend $backupFrontend -ErrorAction Stop
try {
    Copy-Item $sourceFrontend $currentFrontend -Recurse -ErrorAction Stop
} catch {
    Move-Item $backupFrontend $currentFrontend -ErrorAction Stop
    throw
}
脚本退出码为 0,/overview 返回 200。我随后在 Windows 浏览器打开总览、AI 学习、笔记、知识库、进度和服务页,旧笔记与知识库仍可读。本轮没有重启 Open WebUI,也没有动模型或数据目录。这里的回滚只管前端文件;真要开放投稿,数据备份与恢复还得另做演练。
这个脚本也有明确边界,不能因为它叫“部署脚本”就以为所有异常都会自动回退。包哈希在复制前阻止错包;复制阶段抛错会恢复旧前端和旧 CSS。CSS 复制后的哈希检查如果失败,会报错并留下备份,但那段逻辑不在自动回滚的 catch 里;/overview 的 HTTP 探测即使失败,也会被记录为健康检查失败,而不是自动恢复旧版。部署后的视觉错位、旧资源缓存、知识库按钮不能点,更需要人工选择备份并复验。这些是我读完脚本后才敢写下的准确范围。
还有一个交接风险:运行中的前端已经更新,但 Windows 上保存的源码目录没有叠加这一轮 v2 补丁。以后若直接拿那个旧目录重新构建,页面可能“回到过去”。所以接手时要同时核对运行构建物、对应源码版本、部署包哈希和回滚备份,不能只看一个 build/ 文件夹。这里并不是发布了一个可复现的全自动流水线,而是把这次在线替换的证据和恢复路径留完整。
另一个 200,把我拉回了入口本身
局域网里另一台设备访问 3000/overview,能到共学页面;同一台设备访问预备入口 8080/,拿到的是占位页。页上的按钮还写着 http://localhost:3000。对访问者来说,localhost 是他自己的电脑,不是运行网站的那台 Windows 机器。这个响应还缺正确的 Content-Type。修正页已经准备过,但当时尚未替换正式入口,问题没有结束。
于是这轮验收停在很具体的位置:未登录认证请求返回 401,Ollama 的 11434 和运维端口没有向局域网开放;3000 上的页面可以从另一台设备访问。固定公网入口、外网登录、流式回答、知识库检索和百人容量都没有通过验收。临时公网地址曾基本可达,我没有据此写“网站正式上线”。
公网试验还给了我一个不能用“服务器性能差”草率解释的现象。本机探测首页约 53 ms、配置接口约 61 ms;通过临时隧道回访同类请求,样本约为 1677 ms 和 1123 ms。外网 HTML 的 200 也不等于首屏快:页面还要取多份脚本和样式,往返时间会叠加。这组样本只支持“公网链路值得优先排查”,还没有浏览器瀑布图,也没有同条件多人测试,不能算性能定论。下一步应分别记录本机、局域网和真正外网的首页、配置接口、首屏静态资源耗时,再决定是换稳定入口,还是缩前端资源。
目前的公网地址来自临时通道,可能变化;想要固定 HTTPS 地址,还需要独立的入口方案和外网验收。即便入口固定了,也要从外网完成登录、聊天流式响应、文档上传与检索、重启恢复测试。Ollama API 和运维工作台不该因为网页要公开就一起暴露。这里的 401 只证明当次匿名请求被挡住,不能替代密码强度、注册策略或成员权限检查。
下次再遇到两个 200,我会先看响应正文和跳转地址,再用访问者的设备点一遍;状态码放在后面看。接下来这个项目也得按这个顺序继续:修正 8080,拿一份可核对的资料做三问测试,最后再谈多人使用。最初想让别人少走一点我走过的弯路,现在我还不能把链接放心地发给一百个人。把这句话留下来,比把目标数字做成首页大字更诚实。