RAG 知识库搭建与语义检索完整链路
让大模型回答企业内部资料中的问题,不能只依赖模型训练阶段获得的知识,还需要一条稳定的外部知识检索链路。一个可用的 RAG 系统既要完成文件解析、文本分片和向量化,也要处理元数据管理、语义召回与上下文注入。下面将结合 SeaPack 的实现,拆解从文档入库到知识增强对话的完整流程。
前言
本文是 SeaPack 项目技术系列的第六篇,聚焦 RAG(检索增强生成) 的完整实现——从文档上传、文本解析、分片向量化到语义检索,再到检索结果如何注入 LLM 对话上下文。在第五篇「通用 LLM 流式对话」的基础上,本文补全了知识库这一关键拼图:让大模型不再只靠自身参数回答问题,而是能查阅企业私有文档给出准确回复。
阅读收益:如果你正在搭建 RAG 系统,想搞清楚「文档如何变成向量」「检索如何命中相关片段」「检索结果如何注入 Prompt 让 LLM 基于知识库回答」这几个核心问题,这篇文章会给你一个从文件上传到知识增强对话的完整链路。
访问地址:http://124.222.194.201/
前端代码:github.com/seapack-hub…
后端代码:github.com/seapack-hub…
前置文章:
第五篇:通用 LLM 流式对话:前后端联接的完整实现前言 访问地址:http://124.222.194.201/ 前 - 掘金 (juejin.cn)
一、RAG 是什么,为什么需要它
第五篇讲的通用 LLM 对话是「人 → 大模型 → 人」的纯净链路。但大模型有一个天然局限:它的知识截止于训练数据,不了解你企业的内部文档、产品手册、业务规则。
RAG(Retrieval-Augmented Generation)解决的就是这个问题:核心思想是先检索,再生成——把企业私有文档切片存入向量数据库,用户提问时先检索最相关的片段,把这些片段塞进 Prompt 里让大模型"开卷考试"。
两者的区别可以用一句话概括:传统对话是"闭卷考试",RAG 是"带参考书的开卷考试"。下面的对比展示了数据流的差异:
传统 LLM 对话:  用户提问 ──→ 大模型(凭记忆回答)──→ 回复
RAG 增强对话:   用户提问 ──→ 检索知识库 ──→ 相关片段 + 问题 ──→ 大模型(基于片段回答)──→ 回复
二、整体架构
2.1 双存储引擎架构
SeaPack 的 RAG 系统采用双存储引擎架构:MySQL 负责结构化数据的 CRUD 和状态管理,ChromaDB 负责向量存储和语义检索,两者通过 vectorId 字段桥接。这种设计让关系型数据和向量数据各司其职,既保证了管理的灵活性,又保证了检索的性能。
具体的职责分工是:MySQL 存储知识库、文档、分片的元数据(名称、状态、统计等),ChromaDB 存储文本的向量嵌入(用于语义相似度检索)。两个数据库之间通过 ai_knowledge_chunk 表的 vector_id 字段关联——这个字段存储的是 ChromaDB 中对应向量记录的唯一 ID。
┌─────────────────────────────────────────────────────────────────---┐
│                      SeaPack RAG 系统                              │
├─────────────────────────────────────────────────────────────────   ┤
│                                                                    │
│    MySQL(关系型数据库)                 ChromaDB(向量数据库)      │
│   ┌─────────────────────┐             ┌─────────────────────┐      │
│   │ ai_knowledge_base    │            │ Collection:         │      │
│   │ ai_knowledge_document│◄─vectorId─►│  knowledge_1        │      │
│   │ ai_knowledge_chunk   │            │  knowledge_2        │      │
│   └─────────────────────┘             │  ...                │      │
│                                       └─────────────────────┘      │
│   职责:CRUD、分页、状态管理            职责:向量存储、相似度检索     │
│                                                                    │
│   核心理念:MySQL 管数据,ChromaDB 管检索,通过 vectorId 桥接         │
└─────────────────────────────────────────────────────────────────----┘
2.2 三表关系
知识库的数据模型由三I张表组成,形成 知识库 → 文档 → 分片 的三层结构**。**
知识库是最高层级的容器,一个知识库下可以包含多个文档(如产品手册、FAQ 等),每个文档在向量化后会被拆分成多个分片。分片是检索的最小粒度,每条分片记录通过 vector_id 关联到 ChromaDB 中的向量。
vector_id 是 MySQL 与 ChromaDB 之间的桥梁:从 MySQL 分片记录可以定位到 ChromaDB 中的向量,从 ChromaDB 检索结果可以反查 MySQL 中的完整元数据。
ai_knowledge_base (知识库)
  ├── 1:N ── ai_knowledge_document (文档)
  │              ├── file_path → 本地磁盘文件
  │              ├── parse_status → 解析状态
  │              └── vector_status → 向量化状态
  │
  └── 1:N ── ai_knowledge_chunk (分片)
                 ├── vector_id → ChromaDB Record ID(桥接字段)
                 ├── content → 文本内容
                 └── chunk_index → 分片序号
知识库主表 ai_knowledge_base
CREATE TABLE ai_knowledge_base (
  id              BIGINT AUTO_INCREMENT PRIMARY KEY COMMENT '主键',
  name            VARCHAR(100) COMMENT '知识库名称',
  code            VARCHAR(50) COMMENT '知识库编码(唯一)',
  description     VARCHAR(500) COMMENT '知识库描述',
  icon            VARCHAR(50) COMMENT '图标',
  embedding_model VARCHAR(100) COMMENT '向量化模型编码',
  chunk_size      INT DEFAULT 500 COMMENT '分片大小(字符数)',
  chunk_overlap   INT DEFAULT 50 COMMENT '分片重叠字符数',
  separator       VARCHAR(20) COMMENT '分片分隔符',
  document_count  INT DEFAULT 0 COMMENT '文档总数(实时计算)',
  chunk_count     INT DEFAULT 0 COMMENT '分片总数(实时计算)',
  total_tokens    BIGINT DEFAULT 0 COMMENT '总 Token 消耗(实时计算)',
  status          INT DEFAULT 1 COMMENT '状态:1启用 0禁用',
  sort_order      INT DEFAULT 0 COMMENT '排序号',
  created_by      BIGINT COMMENT '创建人',
  created_at      DATETIME COMMENT '创建时间',
  updated_at      DATETIME COMMENT '更新时间'
);
文档表 ai_knowledge_document
CREATE TABLE ai_knowledge_document (
  id              BIGINT AUTO_INCREMENT PRIMARY KEY COMMENT '主键',
  knowledge_id    BIGINT COMMENT '所属知识库ID',
  file_name       VARCHAR(200) COMMENT '原始文件名',
  file_path       VARCHAR(500) COMMENT '存储路径',
  file_size       BIGINT COMMENT '文件大小(字节)',
  file_type       VARCHAR(20) COMMENT '文件类型:txt/pdf/docx/md',
  content_type    VARCHAR(100) COMMENT 'MIME 类型',
  parse_status    INT DEFAULT 0 COMMENT '解析状态:0待解析 1解析中 2成功 3失败',
  vector_status   INT DEFAULT 0 COMMENT '向量化状态:0待处理 1处理中 2成功 3失败',
  chunk_count     INT COMMENT '生成分片数',
  token_count     BIGINT COMMENT '文档总 Token 数',
  error_message   VARCHAR(1000) COMMENT '错误信息',
  extra_metadata  JSON COMMENT '扩展元数据',
  created_by      BIGINT COMMENT '上传人',
  created_at      DATETIME COMMENT '上传时间',
  updated_at      DATETIME COMMENT '更新时间'
);
分片表 ai_knowledge_chunk
CREATE TABLE ai_knowledge_chunk (
  id              BIGINT AUTO_INCREMENT PRIMARY KEY COMMENT '主键',
  knowledge_id    BIGINT COMMENT '所属知识库ID',
  document_id     BIGINT COMMENT '来源文档ID',
  vector_id       VARCHAR(100) COMMENT '向量数据库 Record ID(关联 ChromaDB)',
  chunk_index     INT COMMENT '分片序号(从0开始)',
  content         TEXT COMMENT '分片文本内容',
  token_count     INT COMMENT '分片 Token 数',
  source_page     INT COMMENT '来源页码(PDF适用)',
  source_section  VARCHAR(200) COMMENT '来源章节标题',
  extra_metadata  JSON COMMENT '扩展元数据',
  created_at      DATETIME COMMENT '创建时间'
);
2.3 两条 RAG 对话路径
系统中存在两条路径将知识库检索注入 LLM 对话。
- 路径 A 是最简单的实现:前端在发送消息前先调用检索 API,拿到相关片段后直接拼接到 system prompt 中,然后走通用 LLM 流式对话。
- 路径 B 是更完整的实现:Agent 关联多个知识库,在后端四步流水线的第二步统一检索,检索结果由后端拼接到 system prompt 中。
两条路径互补——路径 A 适合快速验证和简单场景,路径 B 适合企业级 Agent 的完整 RAG 链路。
| 路径 | 入口 | 检索执行方 | 注入位置 | 适用场景 |
|---|---|---|---|---|
| 路径 A:前端驱动 | ChatInterface.vue | 前端调后端 retrieve API | 前端修改 system prompt | 简单的通用对话 + 知识库 |
| 路径 B:Agent 驱动 | AgentTestChatService | 后端 Agent 四步流水线 | 后端拼接到 system prompt | Agent 模式下的完整 RAG 链路 |
三、知识库构建:从文件到向量
知识库构建是 RAG 系统的基础设施——把用户上传的文档变成可供检索的向量。整个过程可以概括为四个阶段:文件存储 → 文本解析 → 分片向量化 → 双库入库。具体来说:
- 文件存储:用户上传文件后,文件被保存到磁盘,同时在 MySQL 中创建文档记录(状态标记为"待解析")
- 文本解析:根据文件类型(txt/pdf/docx/md)调用相应的解析器,提取纯文本内容
- 分片向量化:将长文本按段落分片(默认 500 字符一片,50 字符重叠),然后对每个分片调用 Embedding 模型生成向量
- 双库入库:向量存入 ChromaDB(返回 vectorId),分片记录存入 MySQL(记录 vectorId),最后更新文档状态和知识库统计
整个过程通过 @Async 异步执行,前端通过 SSE 订阅实时进度。
3.1 构建流程全景
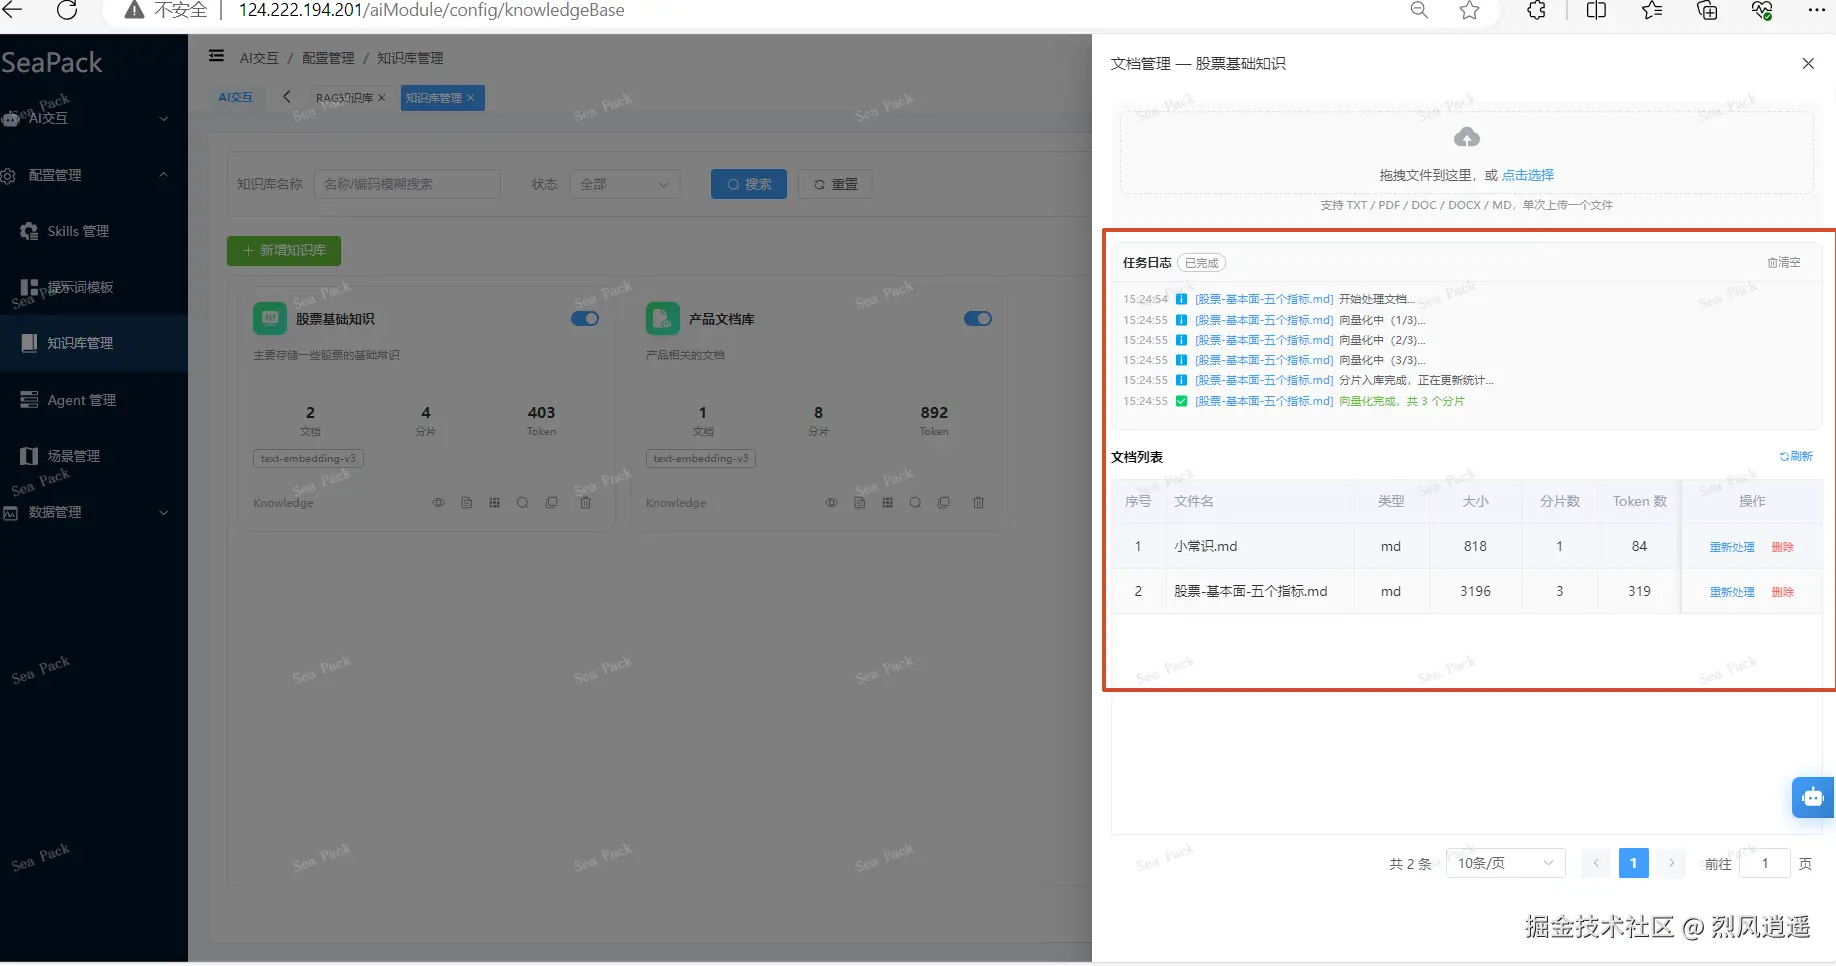
下面的流程图展示了从文件上传到向量化完成的完整链路。上部是 KnowledgeBaseService 负责的文件存储和任务触发,下部是 KnowledgeVectorService 负责的解析、分片、向量化和入库。
注意中间穿插的 pushProgress 调用——这些是通过 VectorProgressManager 向前端推送 SSE 进度事件,让前端的文档管理抽屉能实时展示处理进度。
用户上传文件 (txt/pdf/docx/md)
    │
    ▼
KnowledgeBaseService.uploadDocumentWithToken()
    ├── 1. 保存文件到磁盘: uploads/knowledge/{knowledgeId}/{uuid}.ext
    ├── 2. 创建 document 记录(parse_status=0, vector_status=0)
    ├── 3. 生成 taskToken,注册到 VectorProgressManager
    └── 4. 触发 @Async asyncVectorizeFromFile()
              │
              ▼
KnowledgeVectorService.asyncVectorizeFromFile()
    ├── 1. 推送进度: parsing(10%)
    ├── 2. FileParserUtil.parseFile() 解析文档文本
    ├── 3. 推送进度: splitting(30%)
    ├── 4. DocumentByParagraphSplitter 按配置分片
    ├── 5. 推送进度: vectorizing(40%→90%)
    ├── 6. 循环每个分片:
    │       ├── embeddingModel.embed(segment.text()) → 向量化
    │       ├── 构建 Metadata(knowledgeId, documentId, chunkIndex)
    │       ├── store.add(embedding, TextSegment) → 存入 ChromaDB,返回 vectorId
    │       └── 构建 KnowledgeChunk(含 vectorId)
    ├── 7. chunkMapper.batchInsert(chunks) → 批量写入 MySQL
    ├── 8. 推送进度: saving(95%)
    ├── 9. 更新文档状态(parse_status=2, vector_status=2)
    ├── 10. 更新知识库统计(document_count, chunk_count, total_tokens)
    └── 11. 推送完成: done(100%)
效果图:
3.2 关键代码:向量化并存入 ChromaDB
上一节的流程图中,步骤 6 循环每个分片向量化并存入 ChromaDB 是整个构建过程最核心的环节。
下面这段代码展示了这个循环的具体实现:对每个文本分片,先调用 Embedding 模型生成向量,然后构建元数据(记录这条向量属于哪个知识库、哪个文档、是第几个分片),最后将向量和文本一起存入 ChromaDB,拿到返回的 vectorId。
元数据的核心作用是在检索时提供过滤和定位能力。向量负责 "语义匹配"(找到语义相近的文本),元数据负责 "精确过滤"(确保只在指定的知识库和文档中搜索)。
// KnowledgeVectorService.java — asyncVectorizeFromFile()
for (int i = 0; i < segments.size(); i++) {
    TextSegment segment = segments.get(i);

    // 1. 调用 Embedding 模型,将文本转为高维浮点向量
    Embedding embedding = embeddingModel.embed(segment.text()).content();

    // 2. 构建元数据(用于检索时过滤和定位)
    Metadata metadata = new Metadata();
    metadata.put("knowledgeId", String.valueOf(knowledgeId));
    metadata.put("documentId", String.valueOf(documentId));
    metadata.put("chunkIndex", String.valueOf(i));

    // 3. 存入 ChromaDB,返回唯一 vectorId
    String vectorId = store.add(
            embedding,
            TextSegment.from(segment.text(), metadata)
    );

    // 4. 保存分片记录,vectorId 是桥接字段
    KnowledgeChunk chunk = new KnowledgeChunk();
    chunk.setVectorId(vectorId);
    chunk.setContent(segment.text());
    chunks.add(chunk);
}
// 5. 批量写入 MySQL
chunkMapper.batchInsert(chunks);
3.3 ChromaDB 基础设施
向量化和检索都依赖 ChromaDB 基础设施,它由两个核心组件构成:EmbeddingModel(文本向量化模型)和 EmbeddingStore(向量存储实例)。
Collection 命名策略
SeaPack 采用每个知识库一个独立 Collection 的策略,而非所有知识库共享一个 Collection。Collection 名称格式为 knowledge_{knowledgeId}(如 knowledge_1、knowledge_2)。这样做的好处是数据天然隔离——删除一个知识库时直接删除对应的 Collection 即可,不会影响其他知识库。同时,ChromaDB 在 Collection 级别就有物理隔离,检索时不需要额外的过滤条件,性能更好。
getEmbeddingStore 方法通过 ConcurrentHashMap 缓存已创建的 EmbeddingStore 实例,避免重复创建:
// ChromaDbConfig.java
public EmbeddingStore<TextSegment> getEmbeddingStore(Long knowledgeId) {
    String collectionName = chromaProperties.getCollectionName(knowledgeId);
    // 如 knowledge_1, knowledge_2

    return storeCache.computeIfAbsent(collectionName, name -> {
        return ChromaEmbeddingStore.builder()
                .baseUrl(chromaProperties.getBaseUrl())
                .collectionName(name)
                .build();
    });
}
优势:数据隔离、便于管理、支持独立的向量配置。
EmbeddingModel 创建
文本模型和向量模型可以来自不同的提供商。比如对话用 mimo(速度快),向量化用 aliyun(精度高),通过配置文件中的 ai.embedding-provider 项分离。如果未配置 embedding-provider,则回退到 active-provider(即当前活跃的对话模型提供商)。
// ChromaDbConfig.java
@Bean("embeddingModel")
public EmbeddingModel embeddingModel() {
    String providerName = aiProperties.getEmbeddingProvider();
    if (providerName == null || providerName.isEmpty()) {
        providerName = aiProperties.getActiveProvider();
    }
    AIProperties.ProviderConfig config = aiProperties.getProviders().get(providerName);

    return OpenAiEmbeddingModel.builder()
            .apiKey(config.getApiKey())
            .baseUrl(config.getBaseUrl())
            .modelName(config.getEmbeddingModel())
            .build();
}
3.4 SSE 实时进度推送
向量化是异步操作(可能耗时数十秒),前端需要实时感知处理进度。整体机制是:
- 前端上传文件后,后端返回一个
taskToken; - 前端用这个 token 订阅 SSE 进度端点
- 后端在向量化的各个阶段通过
VectorProgressManager推送进度事件。
进度推送分为五个阶段:
- 解析(parsing, 10%)
- 分片(splitting, 30%)
- 向量化(vectorizing, 40%~90%,每处理一个分片更新一次)
- 入库更新(saving, 95%)
- 完成(done, 100%)
如果任何阶段失败,会推送 error 事件(progress: -1)。
前端上传文件
    │
    ├── 后端返回 { doc, taskToken }
    │
    └── 前端订阅: GET /ai/knowledge/vector-progress?taskToken=xxx
                    │
                    ▼
              VectorProgressManager
                    │
    ┌───────────────┼───────────────┐
    │               │               │
    ▼               ▼               ▼
  解析阶段        分片阶段        向量化阶段
  push("parsing") push("splitting") push("vectorizing")
  progress: 10    progress: 30     progress: 40~90
    │               │               │
    └───────────────┴───────────────┘
                    │
                    ▼
              完成/失败
              complete(done/error)
              progress: 100/-1
| phase | 含义 | 进度范围 |
|---|---|---|
parsing | 文档解析中 | 0~30 |
splitting | 分片处理中 | 30~40 |
vectorizing | 向量化中 | 40~90 |
saving | 入库更新中 | 90~95 |
done | 完成 | 100 |
error | 失败 | -1 |
四、知识库检索:从查询到相关片段
检索是 RAG 的核心环节——根据用户的问题,从知识库中找到最相关的文本片段。整个检索过程可以概括为三步:查询向量化 → 向量相似度搜索 → 结果转换。当向量检索失败时,系统会自动降级为 MySQL 关键词匹配,确保服务可用性。
4.1 检索流程
检索入口是 KnowledgeBaseService.retrieve(),它先尝试调用向量检索(KnowledgeVectorService.retrieve()),如果向量检索抛出异常(比如 ChromaDB 不可用),则自动降级为 MySQL LIKE 关键词匹配。
向量检索的核心是 store.findRelevant()——将查询文本同样转为向量,然后在 ChromaDB 中计算与所有存储向量的余弦相似度,返回最相似的 topK 条结果(相似度阈值为 0.5)。
用户输入查询文本 "如何配置权限"
    │
    ▼
KnowledgeBaseService.retrieve(knowledgeId, query, topK)
    │
    ├── 尝试: knowledgeVectorService.retrieve(knowledgeId, query, topK)
    │         │
    │         ▼
    │   KnowledgeVectorService.retrieve()
    │       ├── 1. 获取 EmbeddingStore
    │       ├── 2. embeddingModel.embed(query) → 查询向量化
    │       ├── 3. store.findRelevant(queryEmbedding, topK, 0.5)
    │       │      → 返回 List<EmbeddingMatch<TextSegment>>
    │       └── 4. 转换为 RetrievalResult(content + score)
    │
    └── 降级: catch → retrieveByKeyword(knowledgeId, query, topK)
              → MySQL LIKE 模糊匹配,分数按排名递减
4.2 核心代码:向量检索
下面这段代码是向量检索的具体实现。findRelevant 方法内部会执行四个步骤:
- 将查询向量与库中所有向量计算余弦相似度
- 按相似度从高到低排序
- 剔除低于 minScore(0.5)的结果
- 返回前 topK 条。
返回的每个 EmbeddingMatch 对象包含三个关键信息:匹配到的文本内容(embedded().text())、相似度分数(score(),0.0~1.0)、以及向量记录 ID。
// KnowledgeVectorService.java
public List<RetrievalResult> retrieve(Long knowledgeId, String query, Integer topK) {
    // 1. 获取该知识库的 EmbeddingStore
    EmbeddingStore<TextSegment> store = chromaDbConfig.getEmbeddingStore(knowledgeId);

    // 2. 将查询文本向量化
    Embedding queryEmbedding = embeddingModel.embed(query).content();

    // 3. ChromaDB 向量相似度检索(返回最相似的 topK 条)
    List<EmbeddingMatch<TextSegment>> matches =
            store.findRelevant(queryEmbedding, topK, 0.5);

    // 4. 转换为业务层对象
    List<RetrievalResult> results = new ArrayList<>();
    for (EmbeddingMatch<TextSegment> match : matches) {
        RetrievalResult result = new RetrievalResult();
        result.setContent(match.embedded().text());   // 分片文本
        result.setScore(match.score());                // 0.0~1.0 相似度
        results.add(result);
    }
    return results;
}
4.3 降级机制
生产环境中,向量数据库可能出现网络波动或服务不可用的情况。为了保证用户体验不中断,系统设计了自动降级机制:当向量检索抛出异常时,自动切换到 MySQL LIKE 关键词匹配作为兜底方案。降级方案的相似度分数按排名递减(1.0 - i * 0.1),虽然语义匹配效果不如向量检索,但能确保用户始终得到响应。
// KnowledgeBaseService.java
public List<RetrievalResult> retrieve(Long knowledgeId, String query, Integer topK) {
    try {
        return knowledgeVectorService.retrieve(knowledgeId, query, topK);
    } catch (Exception e) {
        log.warn("向量检索失败,降级为关键词匹配: {}", e.getMessage());
        return retrieveByKeyword(knowledgeId, query, topK);
    }
}
五、RAG 注入对话:两条路径详解
前面第四节讲了"如何从知识库中检索相关片段",这一节要解决的是 "检索到的片段如何注入 LLM 的对话上下文" 。核心思路是将检索结果拼接到 system prompt 中,让大模型在回答时能"看到"这些参考资料。
两条路径的本质区别在于谁来执行检索和注入:路径 A 由前端在发送消息前完成检索和注入,路径 B 由后端在 Agent 四步流水线中完成。
5.1 路径 A:前端驱动 RAG(ChatInterface.vue)
这是最直接的 RAG 路径。当用户在对话界面选中了一个知识库后,ChatInterface.vue 会在发送消息前先调用检索 API,拿到相关片段后拼接到 system prompt 末尾,然后走通用 LLM 流式对话(复用第五篇的 executeLlmStream)。
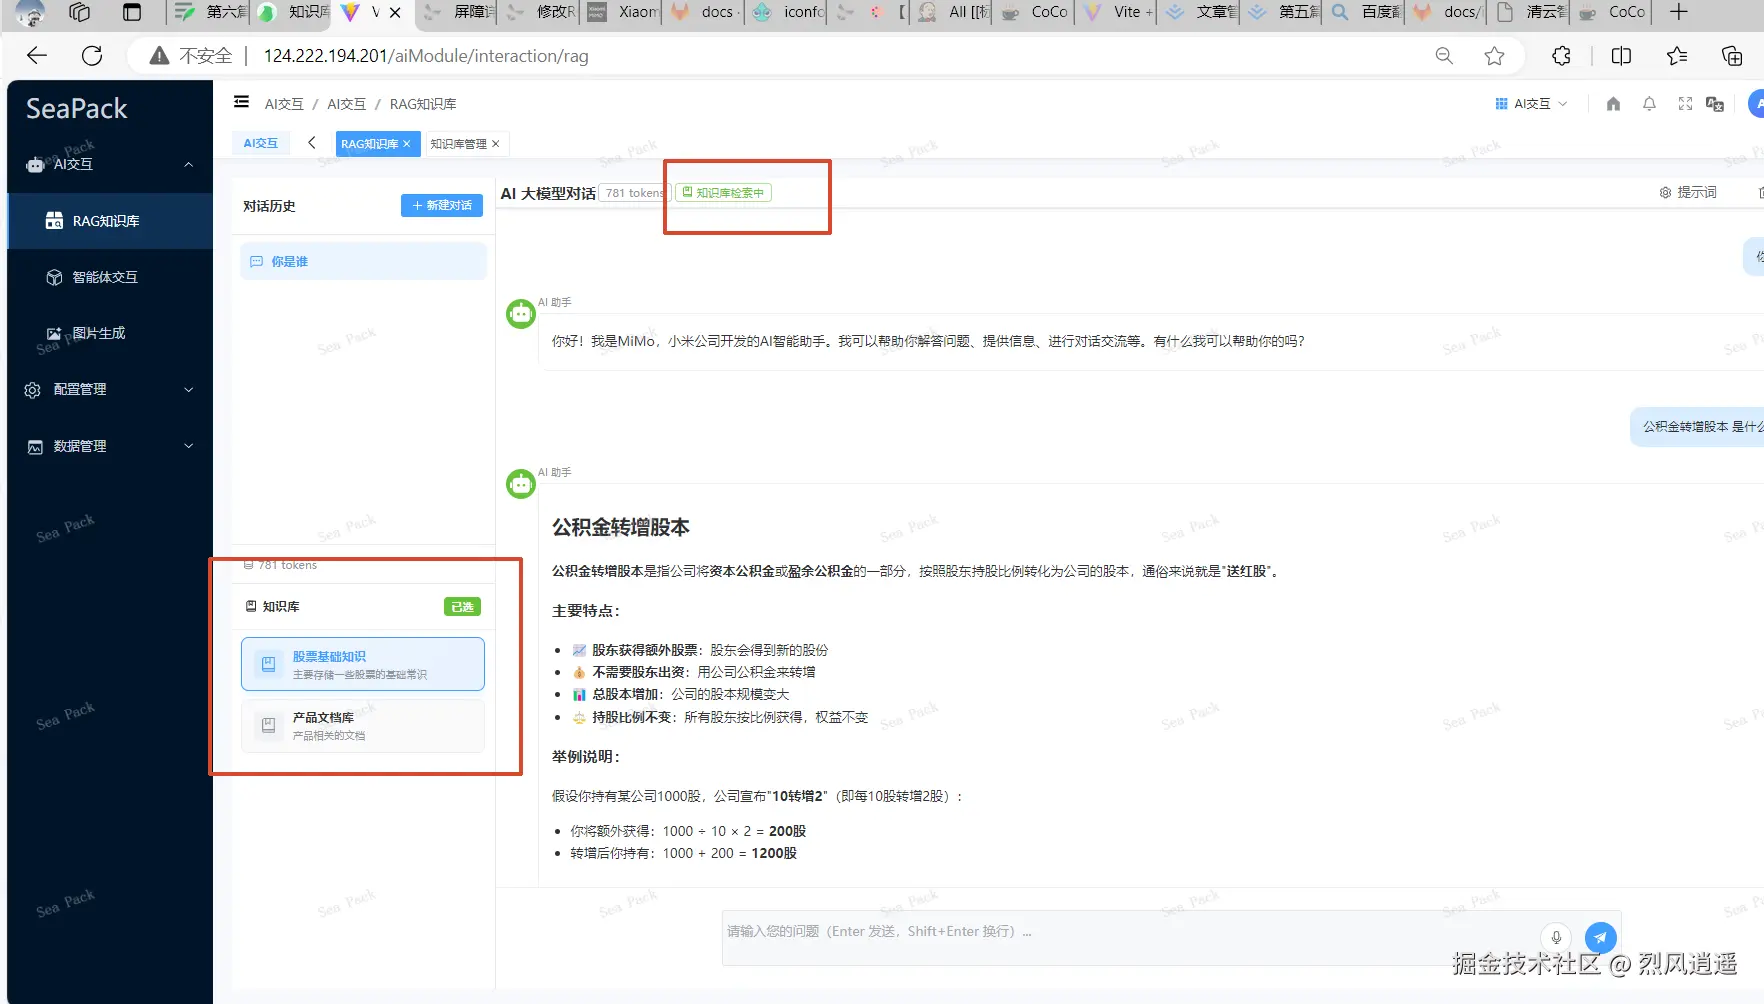
整个流程可以用一句话概括:前端先检索,再发送。具体步骤是:
- 用户输入问题,前端获取上下文消息(含 system prompt + 历史消息)
- 如果当前会话绑定了知识库(
selectedKnowledgeId不为空),调用KnowledgeBaseAPI.retrieve()检索 top-5 相关片段 - 将检索结果用分隔符包裹,追加到 system prompt 末尾
- 用增强后的 messages 调用
executeLlmStream,走正常的 SSE 流式对话 - 如果检索失败,降级为普通对话,不影响用户体验
// ChatInterface.vue — handleSend()
async function handleSend() {
  // 1. 获取上下文消息(含 system prompt + 历史消息)
  let contextMessages = store.getContextMessages();

  // 2. 如果选中了知识库,先检索相关内容
  if (props.selectedKnowledgeId) {
    try {
      const results = await KnowledgeBaseAPI.retrieve(props.selectedKnowledgeId, {
        query: text,
        topK: 5,
      });
      if (results && results.length > 0) {
        // 3. 拼接检索结果
        const knowledgeContext = results
          .map((r, i) => `[${i + 1}] ${r.content}`)
          .join('nn');
        const kbPrompt = `nn--- 以下是知识库中检索到的相关内容 ---
${knowledgeContext}
--- 知识库内容结束 ---`;

        // 4. 注入 system prompt 末尾
        if (contextMessages[0]?.role === 'system') {
          contextMessages[0] = {
            ...contextMessages[0],
            content: contextMessages[0].content + kbPrompt,
          };
        }
      }
    } catch (err) {
      console.warn('知识库检索失败,将直接与大模型对话:', err.message);
    }
  }

  // 5. 用增强后的 messages 调用 LLM(复用第五篇的 executeLlmStream)
  await executeLlmStream(contextMessages, store.namespace, onEvent);
}
设计要点:检索是同步 HTTP 请求(非 SSE),在发送给 LLM 之前完成。知识库内容追加在 system prompt 末尾,用 --- 以下是知识库中检索到的相关内容 --- 分隔符标记边界,让大模型能清晰区分系统指令和参考资料。检索失败时 catch 异常后静默降级,用户无感知。
5.2 路径 B:Agent 驱动 RAG(AgentTestChatService)
Agent 模式下,知识库检索是四步流水线的第二步。与路径 A 不同,这里的检索由后端统一执行,一个 Agent 可以关联多个知识库,检索结果由后端拼接到 system prompt 中。
四步流水线的设计思路是:先组装提示词(决定大模型的角色和行为规则),再检索知识库(补充事实依据),然后执行技能(获取实时数据),最后带着所有上下文调用 LLM。每一步的输出都会追加到 system prompt 中,最终形成一个信息丰富的完整 promp
t。
Step 1: 提示词组装(assemblePrompt)
    │  Agent 基础 prompt + LLM 动态选择的模板
    ▼
Step 2: 知识库检索(retrieveKnowledge)    ← RAG 发生在这里
    │  遍历 Agent 关联的知识库,逐一检索
    │  检索结果追加到 systemPrompt 末尾
    ▼
Step 3: 技能调用(skillExecutor)
    │  执行 Agent 关联的技能
    │  技能结果追加到 systemPrompt 末尾
    ▼
Step 4: LLM 流式调用(callLLMStream)
    │  用最终的 systemPrompt 调用 LLM
    ▼
SSE 流式返回给前端
Step 2 的核心逻辑是遍历 Agent 关联的所有已启用知识库,对每个知识库独立执行检索,然后将所有检索结果按知识库名称分组拼接。每条检索结果带有来源标记(如【产品手册】【FAQ】),让大模型能区分不同来源的信息。
// AgentTestChatService.java — retrieveKnowledge()
private AgentTraceStepResult retrieveKnowledge(Agent agent, String query, int stepIndex, SseEmitter emitter) {
    StringBuilder knowledgeBuilder = new StringBuilder();

    // 1. 获取 Agent 关联的已启用知识库
    List<AgentKnowledge> enabledKnowledge = agentKnowledgeMapper.selectByAgentId(agent.getId())
            .stream()
            .filter(k -> k.getEnabled() != null && k.getEnabled() == 1)
            .collect(Collectors.toList());

    // 2. 遍历每个知识库,逐一检索
    for (AgentKnowledge ak : enabledKnowledge) {
        int topK = ak.getRetrievalCount() != null ? ak.getRetrievalCount() : 3;
        List<RetrievalResult> results = knowledgeBaseService.retrieve(ak.getKnowledgeId(), query, topK);

        if (!results.isEmpty()) {
            knowledgeBuilder.append("【").append(ak.getKnowledgeName()).append("】n");
            for (RetrievalResult r : results) {
                knowledgeBuilder.append("- ").append(r.getContent()).append("n");
            }
        }
    }

    // 3. 返回检索结果文本
    AgentTraceStepResult result = new AgentTraceStepResult();
    result.output = knowledgeBuilder.toString();
    return result;
}
在 testChatStream() 的主流程中,Step 2 完成后检索结果被追加到 system prompt,Step 3 完成后技能结果也被追加。最终传给 LLM 的 system prompt 呈现出一种「层层叠加」的结构:
// Step 2 完成后
if (knowledgeContext != null && !knowledgeContext.isBlank()) {
    systemPrompt += "nn【参考知识】n" + knowledgeContext;
}

// Step 3 完成后
if (skillContext != null && !skillContext.isBlank()) {
    systemPrompt += "nn【技能执行结果】n" + skillContext;
}
最终传给 LLM 的 system prompt 结构如下——从上到下依次是角色定义、业务规则、事实依据、实时数据,大模型基于这个丰富的上下文生成回答:
[Agent 基础提示词]
[选中的模板内容]

【参考知识】
【产品手册】
- 权限配置需要在管理后台...
- 角色分为管理员、普通用户...

【技能执行结果】
- 调用了天气查询技能,返回...
六、前端知识库管理
6.1 页面结构
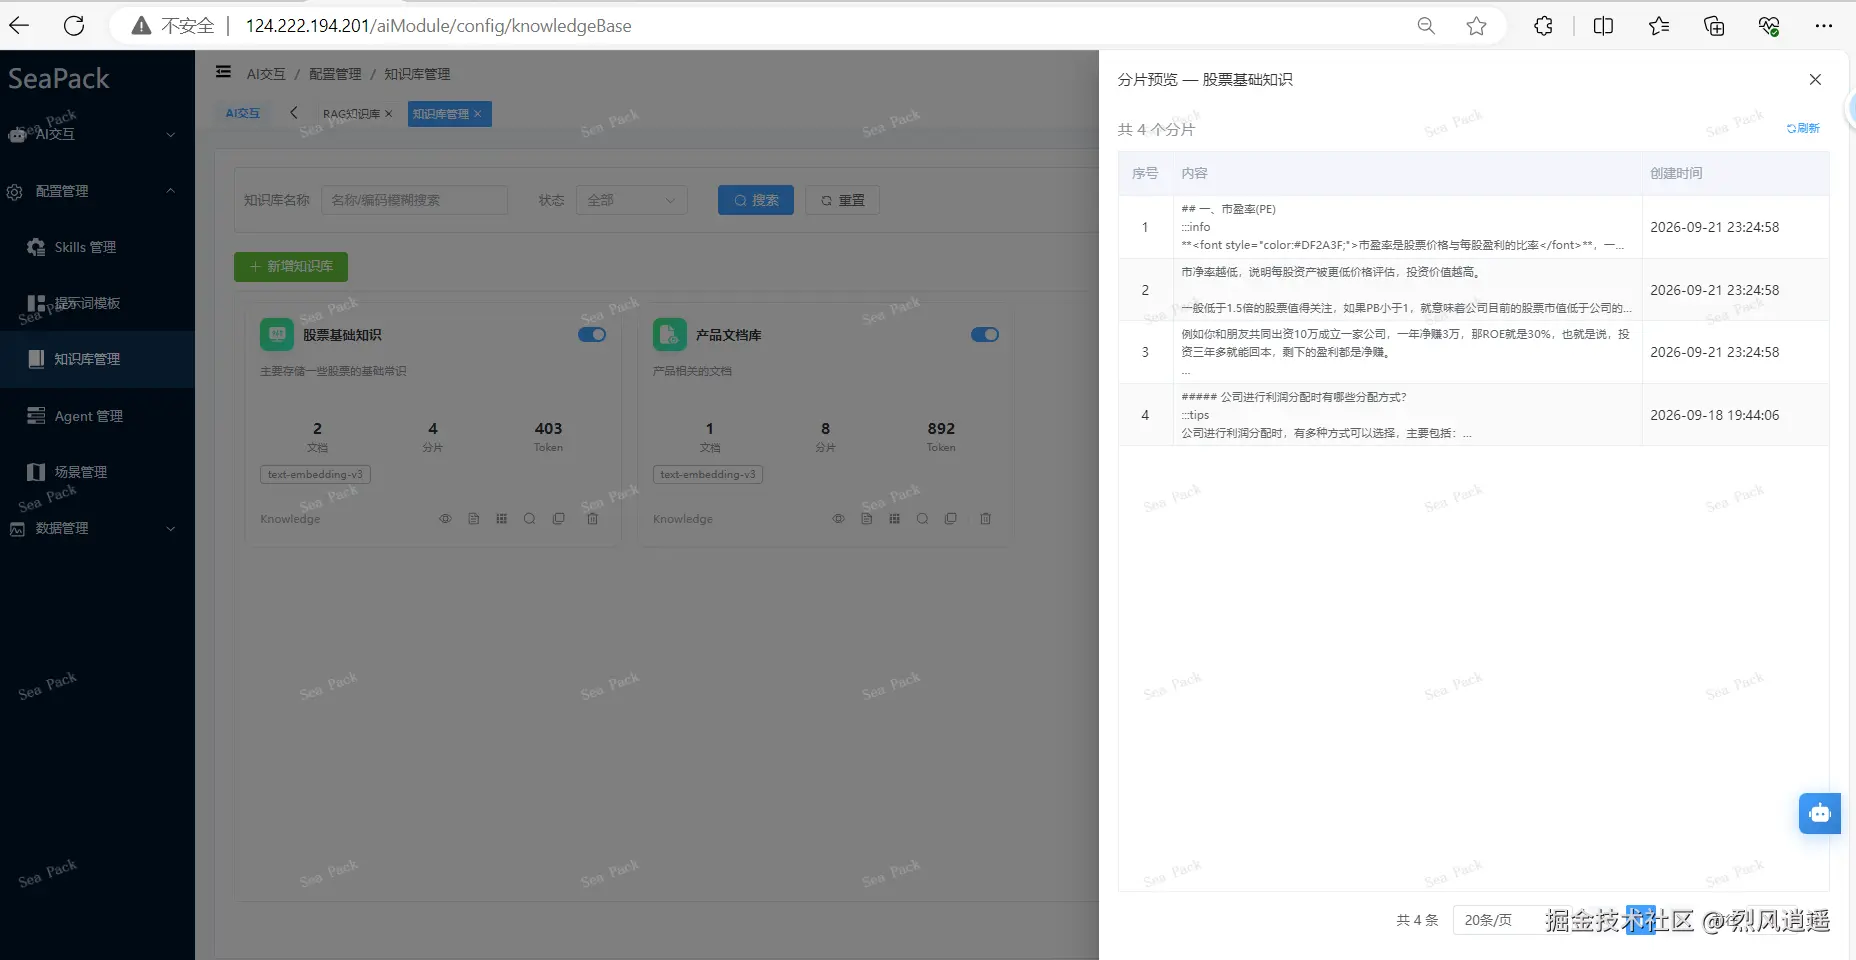
知识库管理页面采用「卡片列表 + 抽屉组件」的交互模式。主页面展示所有知识库的卡片列表(显示文档数、分片数、Token 统计),每个卡片可进入文档管理、分片预览、检索测试三个抽屉。这种设计避免了页面跳转,所有操作都在当前页面内完成。
知识库管理页面 (index.vue)
    │
    ├── KnowledgeBaseCard.vue      → 知识库卡片(文档数/分片数/Token统计)
    ├── KnowledgeBaseFormDialog.vue → 新增/编辑表单
    ├── DocumentListDrawer.vue     → 文档管理抽屉
    │      ├── 文件上传区(拖拽上传)
    │      ├── 实时日志面板(SSE 进度追踪)
    │      └── 文档列表(状态/操作)
    ├── ChunkPreviewDrawer.vue     → 分片内容预览
    └── RetrievalTestDrawer.vue    → 检索测试抽屉
           ├── 查询输入 + topK 设置
           └── 结果列表(含相似度分数)
分片预览
6.2 文档上传与 SSE 进度追踪
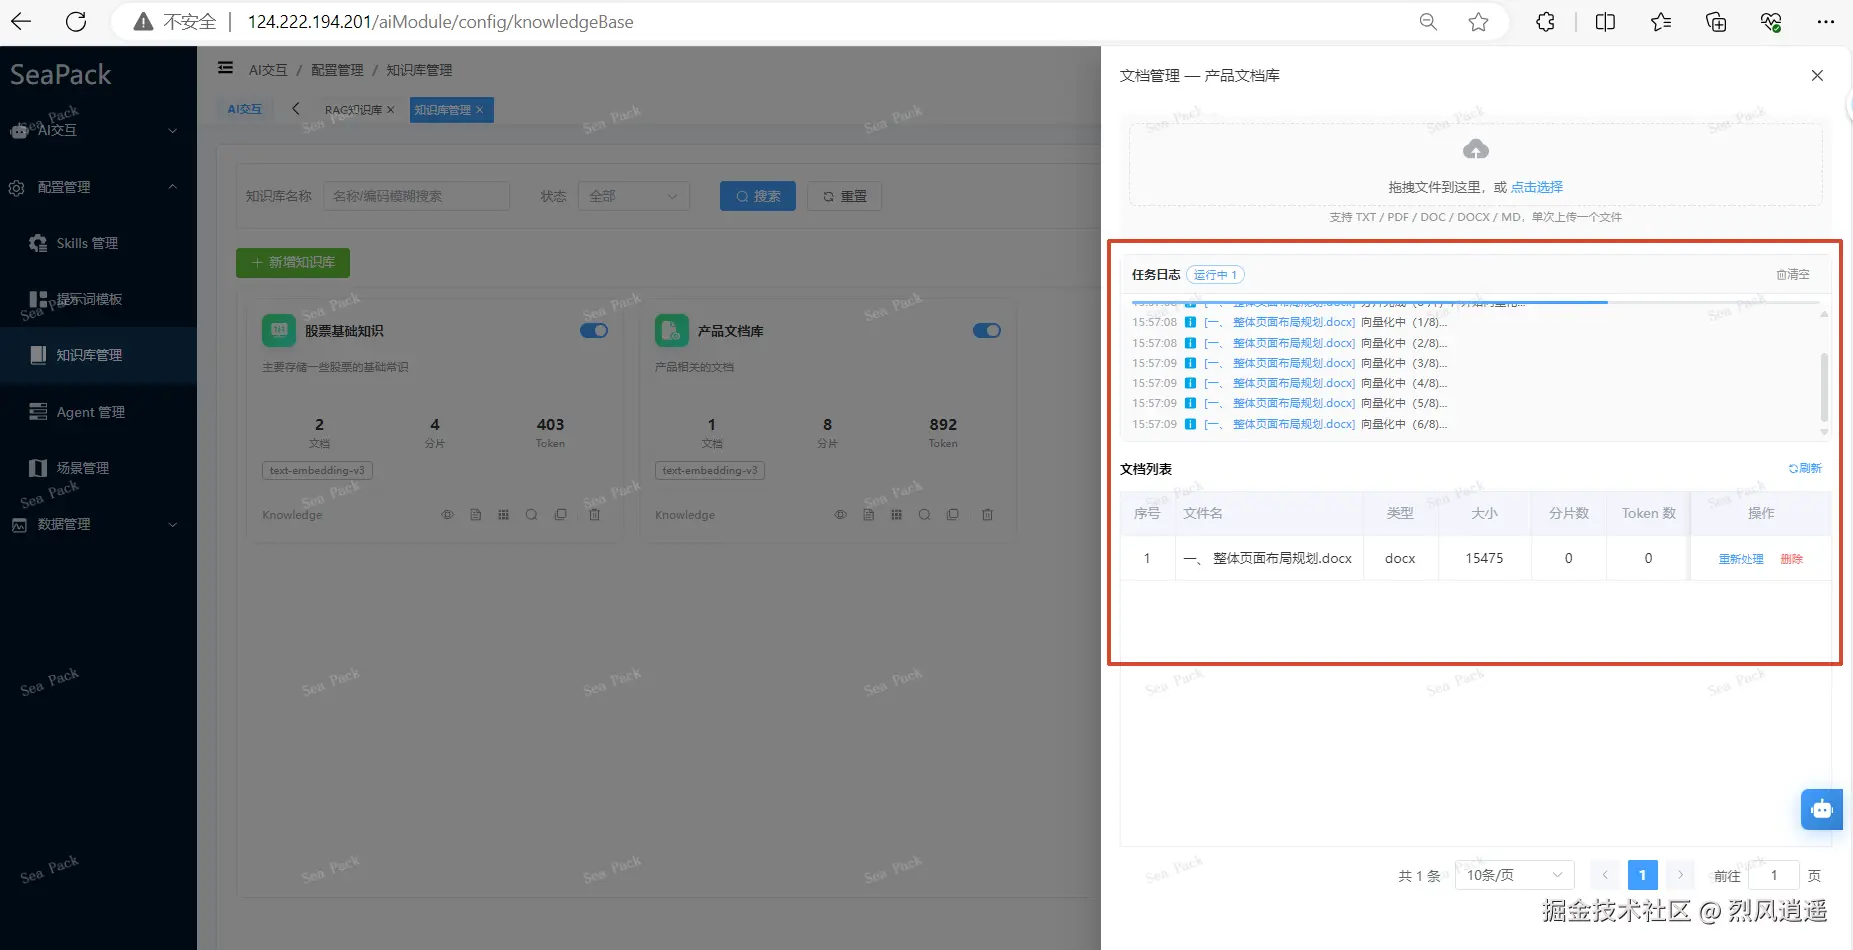
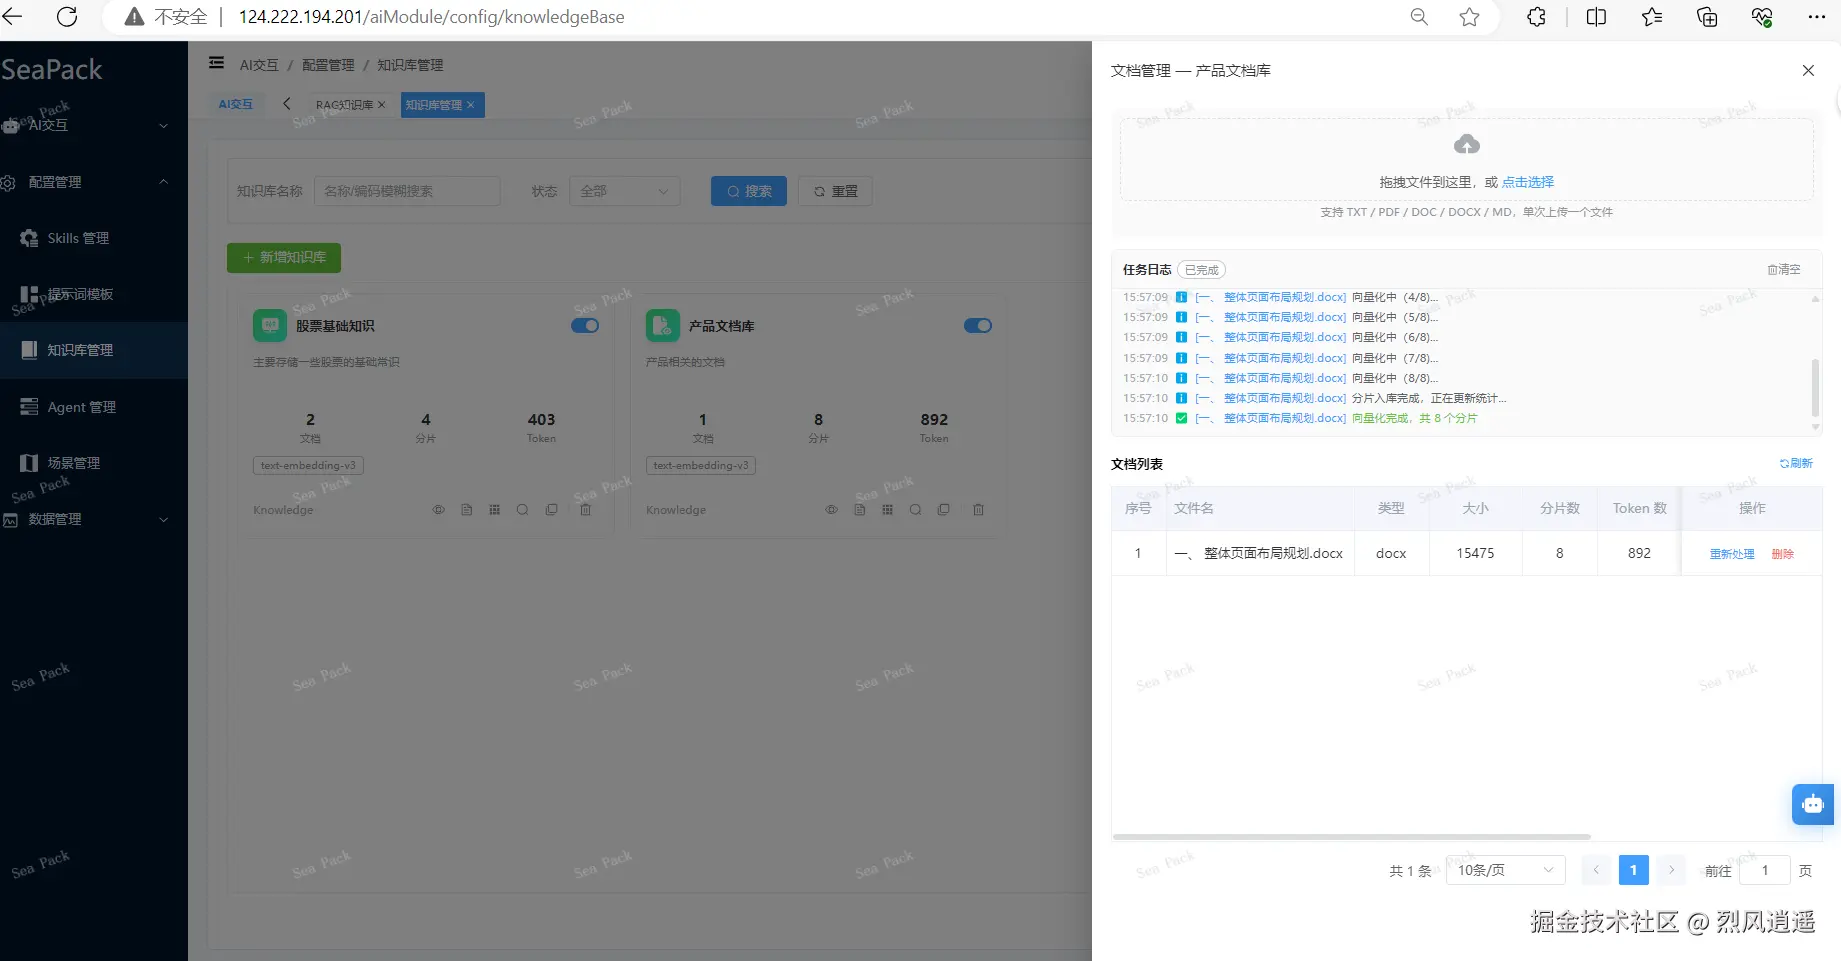
文档上传后,前端通过 fetch + ReadableStream 订阅后端的 SSE 进度端点,实时展示向量化进度。
这个模式和第五篇的 LLM SSE 流式读取器一样——用 buffer 切行解析 data: 前缀的 SSE 事件,每收到一个事件就更新日志面板和进度条。不同的是,这里的 SSE 是后端主动推送的进度通知(而非 LLM 的 token 流)。
// DocumentListDrawer.vue
function subscribeProgress(taskToken: string, fileName: string) {
  const url = `/api/ai/knowledge/vector-progress?taskToken=${taskToken}`

  fetch(url, { headers: { Authorization: `Bearer ${token}` } })
    .then(async (response) => {
      const reader = response.body.getReader()
      const decoder = new TextDecoder()
      let buffer = ''

      while (true) {
        const { done, value } = await reader.read()
        if (done) break

        buffer += decoder.decode(value, { stream: true })
        const lines = buffer.split('n')
        buffer = lines.pop() || ''

        for (const line of lines) {
          if (line.startsWith('data:')) {
            const data = JSON.parse(line.slice(5).trim())
            // 更新日志面板 + 进度条
            handleSseMessage(data, taskToken, fileName)
          }
        }
      }
    })
}
6.3 检索测试
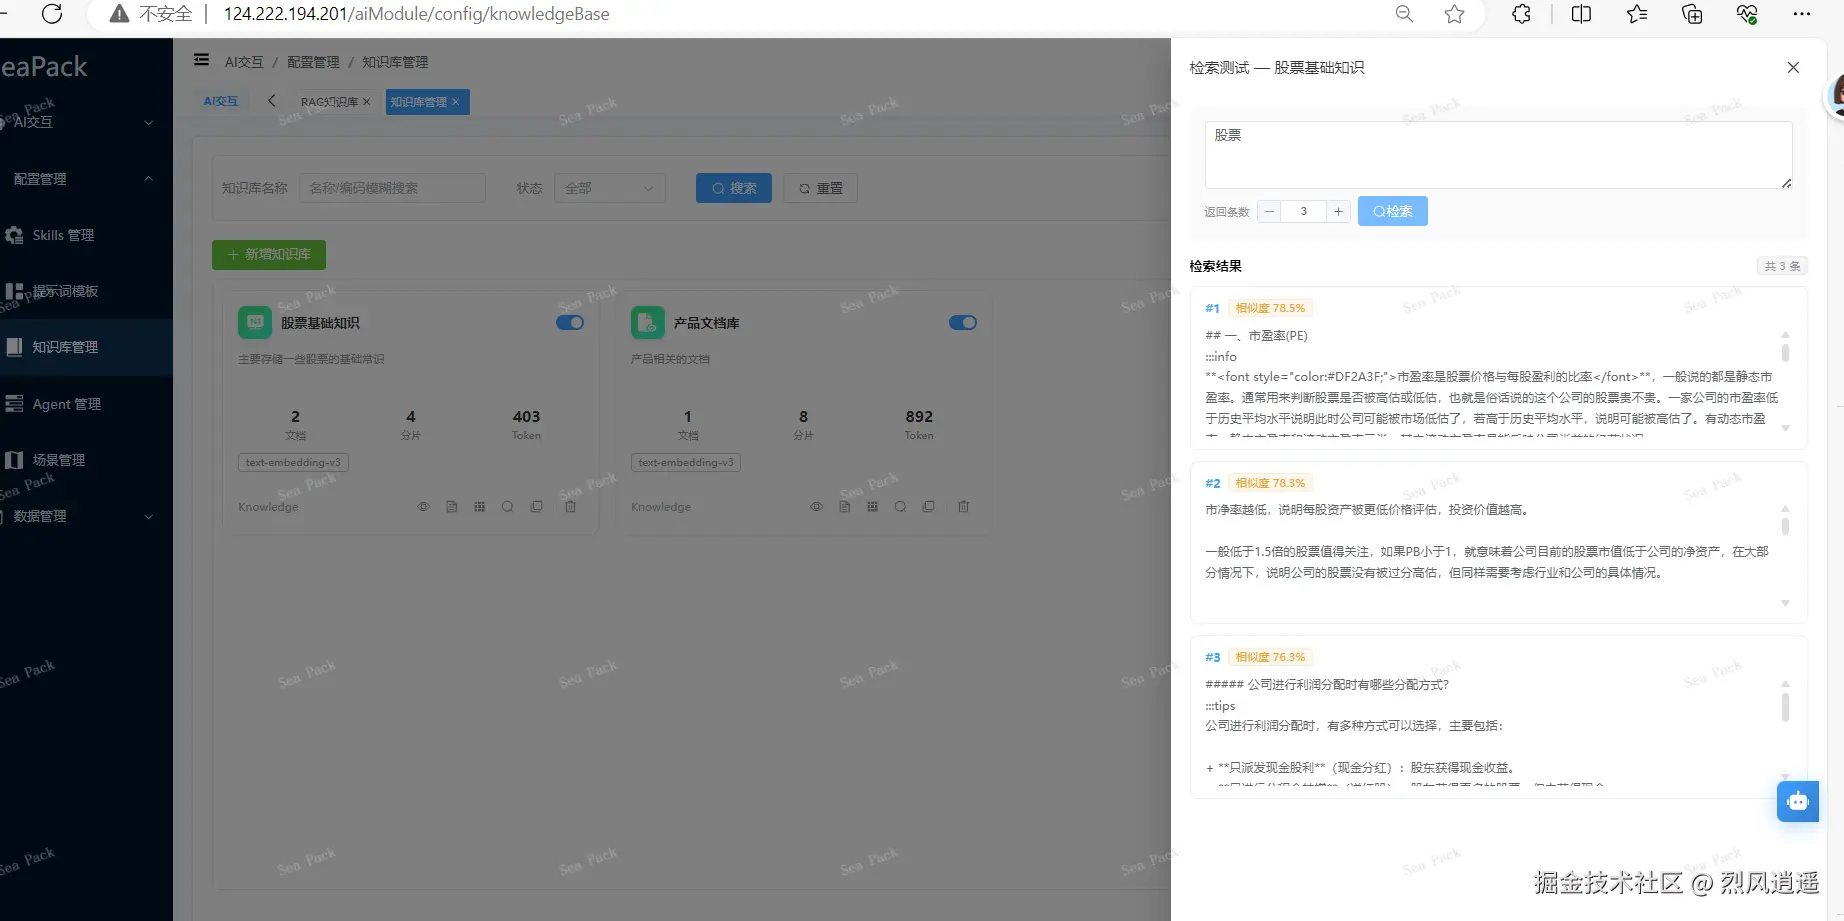
检索测试抽屉(RetrievalTestDrawer.vue)提供即时的检索效果验证。用户输入查询文本和 topK 值后,调用后端的 retrieve 接口,返回的每个结果都带有相似度分数。分数用颜色标签区分:>= 0.8 为绿色(高度相关),>= 0.6 为橙色(中度相关),< 0.6 为灰色(低度相关)。这帮助管理员快速评估知识库的检索质量。
async function handleRetrieve() {
  results.value = await KnowledgeBaseAPI.retrieve(props.knowledgeId, {
    query: queryText.value,
    topK: topK.value,
  }) || []
}

// 相似度颜色规则
function getScoreType(score: number) {
  if (score >= 0.8) return 'success'   // 高度相关(绿色)
  if (score >= 0.6) return 'warning'   // 中度相关(橙色)
  return 'info'                         // 低度相关(灰色)
}
七、完整数据流时序图
以「前端驱动 RAG 对话」为例,下面的时序图展示了从用户输入到知识增强回复的完整链路。
整个过程分为两个阶段:
- 检索阶段(前端调后端 retrieve → 后端查 ChromaDB → 返回片段)和
- 对话阶段(前端注入 Prompt → 调 LLM → SSE 流式返回)。
两个阶段之间有一个"组装增强 Prompt"的动作——这是 RAG 和普通对话的分水岭。
用户                前端                    后端                     ChromaDB
 │                   │                       │                        │
 │  输入问题         │                       │                        │
 │──────────────────►│                       │                        │
 │                   │  POST /retrieve       │                        │
 │                   │  { query, topK: 5 }   │                        │
 │                   │──────────────────────►│                        │
 │                   │                       │  embed(query)          │
 │                   │                       │───────────────────────►│
 │                   │                       │  findRelevant()        │
 │                   │                       │◄───────────────────────│
 │                   │  RetrievalResult[]    │  [chunk1, chunk2, ...] │
 │                   │◄──────────────────────│                        │
 │                   │                       │                        │
 │                   │  构建增强 Prompt:      │                        │
 │                   │  system + 【参考知识】 │                        │
 │                   │                       │                        │
 │                   │  POST /dialog/stream  │                        │
 │                   │  { messages: [...] }  │                        │
 │                   │──────────────────────►│                        │
 │                   │                       │                        │
 │                   │  SSE: step_start      │                        │
 │                   │◄──────────────────────│                        │
 │                   │                       │  HttpURLConnection     │
 │                   │                       │  POST /ch@t/completions│
 │                   │                       │  (含知识库上下文)       │
 │                   │                       │                        │
 │                   │  SSE: content "你"    │                        │
 │                   │  SSE: content "好"    │                        │
 │                   │  SSE: content ","    │                        │
 │                   │  ...                  │                        │
 │  看到逐字输出     │                       │                        │
 │◄──────────────────│◄──────────────────────│                        │
 │                   │                       │                        │
 │                   │  SSE: done            │                        │
 │                   │  { tokens: {...} }    │                        │
 │                   │◄──────────────────────│                        │
 │  对话完成         │                       │                        │
 │◄──────────────────│                       │                        │
八、设计总结
8.1 向量模型与文本模型分离
通过 ai.embedding-provider 配置项,向量化可以使用与对话不同的模型提供商。比如对话用 mimo(快),向量化用 aliyun(精度高),实现成本和效果的平衡。这种分离让团队可以根据不同场景选择最优的模型组合。
8.2 检索降级保障可用性
ChromaDB 不可用时自动降级为 MySQL LIKE 匹配,虽然语义匹配效果差,但确保系统不会因向量数据库故障而完全不可用。降级分数按排名递减(1.0 - i * 0.1),让排序靠前的结果获得更高的相似度分数。
8.3 两条 RAG 路径互补
| 前端驱动(路径 A) | Agent 驱动(路径 B) | |
|---|---|---|
| 复杂度 | 低(直接调 retrieve API) | 高(四步流水线) |
| 灵活性 | 低(只能检索一个知识库) | 高(Agent 关联多个知识库) |
| 可观测性 | 低(无步骤追踪) | 高(SSE step 事件 + traceSnapshot) |
| 适用场景 | 简单的知识库问答 | 企业级 Agent(知识库 + 技能 + 模板) |
路径 A 适合快速验证和简单场景(如客服问答),路径 B 适合需要多知识库协同、技能调用、链路追踪等高级能力的企业级 Agent。
8.4 Collection 隔离策略
每个知识库一个独立的 ChromaDB Collection(knowledge_{id}),而非所有知识库共享一个 Collection。优势是数据天然隔离,删除知识库时直接删除 Collection 即可,不会影响其他知识库。同时,ChromaDB 在 Collection 级别就有物理隔离,检索时不需要额外的过滤条件。
8.5 元数据驱动的过滤
向量检索时传入 knowledgeId 元数据过滤,确保只在目标知识库中搜索。这比"所有知识库共享一个 Collection + 查询时过滤"更高效,因为 ChromaDB 在 Collection 级别就有物理隔离,减少了不必要的向量比较。
九、核心文件索引
下面是 RAG 知识库系统涉及的所有核心文件,按前后端和层级分类。前端主要负责知识库管理界面和 RAG 对话注入,后端负责向量化、检索和 Agent 流水线。
| 层级 | 文件 | 职责 |
|---|---|---|
| 前端 UI | ChatInterface.vue | 对话界面,前端 RAG 注入点 |
| 前端 API | knowledgeBase.ts | 知识库管理 + 检索接口 |
| 前端类型 | types/knowledgeBase.ts | KnowledgeBase/Chunk/RetrievalResult 类型定义 |
| 前端组件 | DocumentListDrawer.vue | 文档上传 + SSE 进度追踪 |
| 前端组件 | RetrievalTestDrawer.vue | 检索测试界面 |
| 后端 Controller | KnowledgeBaseController.java | REST 接口(CRUD + 检索) |
| 后端 Service | KnowledgeBaseService.java | 业务逻辑 + 检索降级 |
| 后端 Service | KnowledgeVectorService.java | 向量化入库 + 语义检索 + 向量删除 |
| 后端 Service | AgentTestChatService.java | Agent 四步流水线(含 RAG Step 2) |
| 后端 Service | ChromaRagService.java | ChromaDB RAG 工具类(ingestText / getRelevantContext) |
| 后端 Config | ChromaDbConfig.java | EmbeddingModel + EmbeddingStore 管理 |
| 后端 Config | ChromaDbProperties.java | ChromaDB 连接配置 |
| 后端 Config | AIProperties.java | AI 提供商配置(文本/向量模型分离) |
| 后端 Config | VectorProgressManager.java | SSE 进度推送管理器 |
其他系列文章:
第五篇:通用 LLM 流式对话:前后端联接的完整实现前言 访问地址:http://124.222.194.201/ 前 - 掘金 (juejin.cn)
第四篇:AI 模块架构设计:多 Provider 切换、RAG 知识库与 Agent 编排前言 访问地址:http:// - 掘金 (juejin.cn)
第三篇:组件化实践,SpTable 通用表格组件设计前言 访问地址:http://124.222.194.201/ 前端 - 掘金 (juejin.cn)
第二篇:SeaPack 权限体系:从"谁都能看"到"该看什么看什么"写在前面 上一篇聊了项目初始化和工程规范,这篇来聊一 - 掘金 (juejin.cn)
第一篇:SeaPack 全栈项目工程化实践写在前面 这篇文章是 SeaPack 项目技术系列的第一篇。在写代码之前,我想 - 掘金 (juejin.cn)