RAG 重排序优化:如何把检索准确率从 70% 提升至 90%
在知识库问答中,一个容易被忽略的问题是:正确文档已经进入候选集,却因为排名靠后而被相似但无关的内容压住。单纯依赖向量相似度很难彻底解决这种错序现象,因此需要在粗排之后加入 Rerank 精排。下面从模型结构、评测指标、代码接入和延迟成本几个方面梳理这条优化链路。
前面写过 RAG 的向量库选型、效果评估、分块策略、数据更新。这几篇解决的都是「召回端」的问题:怎么切、怎么存、怎么更新。
但实际跑下来会发现一个更细的问题:该召回的内容召回了,可它没排在前面。
这篇讲排序端:Rerank(重排序)怎么接、能提多少、代价是什么。
一、问题:召回到了,却排错了位置
先说一个常见现象。
知识库里明明有正确答案,用户提问后,那段内容也确实进了 top-5,但模型给出的回答还是不对。
原因往往在被召回的 5 条里:正确答案排在第 4、第 5 位,而前面几条是「看起来很像」的干扰项。喂给大模型时,前面的干扰内容占了主导,答案自然跑偏。
向量检索的问题在于,它算的是「语义相似」,而语义相似和「真正能回答问题」之间,隔着一段距离。
举个典型的例子:知识库里同时有「退货政策」和「换货政策」两段。用户问「怎么退货」,两段在向量空间里非常接近,甚至换货那段相似度更高——它和退货的措辞、场景高度重合。但真正能回答问题的只有退货那段。
粗排阶段解决不了这个问题,因为它用的是双塔结构:query 和文档分别编码成向量,再算距离。两边在编码时互相看不到对方,只能比一个笼统的「语义接近程度」。
二、Rerank 是什么:两阶段的第二段
解法是加一个精排阶段,业内叫 Rerank。
核心区别在模型结构:
| 粗排(向量检索) | 精排(Rerank) | |
|---|---|---|
| 模型结构 | 双塔 Bi-Encoder | 交叉编码器 Cross-Encoder |
| 编码方式 | query 和文档分别编码 | query 和文档拼在一起编码 |
| 能否看到彼此 | 看不到 | 能看到 |
| 计算量 | 低(向量可预计算) | 高(每条候选都要跑一次模型) |
| 精度 | 一般 | 高 |
交叉编码器把 query 和文档拼成一句话一起送进模型,让它们在注意力层里直接交互。query 里的「退货」和文档里的「退货」能对上,「换货」的干扰会被压下去。
代价也很直接:不能预计算。 每条候选都要现场跑一次模型,所以它不能替代向量检索,只能做第二阶段。
于是整体架构变成两段:
用户提问
   │
   ▼
向量检索(粗排)──→ 召回 top-50 候选
   │
   ▼
Rerank(精排)──→ 从 50 条里挑出真正相关的 top-5
   │
   ▼
喂给大模型生成回答
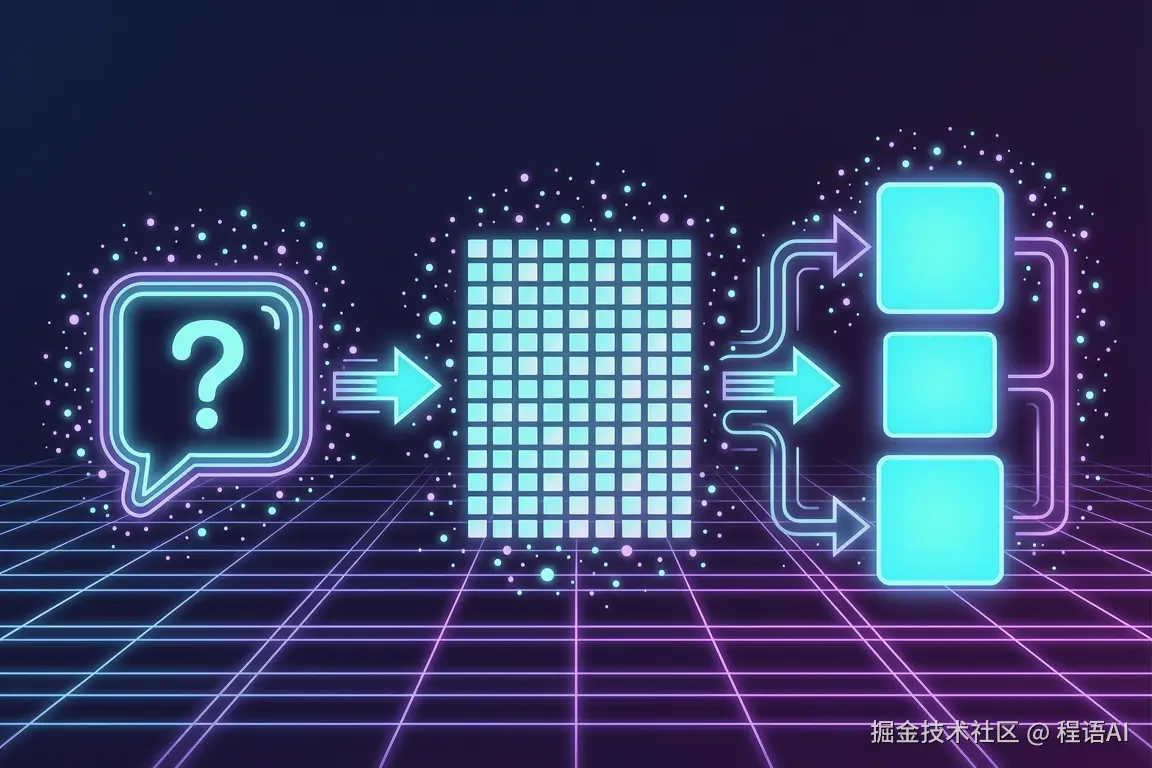
关键设计是**「多召回、再精排」**:粗排阶段故意放宽,召回几十条不嫌多,把压力交给精排去筛。如果粗排只召回 5 条就交给 Rerank,正确答案很可能压根没进来,后面再准也没用。
三、实测:加 Rerank 前后差多少
3.1 评测口径
沿用之前分块那篇的评测方法,再加一个更严的指标:
- recall@5:标准答案所在的文档有没有进前 5(宽松,看召回能力)
- top-1 准确率:排名第 1 的是不是标准答案(严格,看排序质量)
测试集:中文企业文档约 1000 篇,50 个真实问题,人工标注标准答案。
3.2 结果
只用向量检索(baseline):
- recall@5:0.79
- top-1 准确率:0.58
加上 Rerank(召回 50 条 → 精排取 5 条):
- recall@5:0.89
- top-1 准确率:0.81
两个指标的变化很说明问题:
- recall@5 提升 10 个百分点——粗排放宽到 50 条本来就能捞更多,Rerank 再把真正相关的挑进前 5
- top-1 准确率提升 23 个百分点(0.58 → 0.81)——这才是 Rerank 最大的价值。它不只是「让答案进前 5」,而是「让答案排到第 1」
而 top-1 恰恰是决定生成质量的关键位。很多 RAG 效果不稳定的问题,本质是「答案在,但没排在前面」。
3.3 召回数量怎么定
Rerank 的输入候选数(recall_k)直接影响效果和耗时。实测下来的经验值:
| recall_k | recall@5 | 单次耗时 | 说明 |
|---|---|---|---|
| 10 | 0.84 | 低 | 召回不够,部分答案进不来 |
| 20 | 0.87 | 中 | 性价比开始显现 |
| 50 | 0.89 | 中高 | 甜点区 |
| 100 | 0.89 | 高 | 精度不再提升,耗时翻倍 |
50 是个比较稳的默认值。继续往上加,召回池里已经没有更多有效信息了,纯粹是浪费时间。
四、怎么接:代码
用开源的 bge-reranker 系列做演示,本地部署,不依赖外部 API。
from sentence_transformers import CrossEncoder

# 加载交叉编码器(首次运行会下载模型)
reranker = CrossEncoder("BAAI/bge-reranker-v2-m3", max_length=512)

def search_with_rerank(query: str, top_k: int = 5, recall_k: int = 50):
    # 第一阶段:向量粗排,放宽召回
    candidates = vector_search(query, k=recall_k)

    # 第二阶段:构造 (query, doc) 对,交给交叉编码器打分
    pairs = [(query, c.page_content) for c in candidates]
    scores = reranker.predict(pairs)

    # 按分数重排,取最终 top_k
    ranked = sorted(zip(candidates, scores), key=lambda x: x[1], reverse=True)
    return [c for c, _ in ranked[:top_k]]
对应的评测脚本:
def evaluate(queries, gold_map, use_rerank: bool):
    """queries: [(query, gold_doc_id), ...]"""
    hits = 0
    for q, gold_id in queries:
        results = (
            search_with_rerank(q, top_k=5)
            if use_rerank
            else [c for c in vector_search(q, k=5)]
        )
        if results and results[0].metadata["doc_id"] == gold_id:
            hits += 1
    return hits / len(queries)
两个实现细节值得注意:
max_length参数:bge-reranker-v2-m3 默认 512,如果你的分块很长、关键信息在尾部,需要调大;代价是耗时上升- 批量推理:
predict支持传入列表,一次算完所有候选,比循环单条调用快得多
五、代价:延迟和成本
Rerank 不是免费的午餐,主要成本是延迟。
实测量级(50 条候选、单次查询):
| 部署方式 | 单次 Rerank 耗时 |
|---|---|
| 本地 GPU | 约 50-120 ms |
| 本地 CPU | 约 300-800 ms |
| 云端 API | 约 100-300 ms(含网络) |
对大多数问答场景,几百毫秒的额外延迟是可以接受的——用户等待对话回复的容忍度本来就比搜索高。
但如果你的场景对延迟极其敏感(比如需要流式首字秒出),就要权衡了。几个常用的优化手段:
- 减少候选数:recall_k 从 50 降到 20,耗时显著下降,精度只掉 2 个百分点左右
- 短路逻辑:粗排 top-1 的相似度明显高于其他候选时(比如高出 0.1 以上),直接跳过 Rerank
- 异步预热:服务启动时把模型加载进内存,避免首次请求加载模型造成秒级延迟
另外,小知识库不一定需要 Rerank。文档总量只有几百篇时,粗排的干扰项本来就不多,加一层的收益有限。Rerank 的价值随知识库规模上升而放大。
六、几个踩坑提醒
1. 召回数量给够,不要省
最常见的错误:粗排 top-5 直接接 Rerank。这样 Rerank 只能在这 5 条里挑,正确答案没进来就永远救不回来。Rerank 的前提是「候选池里得有正确答案」,所以粗排阶段要故意放宽。
2. 别只调 Rerank,忽略分块
如果分块本身有问题(关键句被拦腰切断、一块塞多个话题),Rerank 也救不回来——它只能对「已经存在的候选」排序。分块是地基,Rerank 是装修,顺序不能颠倒。
3. Rerank 模型也有领域差异
通用中文 reranker 在标准问答上表现不错,但在强领域场景(法律条款、医疗术语、专业型号)可能力不从心。有条件的话,用自己业务的 query-doc 对做一轮小规模微调,效果提升明显。
4. 评测集要覆盖「容易混淆」的问题
只测那些「答案唯一、措辞明显」的问题,测不出 Rerank 的价值。真正该放进评测集的是近似干扰类问题——比如同时存在「退货」和「换货」两段文档的那种。这类问题才是 Rerank 的主战场。
总结
- 问题定位:向量检索算的是语义相似,语义相似和「能回答问题」之间还有距离,导致答案在候选里却排不到前面
- 解法:加一层交叉编码器做精排,两阶段架构 = 粗排召回 50 条 + 精排取 5 条
- 效果:实测 top-1 准确率从 0.58 提到 0.81,这是排序正确的关键位;recall@5 从 0.79 到 0.89
- 代价:单次查询增加约 50-800 ms(取决于部署方式),小知识库收益有限,规模越大收益越明显
- 顺序:先解决分块和召回,再上 Rerank。地基没打好,装修没用
召回决定「有没有」,排序决定「准不准」。两件事都做对,RAG 才算跑顺。
你们的 RAG 链路里加了 Rerank 吗?召回数量和延迟是怎么权衡的?评论区交流。
相关文章
-
使用5S Code+phpstudy实现PHP环境配置指南
游戏攻略 2026-09-21
-
vscode运行php报错php not found解决办法
游戏攻略 2026-09-21
-
从 Agent Loop 迈向可恢复 Runtime:LangGraph、PostgreSQL Checkpoint 与 AG-UI 实战
游戏攻略 2026-09-21
-
phpstudy本地环境搭建超详细图文教程
游戏攻略 2026-09-21
-
AI Coding 接入企业内网:从浏览器 Token 过渡到官方 MCP 的权限治理
游戏攻略 2026-09-21
-
把MCP看作AI时代的USB-C:开发者为何都在讨论它
游戏攻略 2026-09-21