Muse Spark 谁开发的?Meta MSL 团队与模型参数说明
Muse Spark 是 Meta 旗下 Meta Superintelligence Labs 开发的大模型,不是同名第三方工具,也不是由独立创业公司推出。它在 2026 年 4 月 8 日首次发布,是 Muse 模型家族的首个成员,并逐步成为 Meta AI、Muse Code 和 Meta Model API 背后的核心推理模型。需要提前说明的是:官方公开了上下文窗口、输入类型和接口规格,但没有公布 Muse Spark 的总参数量。
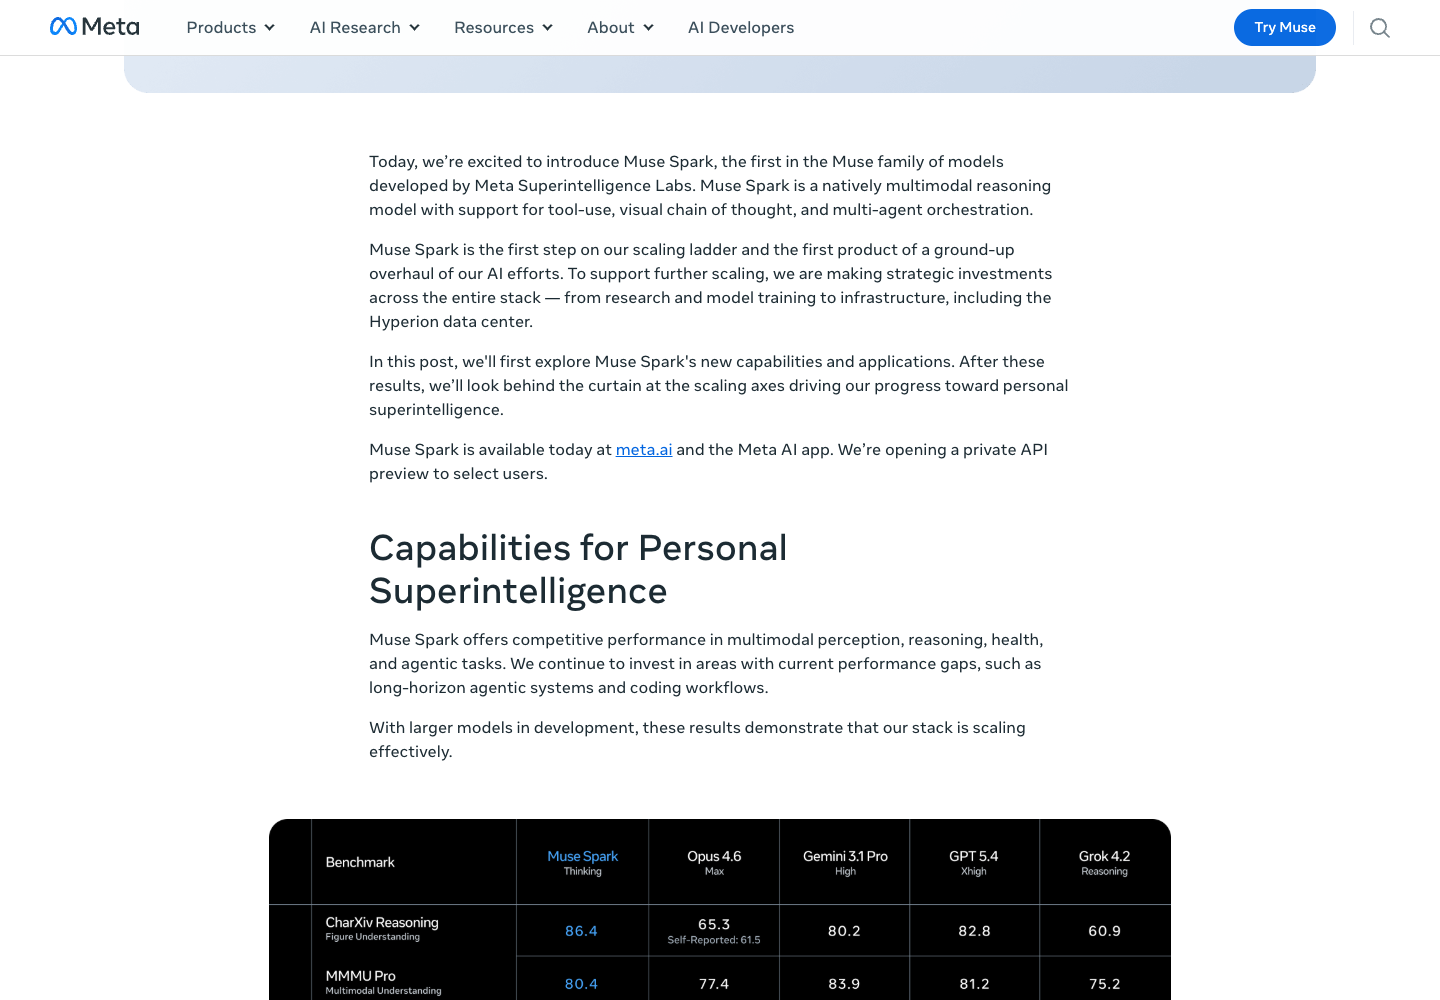
图:Meta 官方发布页明确写明 Muse Spark 由 Meta Superintelligence Labs 开发,并将其描述为 Muse 家族的首个模型。截图于 2026 年 9 月 23 日获取,来源:Meta 官方发布页。
Muse Spark 背后是哪家公司?
答案是 Meta。更准确地说,负责模型研发的是 Meta Superintelligence Labs,常缩写为 MSL。官方在首发公告中把 Muse Spark 定义为“Muse 家族的第一个模型”,并表示它是公司重建 AI 技术体系后的首项模型成果。
这个归属关系能够拆成三层理解:
| 层级 | 名称 | 作用 |
|---|---|---|
| 公司 | Meta | 提供研发组织、算力基础设施和产品分发渠道 |
| 研发团队 | Meta Superintelligence Labs | 负责 Muse Spark 的模型训练、评测与迭代 |
| 模型家族 | Muse | 包含 Muse Spark、Muse Image、Muse Voice Transcribe、Muse Glimmer 等不同用途的模型 |
所以,“Meta Muse”“Meta Spark”和“MUSE AI 大模型”虽然常被当作搜索名称使用,但官方模型名是 Muse Spark。判断页面是否可靠时,应优先核对 ai.meta.com、research.meta.ai 或 dev.meta.ai 域名,以及模型 ID 是否与官方文档一致。
Muse Spark 在 Meta AI 体系中处于什么位置?
Muse Spark 是模型,Meta AI 是面向普通用户的助手产品,两者不是同一个概念。用户在网页端或应用端发出请求时,界面负责账户、会话与功能呈现,Muse Spark 则在后台承担理解、推理和工具调用等工作。
Muse Code 又是另一层产品。它是面向开发者的终端智能执行工具,使用 Muse Spark 完成代码库分析、文件修改、命令执行和结果检查。Meta Model API 则把模型能力开放给开发者,让第三方应用能够通过接口调用 Muse Spark。
2026 年 9 月发布的 Muse 是个人智能执行产品,名称与模型家族相近,但也不能直接等同于 Muse Spark。能够把它们理解为“模型能力”和“使用模型的产品”之间的关系:Muse Spark 提供底层推理,Meta AI、Muse 和 Muse Code 负责把能力组织成不同使用体验。
Meta 为什么要推出新的 Muse 系列?
Meta 在首发资料中表示,团队用了约九个月重建预训练、强化学习与推理阶段的技术体系。Muse Spark 并不是简单改名的 Llama 版本,而是这套新体系的首个公开成果。
官方重点强调了三条扩展路线:
- 预训练效率:改进模型结构、优化方法和数据整理方式,让同等训练算力产生更多能力。
- 强化学习规模:通过更稳定的训练过程提升复杂任务成功率,同时保持不同推理路径的多样性。
- 推理阶段扩展:在需要时增加思考资源,并通过多个智能体并行工作控制等待时间。
这套路线也解释了 Muse Spark 的产品取向。它不是只追求单轮问答分数,而是特别强调多模态输入、工具使用、长流程任务和多智能体协作。Meta 还把自研芯片、数据中心和全球服务基础设施列为模型持续扩展的支撑条件。
Muse Spark 到底有多大?
截至 2026 年 9 月 23 日,Meta 没有公布 Muse Spark、1.1、1.2 或 1.3 的总参数量,也没有披露激活参数量、层数、专家数量或完整模型结构。官方首发文章曾称基础版本“small and fast by design”,但这是产品定位描述,不能换算成具体参数数字。
所以,下面几类说法都缺少官方依据:
- 把 Muse Spark 直接写成 30B、70B 或其他固定规模;
- 根据接口价格倒推总参数量;
- 把上下文窗口当成模型参数量;
- 用 Muse Glimmer 的规模代替 Muse Spark 的规模。
参数量没有公开,不代表模型没有可核验的技术规格。官方 Model API 文档已经给出当前版本、上下文长度、输入输出类型和服务档位,这些信息对具体接入更有直接价值。
已公开的 Muse Spark 参数
| 参数项 | 公开信息 |
|---|---|
| 当前推荐版本 | muse-spark-1.3 |
| 保留版本 | muse-spark-1.2、muse-spark-1.1 |
| 上下文窗口 | 1,048,576 tokens |
| 最大输出 | 官方快速入门配置标注 131,072 tokens |
| 输入类型 | 文本、图片、视频、音频、PDF |
| 输出类型 | 文本 |
| 推理强度 | 从 minimal 到 max 的多个档位 |
| 接口形式 | Responses、Chat Completions、Messages |
| 总参数量 | 未公开 |
| 权重状态 | Muse Spark 权重尚未正式发布,当前以托管服务为主 |
Muse Spark 1.1、1.2 和 1.3 使用相同的 1,048,576 tokens 上下文窗口,主要差别在能力和训练重点。1.1 扩展工具调用、计算机操作和多模态能力;1.2 更偏向编程与长流程开发;1.3 加强持续协作、指令保持和工具效率,并成为官方文档推荐的新项目版本。
Muse Spark 30B 的说法从哪里来?
常见误会来自 Muse Glimmer 30B。Muse Glimmer 是 Meta 在 2026 年 8 月发布的开放权重模型,官方模型卡明确标注其规模为 300 亿参数,并说明它由 Muse Spark 蒸馏而来,适合在本地设备上运行智能执行任务。
“由 Muse Spark 蒸馏”不代表两个模型大小相同。蒸馏的目的正是把较强模型的部分行为和能力迁移到更小的模型中。Muse Glimmer 30B 能够证明 Meta 已公开一个 300 亿参数的 Muse 家族成员,却不能证明 Muse Spark 也是 300 亿参数。
同样,网上出现的社区蒸馏版本、微调版本或名称中带有 Spark 的模型,也不能当作官方 Muse Spark 权重。核对时应查看发布账户、模型卡作者、许可证和官方页面是否互相链接。
参数量不公开,应该怎样判断模型实力?
对于只能通过云端接口使用的模型,参数量已经不是评估价值的唯一指标。更实用的判断方式包括:
- 用自己的真实任务测试一次完成率,而不是只看公开榜单;
- 记录完成同一任务所需的工具调用次数、tokens 与等待时间;
- 检查长文档后半部分的信息能否被稳定引用;
- 测试图片、视频和 PDF 输入是否能转化为可用结果;
- 观察模型在条件不足时会不会询问,而不是自行补全事实;
- 对比不同推理档位的质量提升是否值得额外成本。
官方披露的 1M 上下文和多模态输入说明了模型能接收什么,公开评测说明了训练方向,但只有具体业务测试才能回答它是否适合某个项目。参数越多也不必然意味着延迟更低、工具调用更稳定或具体费用更合适。
Muse Spark 的公司归属没有疑问:它来自 Meta,由 Meta Superintelligence Labs 研发。当前能够确认的是模型版本、1,048,576 tokens 上下文、多模态输入和面向智能执行任务的定位;不能确认的是总参数量与完整结构。遇到具体规模数字时,若页面没有指向 Meta 的模型文档或评测报告,就应将其视为未经证实的信息。
相关文章
-
Ruby实现二分搜索(二分查找)算法的简单示例
游戏攻略 2026-09-24
-
Muse Spark 1.2 Contributor 模型说明:价格、数据约定与用途
游戏攻略 2026-09-24
-
Muse Spark 2026 版本时间线与规格:1.1 至 1.3 能力梳理
游戏攻略 2026-09-24
-
Muse AI 官网入口与登录方法:账号设置及常见问题
游戏攻略 2026-09-24
-
Muse Spark 1.2 实测表现:基准数据、编程能力与版本选择
游戏攻略 2026-09-24
-
Muse Spark 1.1 API 费用解析:输入、输出与缓存计费
游戏攻略 2026-09-24