-
Code Agent 为什么会在文件编辑成功后仍然损坏内容?
AI头条 2026-09-16
-
Code Agent 的 apply_patch 工具为什么无法被部分 GPT 模型正确调用?
AI头条 2026-09-16
-
到 2030 年,大模型推理成本可能下降多少?
AI头条 2026-09-16
-
便宜大模型为何不一定降低任务的实际推理成本?
AI头条 2026-09-16
-
大模型推理成本下降,会怎样推动 AI 应用普及?
AI头条 2026-09-16
-
Code Agent 的文件编辑工具有哪些实现方式和可靠性差异?
AI头条 2026-09-16
-
硬件和推理软件如何让大模型 Token 成本持续降低?
AI头条 2026-09-16
-
Code Agent 的 patch 匹配失败后如何通过结构化错误反馈自动重试?
AI头条 2026-09-16
-
大模型推理成本为何快速下降,模型能力与 Token 价格如何变化?
AI头条 2026-09-16
-
LLM 生成的代码补丁如何通过编译验证检测幻觉?
AI头条 2026-09-16
-
Code Agent 如何防止编辑任务范围之外的文件?
AI头条 2026-09-16
-
Code Agent 的 edit_file 如何通过模糊匹配阶梯提高首次编辑成功率?
AI头条 2026-09-16
-
Text2SQL 的 SQL 安全检查:正则与 AST 如何选择
AI头条 2026-09-16
-
跨专业自学 AI Agent:从路线取舍到工具调用实践
AI头条 2026-09-16
-
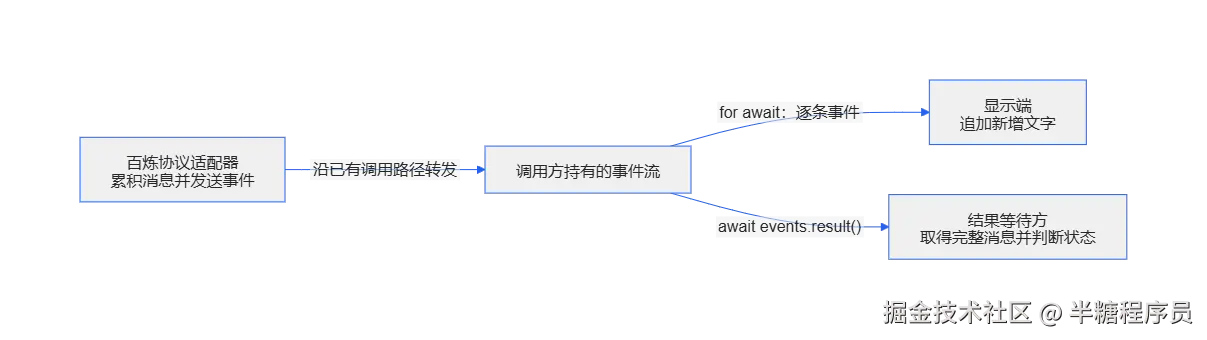
从零搭建 Agent(5):用一条事件流交付过程与最终结果
AI头条 2026-09-16
-
MCP 快速跑通不等于可上线:生产化必须避开的 5 个坑
AI头条 2026-09-16
-
Code Agent 的 exact、anchor、patch 和 LSP 编辑工具如何对比评测?
AI头条 2026-09-16
-
Code Agent 是否应在执行工具调用前校验 LLM 输出?
AI头条 2026-09-16
-
Code Agent 的模糊编辑工具如何返回匹配类型、置信度和实际命中文本?
AI头条 2026-09-16
-
Code Agent 如何用 generate-and-validate 流程判断自动生成的补丁是否正确?
AI头条 2026-09-16
-
MCP Server 的 Tools、Prompts 和 Resources 能否随时间动态变化?
AI头条 2026-09-16
-
lavandula:实践指南
AI头条 2026-09-16
-
Code Agent 的模糊匹配为什么可能让 edit 和 apply_patch 静默破坏文件?
AI头条 2026-09-16
-
Code Agent 的 Codex 风格 apply_patch 如何校验上下文并反馈解析失败?
AI头条 2026-09-16
-
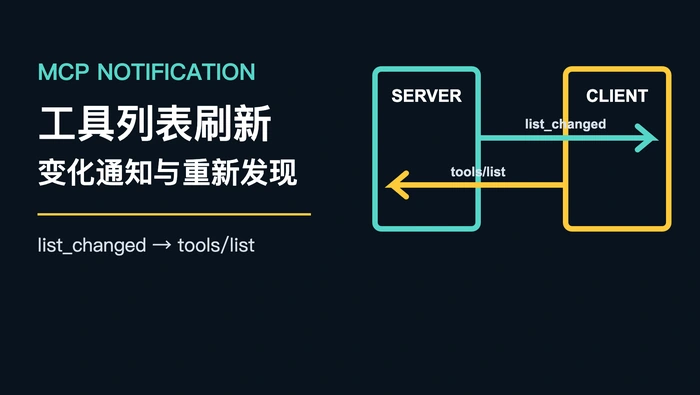
MCP Server 如何通过 notifications/tools/list_changed 通知客户端刷新工具列表?
AI头条 2026-09-16
-
Code Agent 的 edit_file 为什么要在原文本不存在或多次匹配时拒绝编辑?
AI头条 2026-09-16
-
Code Agent 使用 diff 补丁能否减少 LLM 编辑代码时的错误?
AI头条 2026-09-16
-
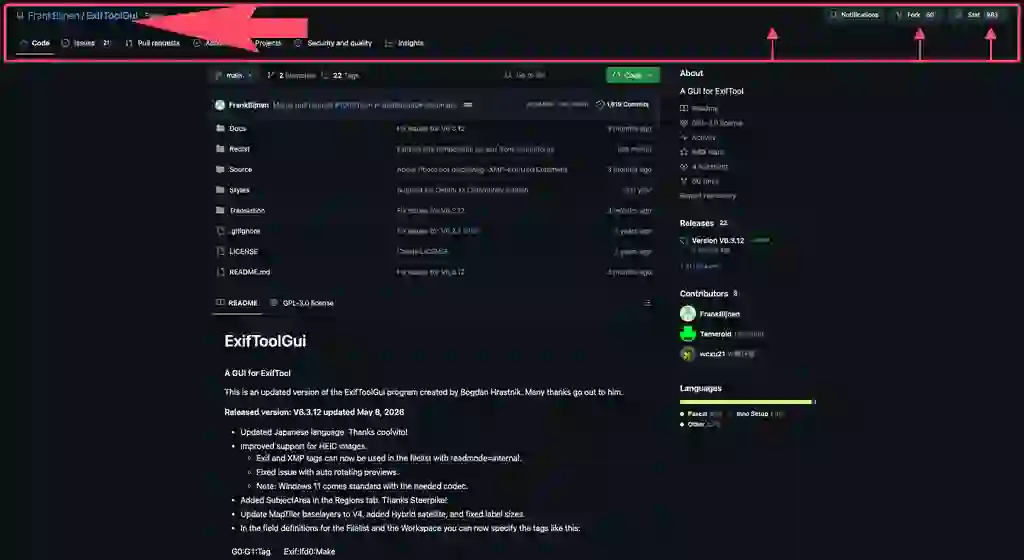
ExifToolGui:实践指南
AI头条 2026-09-16
-
Code Agent 如何用行号提示、模糊搜索和结构化诊断提升 edit 可靠性?
AI头条 2026-09-16
-
Code Agent 如何在生成阶段结合约束解码与模型编辑缓解代码幻觉?
AI头条 2026-09-16
-
Code Agent 如何在生成补丁后加入形式化验证与候选补丁筛选?
AI头条 2026-09-16
-
Code Agent 应如何选择 whole、diff 和 SEARCH/REPLACE 编辑格式?
AI头条 2026-09-16
-
Code Agent 的补丁为什么会局部有效却在全局上不一致?
AI头条 2026-09-16
-
libfsm:实践指南
AI头条 2026-09-16
-
Code Agent 如何使用静态分析检查 LLM 生成的错误 API 迁移代码?
AI头条 2026-09-16
-
ha-wyzeapi:实践指南
AI头条 2026-09-16
-
basecs-series:实践指南
AI头条 2026-09-16
-
cpr-compress-preserve-resume:AI Agent 工具实践指南
AI头条 2026-09-16
-
awesome-crypto:实践指南
AI头条 2026-09-16
-
AdClose:实践指南
AI头条 2026-09-16
-
从聊天入口到知识闭环:AI 客服工作流如何落地
AI头条 2026-09-15
-
借助 AI 拆解真实需求:把模糊描述转成开发任务清单
AI头条 2026-09-15
-
LangGraph.js 入门实战:用图结构编排 Agent 工作流
AI头条 2026-09-15
-
Agent 记忆架构拆解:实时存储、被动压缩与主动整理
AI头条 2026-09-15
-
用 Flutter 接入本地大模型:实现自然语言记账
AI头条 2026-09-15
-
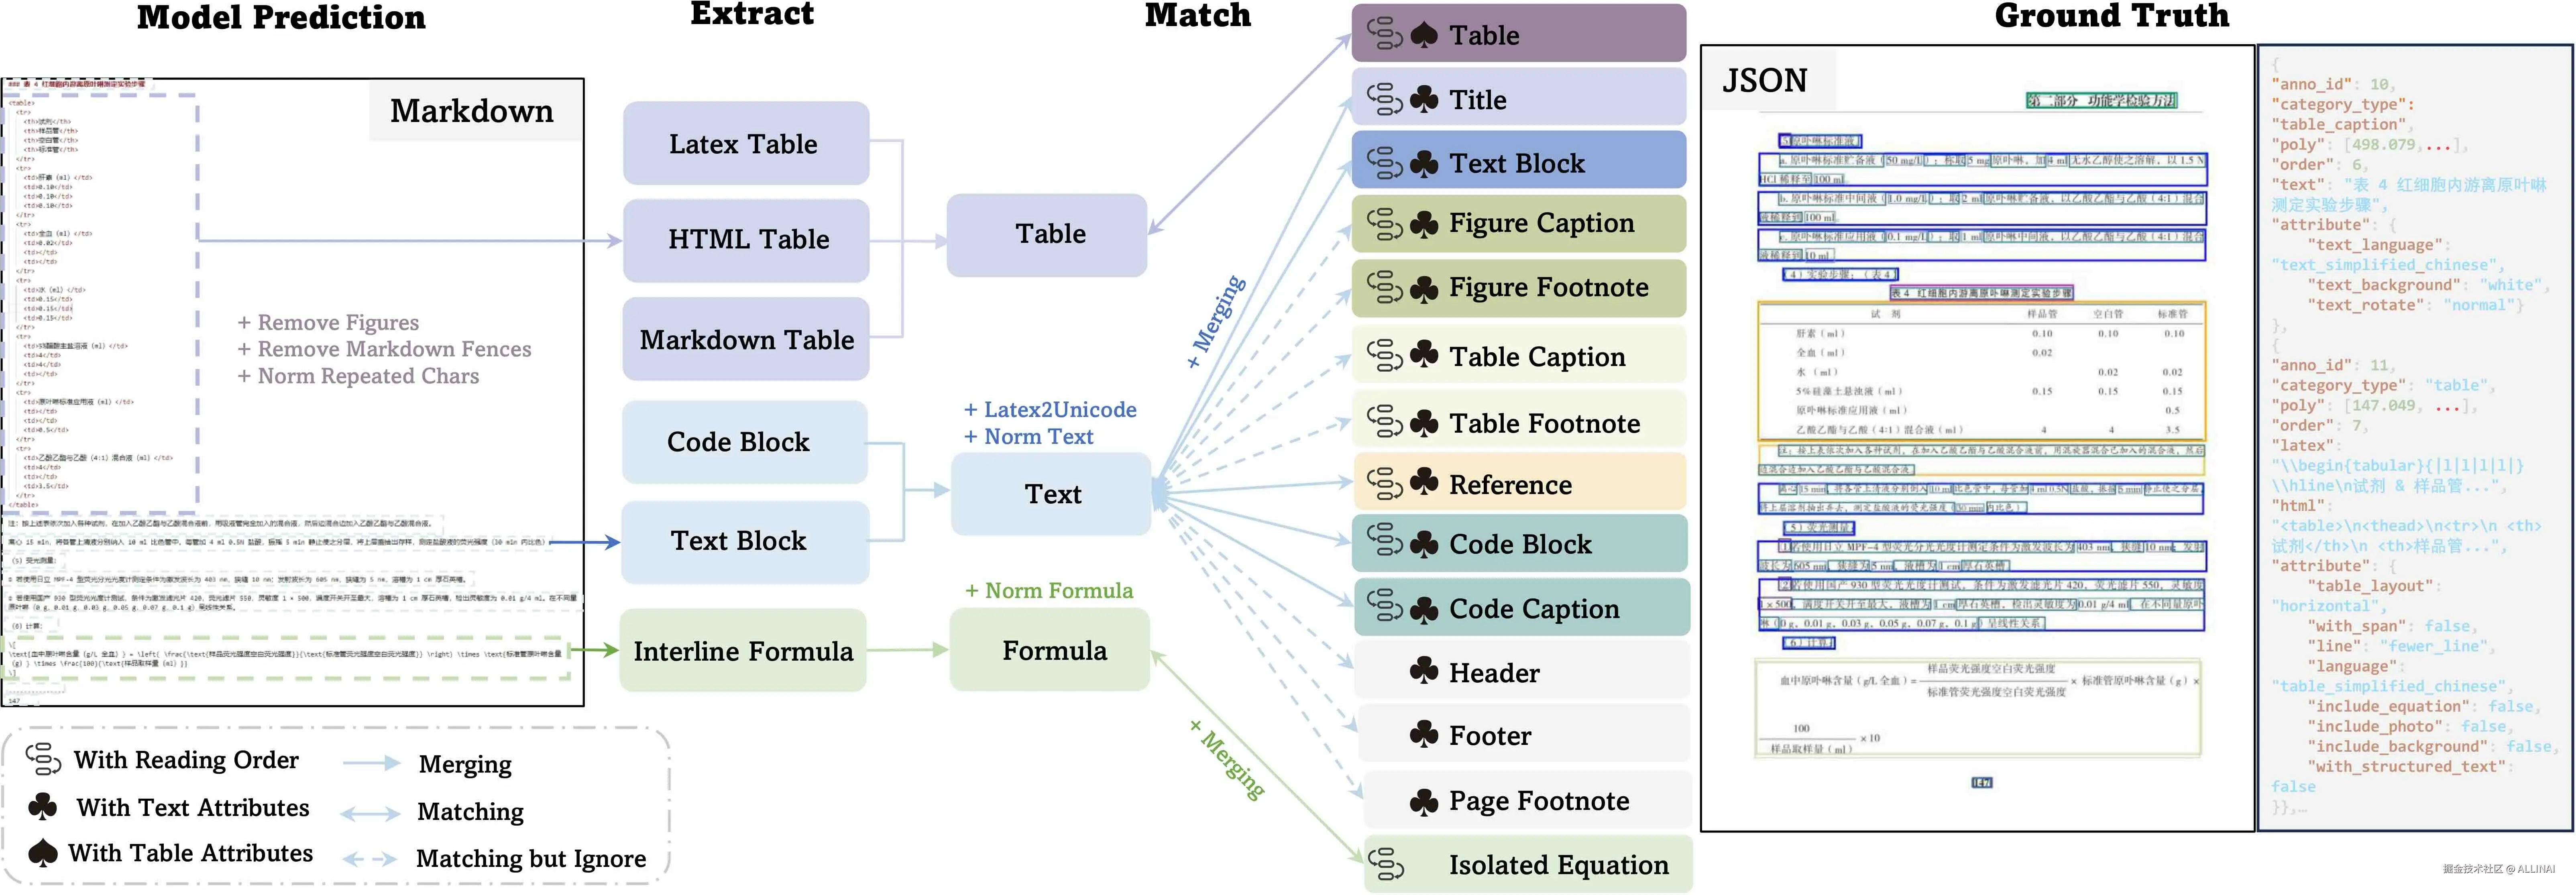
拆解 OmniDocBench:评测机制与开源、闭源 OCR 模型接入实战
AI头条 2026-09-15
-
AI 结构化输出的标准解法:从 tool call 到 withStructuredOutput
AI头条 2026-09-15
-
不懂ERP实施,谈FDE落地为何容易失真
AI头条 2026-09-15
-
使用 OpenAI Realtime API 构建实时语音对话应用
AI头条 2026-09-15
-
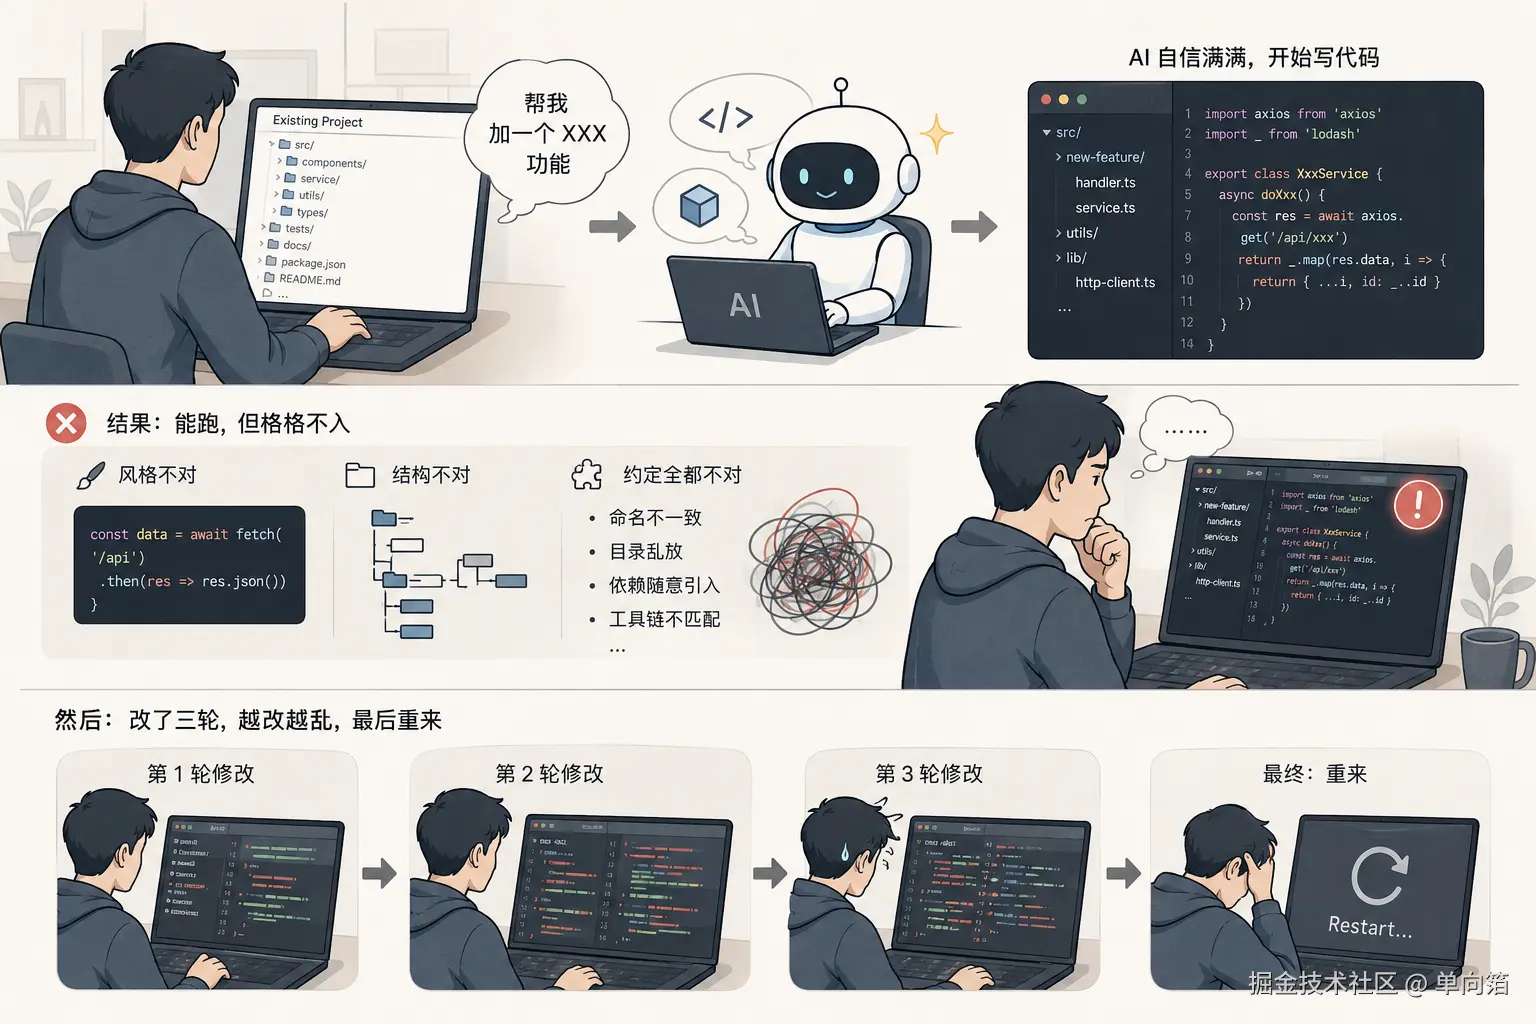
旧项目冷启动:如何让 AI 迅速读懂代码库
AI头条 2026-09-15